Vous tapez une invite, Codex envoie cinq lignes de Python cassé, et soudain votre flux de travail quotidien est plus lent qu’il y a un an. Si vous avez remarqué que Codex est devenu plus bête sur les tâches qu’il réussissait auparavant, comme écrire des scripts basiques ou corriger des bugs simples, vous n’êtes pas seul. Les plaintes concernant la baisse des performances du codex et la baisse de la qualité du codage sont partout, mais personne ne donne de réponse claire sur ce qui a réellement changé.
Certains disent que c’est juste votre imagination, ou que les prompts sont devenus plus bâclés, mais cela ne correspond pas au schéma. Les régressions reproductibles apparaissent même dans des bases de code bien documentées. Le risque n’est pas qu’une simple gêne mineure, si vous dépendez du Codex pour le code de production, même une petite baisse de précision des suggestions peut signifier des heures de débogage manuel ou des délais manqués.
La véritable histoire concerne moins la taille brute du modèle que les évolutions des données d’entraînement, des politiques d’alignement et la manière dont Codex est mis à jour en coulisses. Les changements destinés à rendre l’IA « plus sûre » ou plus générale suppriment souvent les cas particuliers qui rendaient Codex réellement utile pour les utilisateurs avancés. Si vous voyez des réponses plus génériques et moins utiles, ce n’est pas une idée, la régression du modèle est un problème réel et traçable pour les développeurs.
Alors, qu’est-ce qui cause réellement la perte de qualité, et que pouvez-vous faire à ce sujet ? C’est là que les problèmes commencent à apparaître.
Pourquoi tant d’utilisateurs disent-ils que Codex est devenu plus bête en 2026 ?
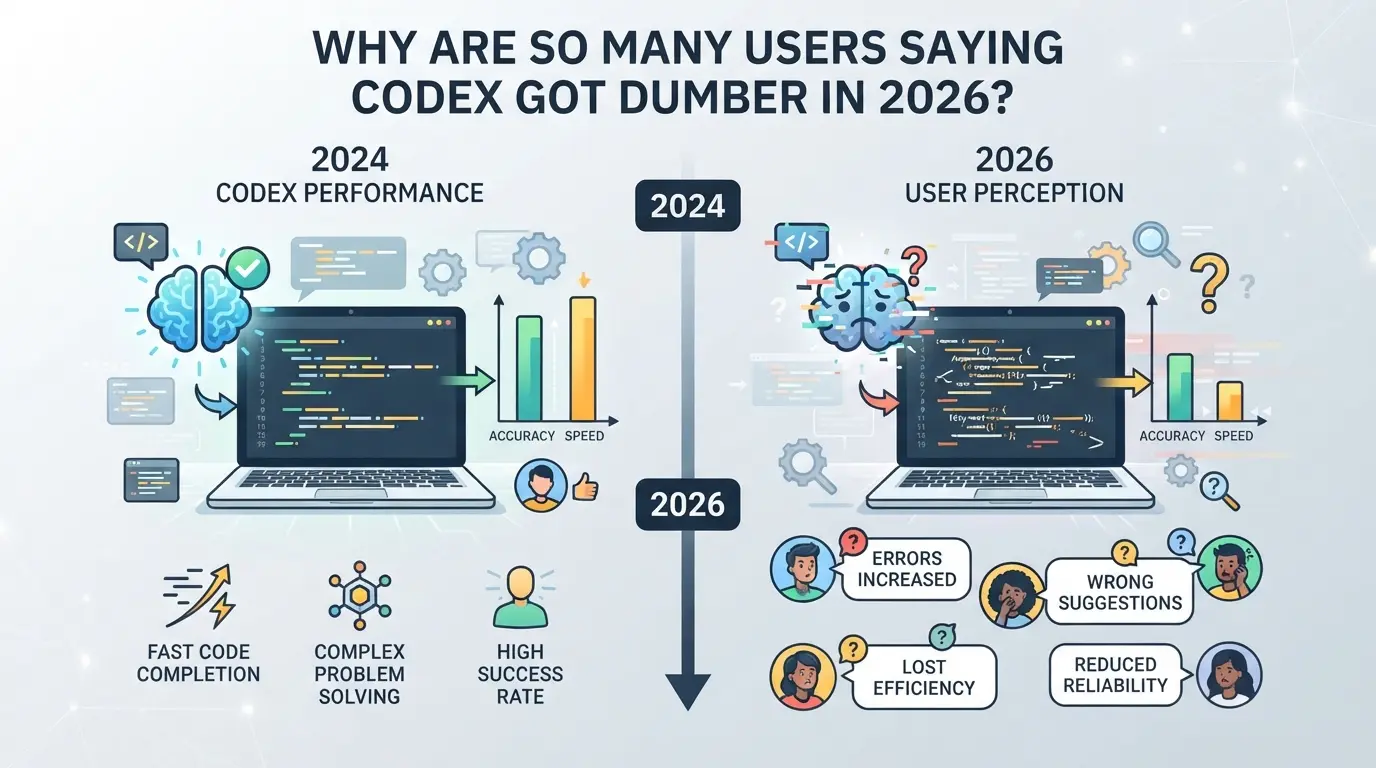
Les plaintes concernant la qualité du codage de Codex ne sont pas seulement plus fortes, elles viennent aussi de développeurs expérimentés qui se sont appuyés sur des suggestions précises et contextuelles. Les utilisateurs rapportent désormais des complétions plus génériques, du code hors sujet, et même d’anciens bugs corrigés dans des versions antérieures.
Plaintes courantes : Ce que les utilisateurs signalent
On fait remarquer que Codex oublie le contexte récent dans les projets multi-fichiers, nomme mal les variables et répète des blocs de code qui ne correspondent pas à l’invite. Des tâches simples comme les stubs d’API REST ou l’analyse de données reçoivent désormais des réponses standard au lieu de code fonctionnellement correct.
Déclencheurs possibles : mises à jour, changements de modèle ou variations d’utilisation ?
Cette baisse est liée aux principales mises à jour du Codex lancées fin 2025 et début 2026. Ces mises à jour visaient à prévenir les suggestions risquées et à élargir la base de code pour supporter plus de langages, mais elles ont aussi réduit les schémas de code de niche dont dépendaient les utilisateurs avancés. Lorsqu’une mise à jour du modèle abandonne le support de la logique des cas extrêmes, les tâches qui fonctionnaient bien l’an dernier reçoivent soudainement des réponses vagues ou incomplètes. Les développeurs qui utilisent Codex quotidiennement pour le prototypage rapide sont particulièrement frustrés : après une mise à jour, une tâche qui nécessitait auparavant deux prompts en a besoin de cinq ou six, si elle fonctionne du tout. Ajoutez un volume d’utilisateurs croissant et des politiques d’alignement plus strictes, et il n’est pas surprenant que les gens disent que Codex est devenu plus bête. Le point de douleur n’est pas seulement la perte de vitesse ; c’est l’érosion de la confiance dans le fait que l’outil « se souvienne » de votre fonctionnement au quotidien.
Séparer la perception de la réalité
- Si votre cas d’usage change (par exemple, des projets plus importants ou de nouveaux langages), un certain déclin est attendu.
- Les échanges communautaires, comme les discussions sur Reddit, peuvent faire paraître les régressions plus grandes qu’elles ne le sont.
- Quand on attend des résultats plus intelligents, même les petites erreurs paraissent pires ; la frustration s’accumule rapidement.
Ce qui compte maintenant, c’est d’apprendre à vérifier si votre flux de travail est réellement affecté, pas seulement en se fiant au bruit en ligne. C’est l’étape suivante.
Comment savoir si Codex fonctionne réellement moins bien pour vos tâches ?
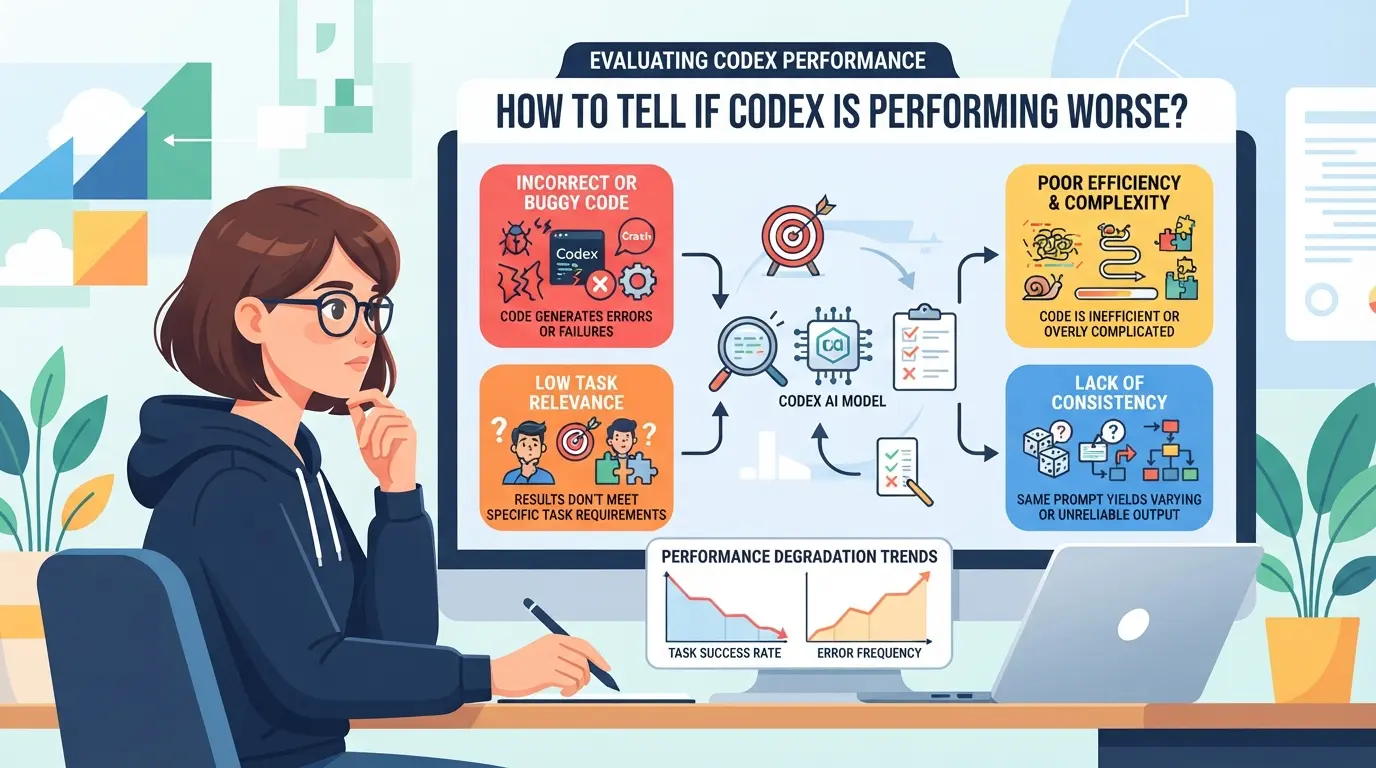
Si vous pensez que Codex empire, il vous faut des preuves, pas seulement un pressentiment. Beaucoup de développeurs se plaignent que « Codex est devenu plus bête », mais la plupart ne lancent jamais deux fois la même invite ni ne suivent ce qui a changé. Voici comment vérifier si l’outil est vraiment responsable de votre charge de travail de codage.
Mise en place de tests de code contrôlé
La seule façon de savoir si la qualité du Codex a chuté pour vos tâches est de faire des tests côte à côte. Choisissez un ensemble d’invites qui correspondent à votre travail quotidien, de vraies corrections de bugs, des refactorisations ou la génération de code standard. Intégrez ces éléments dans le Codex et, si possible, dans une version plus ancienne du Codex ou un modèle concurrent. Utilisez toujours le même contexte de code et les mêmes paramètres. Si vous ne gardez pas l’invite, la graine et l’environnement identiques, vous ne pouvez pas blâmer le Codex pour des différences aléatoires.
Suivi des schémas de régression au fil du temps
Si vous continuez à voir les mêmes échecs, il est temps de les enregistrer. La régression apparaît généralement comme des problèmes répétables, pas comme des erreurs aléatoires. Utilisez cette mini-liste de contrôle pour détecter de vrais refus :
- Sauvegardez toutes les échecs complétés avec l’horodatage et la version du Codex.
- Étiquetez chaque problème par langage, framework ou tâche (par exemple, API stub, cas de test).
- Comparez les nouvelles erreurs à vos anciens journaux, est-ce que ce bug exact est apparu le mois dernier ?
Quand blâmer le Codex vs. l’ingénierie des prompts
Il est facile de penser que Codex est cassé, alors qu’en réalité votre invite a changé ou que le contexte est devenu plus confus. Avant de blâmer le modèle, vérifiez ces pièges courants :
- Avez-vous ajouté, supprimé ou réarrangé des commentaires ou des blocs de code juste avant la demande ?
- Utilisez-vous maintenant un nouveau framework, une bibliothèque ou une syntaxe sur laquelle Codex n’a pas été entraîné ?
- Avez-vous raccourci votre invite ou sauté un exemple clé que le Codex avait vu auparavant ?
Si vous corrigez des erreurs d’invite et que les tests échouent quand même, vous voyez probablement une vraie régression du Codex. Sinon, le modèle répond probablement simplement à une demande plus floue.
L’étape suivante consiste à creuser ce qui cause ces régressions, mises à jour de modèles, changements de données, ou autre chose. C’est là que les vraies réponses commencent à apparaître.
Qu’est-ce qui rend les outils de codage par IA comme Codex plus stupides ?
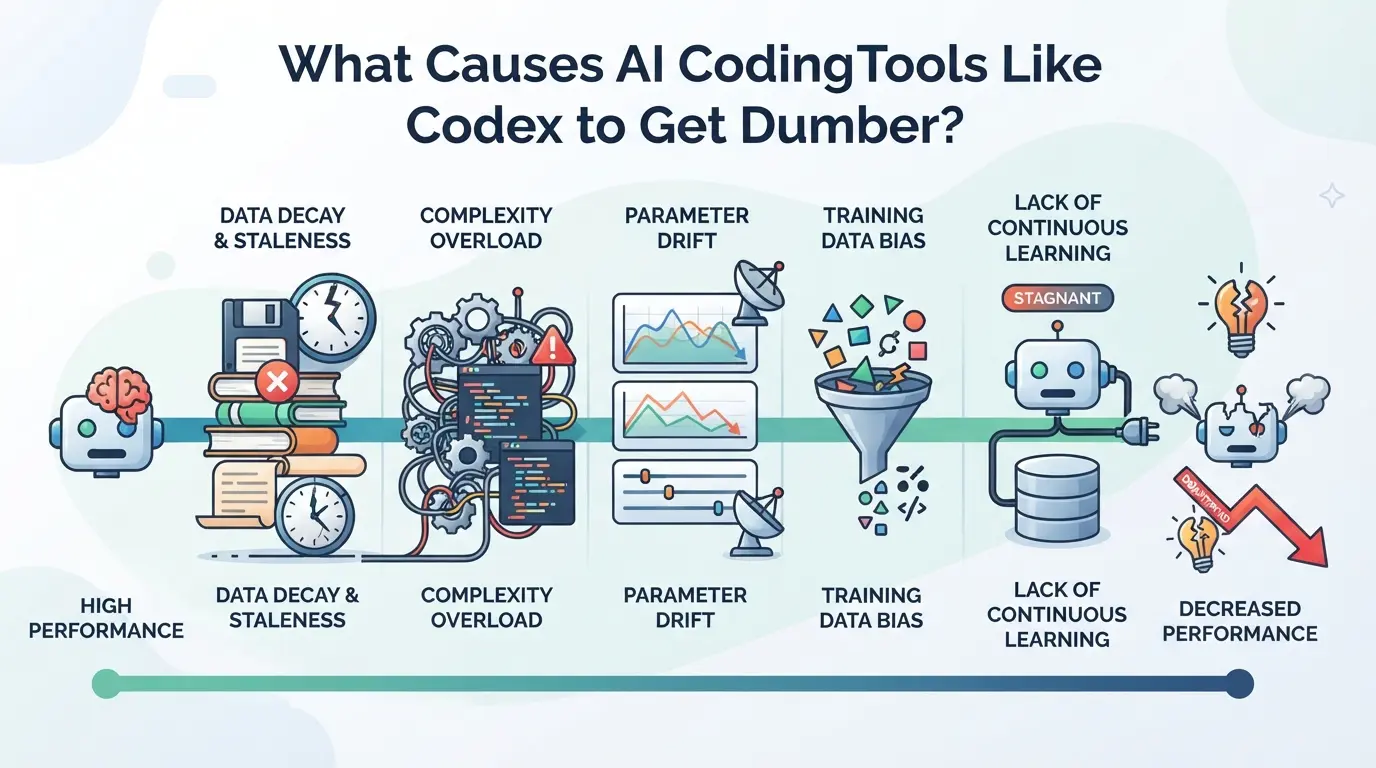
La plupart des baisses de qualité du Codex sont dues à des changements en coulisses, de nouvelles données, des règles plus strictes ou des raccourcis techniques. Ce n’est que rarement un bug unique. Si vous avez remarqué que Codex est devenu plus bête, vous voyez les effets secondaires de ces compromis.
Mises à jour de modèles et déplacements de données d’entraînement
Lorsque Codex est réentraîné avec des données nouvelles, le modèle peut perdre d’anciens motifs de niche qui le rendaient affûté dans les cas particuliers. Les efforts pour « améliorer la fiabilité » signifient souvent que le système moyenne désormais le code utilisateur diversifié, filtrant ainsi des solutions uniques ou ingénieuses. C’est pourquoi vos anciens prompts peuvent désormais devenir des réponses fades et génériques.
Décisions commerciales et politiques
Les outils d’IA ne sont pas seulement façonnés par des ingénieurs, ils sont aussi dirigés par des équipes de gestion des risques et de conformité business. Les mises à jour destinées à protéger Codex contre les plaintes liées au copyright ou au contenu offensant suppriment souvent des exemples entiers de code. Par exemple, si une entreprise renforce les filtres pour éviter les problèmes juridiques, vous recevrez soudainement plus de refus ou de conseils vagues au lieu de complétions directes de code. C’est encore plus probable si un incident très visible pousse l’entreprise à se concentrer sur tous les plans. Les compromis ici peuvent être durs : protéger la marque signifie parfois que le modèle passe sur des techniques de codage avancées mais sensibles. Les changements de ressources peuvent aussi nuire : si l’entreprise cesse de prioriser Codex, vous pourriez voir des corrections de bugs plus lentes ou moins d’investissement dans la qualité du modèle. Si votre outil de codage IA commence à éviter les questions auxquelles il répondait auparavant, c’est presque toujours le signe que les filtres de sécurité ou de politique viennent de devenir plus stricts.
Dettes techniques et défis d’échelle
- Retard d’infrastructure : Si les serveurs ne suivent pas, la latence augmente et les complétions de code sont tronquées ou supprimées.
- Raccourcis de mise à l’échelle : Une croissance rapide des utilisateurs peut contraindre l’équipe à réduire la taille du modèle ou à utiliser des versions plus légères.
- Test des lacunes : Les sorties précipitées sous forte scaling sautent souvent des vérifications de régression profondes, laissant passer de nouvelles erreurs.
Ces facteurs combinés expliquent non seulement pourquoi les performances du Codex chutent, mais aussi pourquoi les correctifs ne sont pas rapides ou prévisibles. Si vous voyez plus d’erreurs ou de code moins utile, c’est généralement parce qu’un changement en amont a changé, souvent pour des raisons extérieures à l’ingénierie pure.
Comment adapter votre flux de travail de codage lorsque la qualité du codex baisse
Si les performances du Codex chutent, affrontez-le de front : ajustez votre flux de travail pour ne pas perdre du temps ni livrer du code buggé. Les bons changements vous gardent productif, même lorsque les suggestions empirent.
Diversifier votre ensemble d’outils d’IA
- Essayez au moins un assistant de codage alternatif (comme Copilot, StarCoder, ou des modèles open source). Si Codex ne suffit pas, une comparaison directe est le moyen le plus rapide de voir si quelque chose d’autre fonctionne mieux pour votre stack.
- Combine des outils d’IA avec ton IDE ou linter standard. Ne change pas simplement d’outils, utilise les deux en parallèle. Cela t’aide à détecter les problèmes de style ou les logiques manquées que les sorties IA introduisent souvent.
- Documentez quel outil ou combinaison résout vos vrais problèmes de santé. Tenez un journal simple : « Copilot meilleur avec le refactoring, Codex meilleur avec les docstrings. » Cela vous empêche de passer d’un outil à l’autre sans plan.
- Surveillez les chutes soudaines dans n’importe quel outil. Le même cycle de mise à jour qui a empiré Codex pourrait toucher d’autres prochains, donc gardez les alternatives vérifiées et prêtes.
Amélioration de l’ingénierie rapide et des processus d’évaluation
- Quand Codex commence à manquer le sujet, réduisez vos instructions. Utilisez des signatures de fonctions spécifiques, donnez des cas de test et étalez des versions en langage, cela réduit le focus de l’IA.
- Vérifiez toujours le code généré avant de l’exécuter, surtout pour les cas limites. Si les suggestions de Codex fonctionnaient auparavant mais échouent maintenant aux tests, supposez que chaque sortie nécessite un examen plus attentif.
- Si vous continuez à obtenir du code faible ou mal visé, réécrivez votre invite et relancez-la. Un changement aussi petit que « utiliser la syntaxe Python 3.10 » peut forcer une meilleure réponse.
- Associez la relecture manuelle du code à la sortie IA. Même si la relecture vous ralentit, cela vous évite des heures perdues sur des erreurs logiques silencieuses.
Gestion des configurations multi-comptes ou multi-environnements
- Configurez des profils de navigateur ou des sandboxes séparés pour chaque outil IA ou compte Codex. Cela garde votre historique de travail et d’outils propre, donc si un outil régresse, il ne polluera pas les autres.
- Suivez quel environnement et quelle connexion ont produit chaque changement de code majeur. Si un bug apparaît, vous saurez quel outil l’a créé, pas seulement quelle ligne a cassé.
- Si vous remarquez un comportement étrange, comme du code qui compile mais échoue à l’exécution, vérifiez s’il provient d’un outil sous un compte différent. La contamination croisée est un vrai risque lors du changement d’outil.
- Faites pivoter les environnements si l’un d’eux commence à ralentir ou à provoquer des erreurs. Parfois, simplement passer à un nouveau profil corrige les sessions d’IA « bloquées » qui renvoient des suggestions répétées ou répétées.
Comment séparer en toute sécurité les environnements de codage et les comptes en utilisant plusieurs outils d’IA
Risques liés au mélange des comptes et des sessions
Mélanger des sessions de codage ou des comptes d’outils d’IA dans le même profil de navigateur peut divulguer des cookies, exposer des clés API ou déclencher des avertissements de plateforme. L’historique de connexion croisée est une raison fréquente pour laquelle les utilisateurs sont soudainement signalés ou limités par leur débit.
Meilleures pratiques pour l’isolement de l’environnement
Utilisez des profils de navigateur séparés, ou mieux, des navigateurs autonomes, pour chaque compte de codage ou outil. Attribuez un proxy unique à chaque profil si vous gérez des tâches sensibles ou spécifiques à une région. Cela évite que les données de session et les empreintes réseau ne se propagent d’un environnement à l’autre.
Quand envisager des outils avancés pour l’isolement
- Vous gérez 3+ outils d’IA ou plusieurs connexions utilisateur par jour
- Vous travaillez en équipe avec des appareils ou profils partagés
- Des blocages de plateformes ou des demandes de vérification répétées commencent à apparaître
Comment utiliser DICloak pour des environnements de codage isolés et la configuration de proxy
Si vous devez garder les sessions de codage ou les comptes de plateforme vraiment séparés, surtout après avoir remarqué des problèmes comme le codex devenu plus bête ou des baisses de qualité de l’IA spécifiques à la plateforme, DICloak offre aux équipes un moyen structuré d’isoler les environnements et les sorties réseau. Cette section montre comment les opérateurs peuvent utiliser DICloak pour configurer des profils de navigateur distincts et configurer des proxies appartenant aux utilisateurs pour chaque outil ou compte, sans risque de chevauchement ou de signaux partagés.
Configuration des profils de navigateur séparés et de la configuration des empreintes digitales dans DICloak
Les opérateurs peuvent créer un nouveau profil navigateur dans DICloak pour chaque environnement de codage ou compte, puis ajuster les paramètres d’empreintes digitales, comme l’Agent utilisateur, le système d’exploitation, le fuseau horaire et la résolution de l’écran, pour correspondre au cas d’utilisation visé. Ce flux de travail maintient le stockage et les signaux d’identification du navigateur complètement séparés entre les sessions, afin que le passage entre outils d’IA ou comptes de plateforme ne brouille pas les frontières. Le champ d’application ici se limite à l’isolation au niveau du navigateur ; cela ne modifie pas l’outil de codage connecté ni ne gère les comptes eux-mêmes. 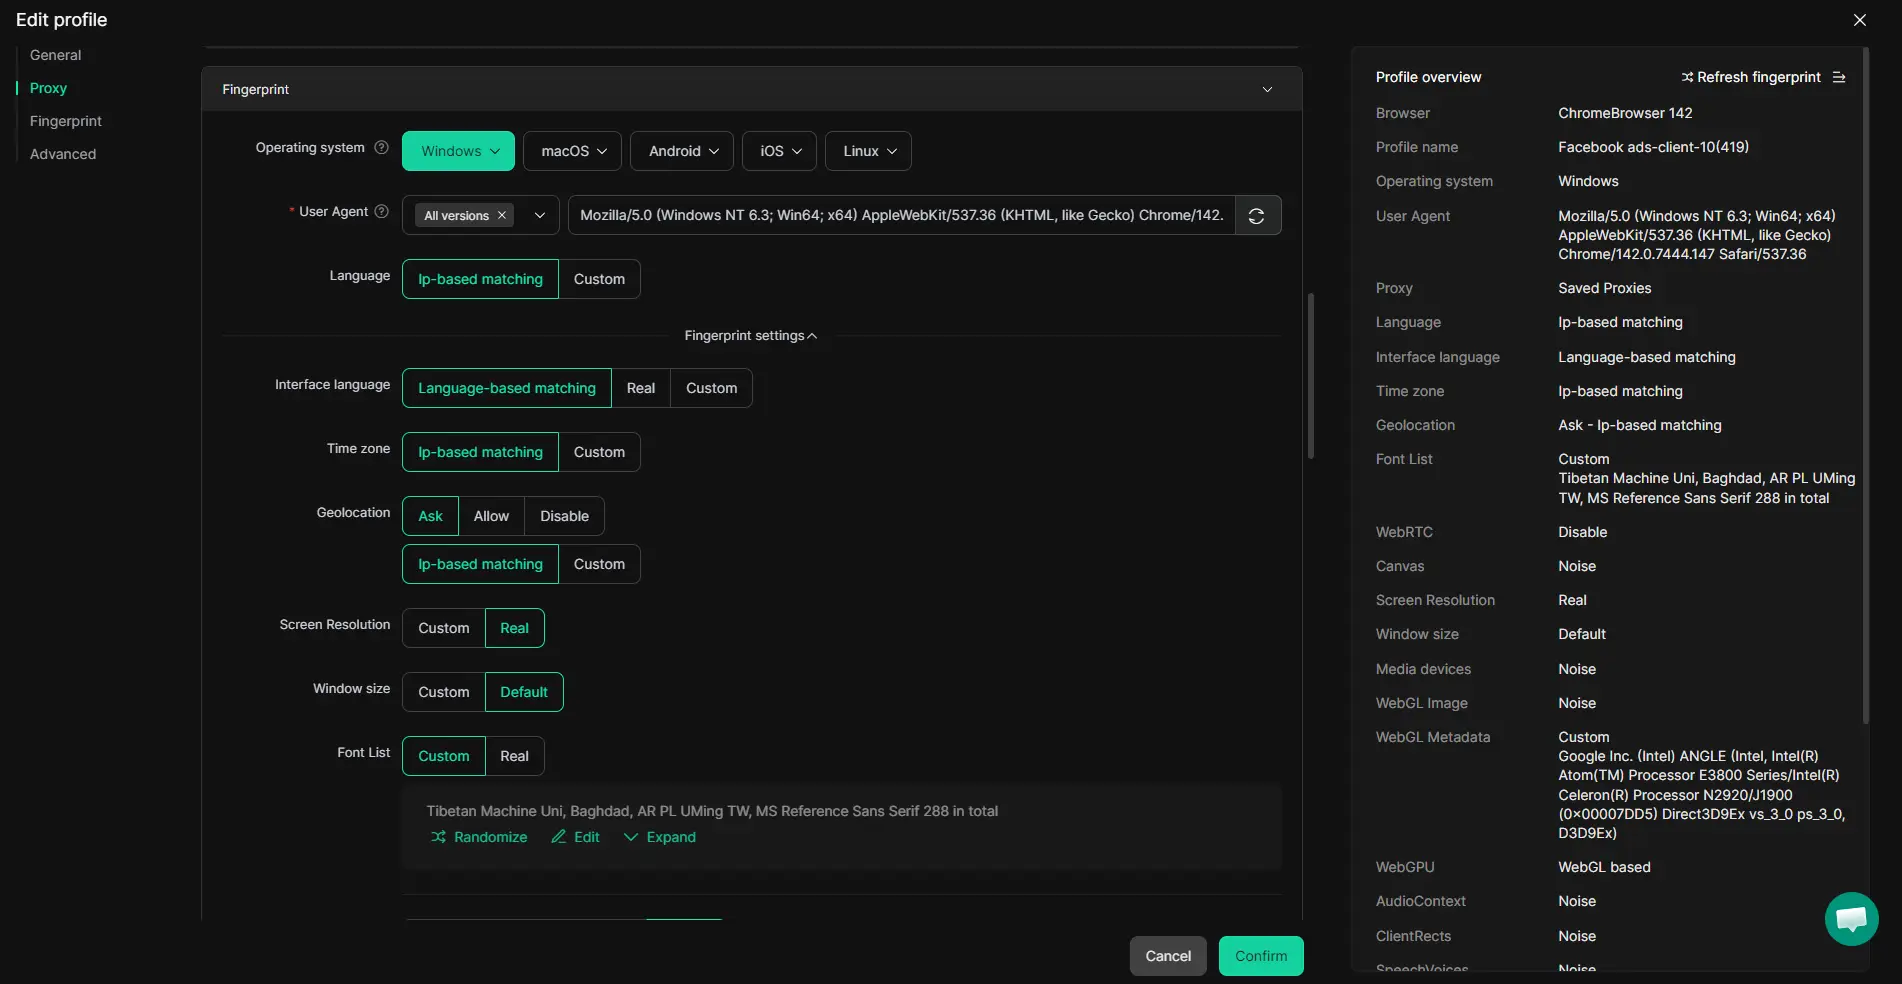
Configuration des proxys appartenant à l’utilisateur pour chaque profil
Pour les flux de travail où différents comptes ou sessions de codage ont besoin de leur propre sortie réseau, les opérateurs peuvent configurer une connexion proxy séparée sur chaque profil DICloak. Vous pouvez saisir vos propres détails proxy, les tester directement dans la configuration du profil, et confirmer l’emplacement du réseau avant d’utiliser ce profil pour le travail de codage. DICloak stocke ces paramètres par profil, mais ne vend jamais ni ne fournit de proxys, la sélection et la qualité restent votre responsabilité. 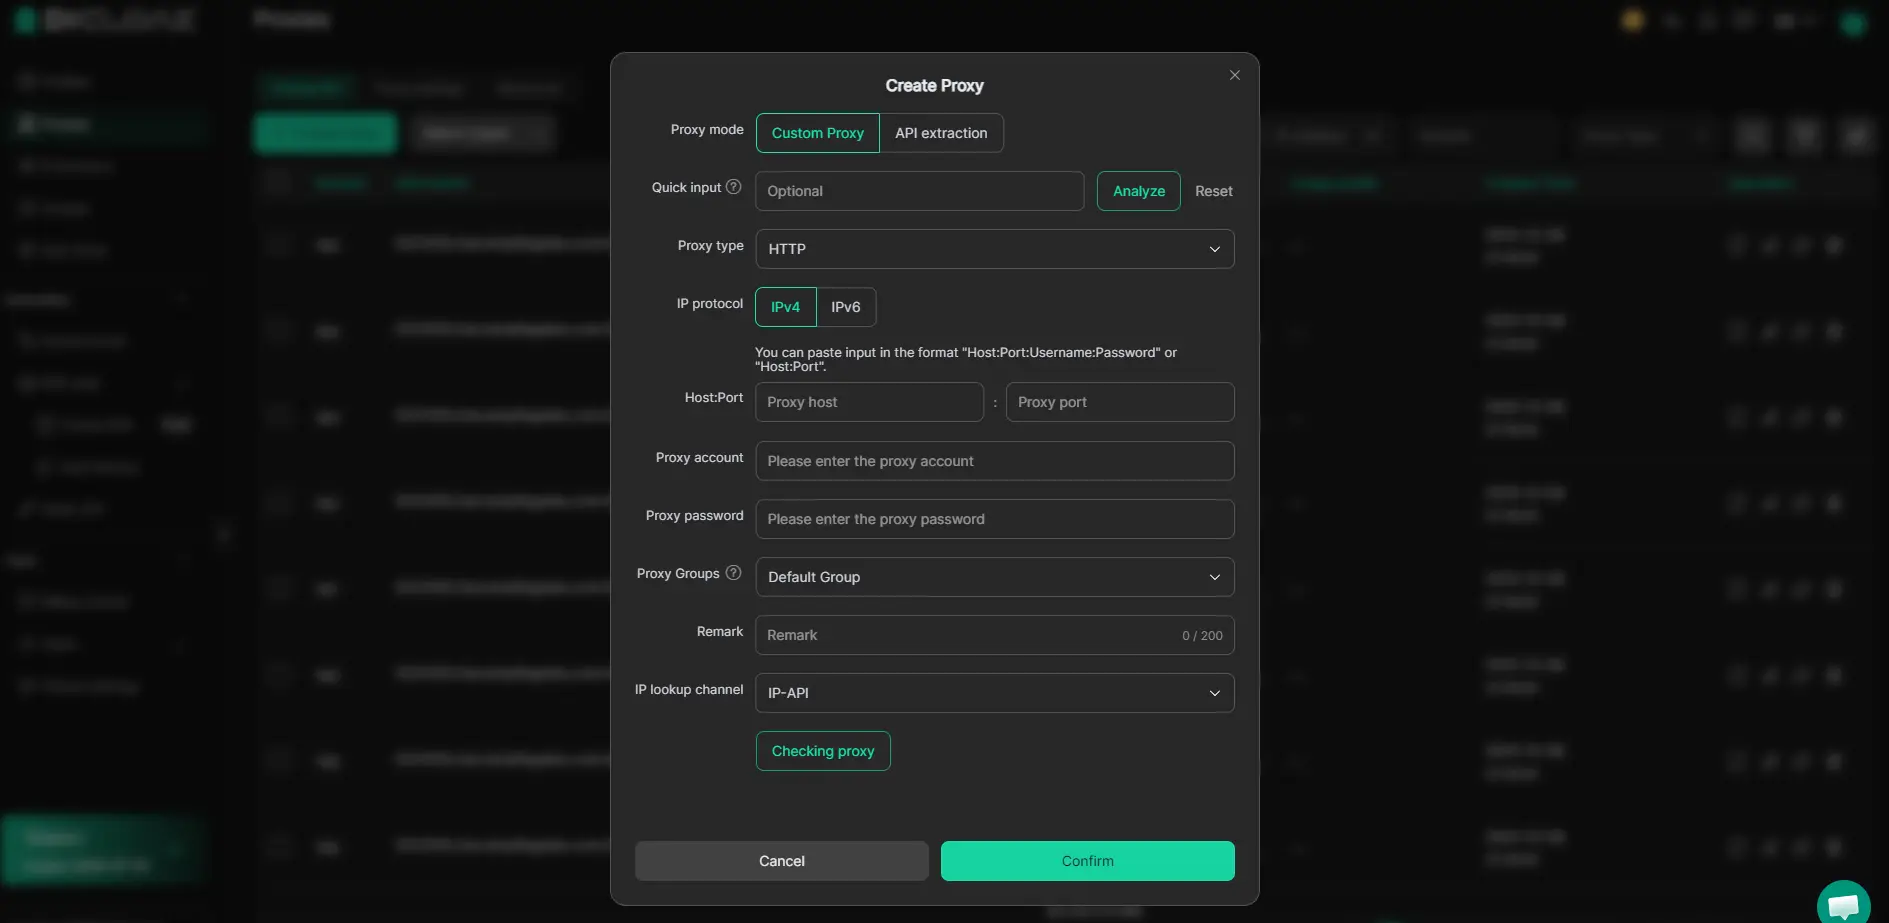
Si vous sautez ces étapes de configuration, les fuites entre comptes peuvent apparaître sans être remarquées, puis nous aborderons les erreurs courantes et comment les éviter.
Erreurs courantes lors de la réponse aux régressions du codex (et comment les éviter)
Beaucoup de développeurs qui remarquent des régressions du Codex réagissent trop vite ou sautent les vérifications de touches, ce qui aggrave les choses. C’est là que les gens trébuchent, et comment éviter les pièges habituels.
Tirer des conclusions hâtives sans tester
Il est facile de supposer que « le codex est devenu plus bête » signifie un déclin permanent, mais sauter le dépannage basique fait perdre du temps. La plupart des défaillances sont dues à une faute de frappe dans une invite, à un contexte manquant ou à une mise à jour silencieuse du modèle ; tester avec une invite connue peut faire gagner des heures.
Ignorer la sécurité et la conformité lors du changement d’outil
- Ne réutilisez jamais de mots de passe ou de clés API sur les nouveaux outils d’IA.
- Vérifiez les conditions de chaque outil avant de connecter les comptes professionnels.
- Notez les identifiants et les données de l’entreprise utilisés par environnement.
Trop compliquer votre flux de travail
Essayer trois nouveaux outils de codage en même temps entraîne souvent de la confusion et des fuites. Avant d’ajouter un nouvel outil, vérifiez :
- Pouvez-vous reconnaître quelle session est laquelle dans votre barre des tâches ?
- Vos dossiers de projet sont-ils clairement séparés par outil ?
- Avez-vous documenté quel outil a été utilisé pour chaque commit git ?
Quand rester avec Codex, changer d’outil ou combiner les approches
Si vous demandez si vous devez supporter une baisse de qualité du codage du codex ou changer de groupe, commencez par adapter le problème à vos besoins réels de workflow, pas seulement à votre niveau de frustration. Une régression d’outil semble personnelle, mais la bonne décision dépend du risque et de la lenteur réelle que ce lapsus.
Signes que ça vaut la peine de rester avec Codex
| Scénario |
Restez fidèle au Codex |
Pourquoi cela a-t-il du sens |
| La régression est mineure/temporaire |
Oui |
Les petites chutes se résolvent souvent après les mises à jour |
| Les alternatives perturbent le flux de travail |
Oui |
Changer peut coûter plus de temps qu’il n’en gagne |
| Code non critique, faible risque |
Oui |
Si les erreurs sont faciles à corriger, les petites gouttes font moins mal |
Si la chute est agaçante mais pas bloquante, il vaut généralement mieux attendre une correction que de revoir toute ta pile.
Quand changer ou compléter avec d’autres outils
Quand Codex commence à échouer sur les flux de travail principaux, ou que vous trouvez un autre outil adapté à votre stack ou langage spécifique, changer est la solution la moins compliquée. Les erreurs persistantes qui bloquent les projets sont la limite rouge, ne perdez pas de jours à espérer une solution qui ne viendra pas.
Mélanger plusieurs outils pour une productivité maximale
Mélanger les outils fonctionne mieux quand vous suivez quel assistant gère quel type de code, ne jetez pas toutes les tâches à chaque IA. Notez ce qui casse où, pour pouvoir acheminer les requêtes vers l’outil qui livre réellement. Cela évite le double travail et maintient la production en mouvement.
Foire aux questions sur Codex devenaient plus bêtes
Est-ce que Codex devient vraiment plus bête, ou est-ce juste mon expérience ?
Pour savoir si « codex est devenu plus bête » vient de vous ou d’un vrai problème, comparez vos résultats récents avec d’anciens exemples sur les mêmes tâches. Si vous remarquez plus d’erreurs ou moins de suggestions utiles, consultez les forums en ligne pour des plaintes similaires. Parfois, des changements ou mises à jour dans votre flux de travail peuvent aussi affecter les résultats, pas seulement le modèle du Codex lui-même.
Que dois-je faire si Codex empire soudainement dans mes principales tâches de codage ?
Commencez par utiliser Codex avec des invites simples et claires pour voir si le problème est spécifique à votre projet actuel. Testez dans un autre navigateur ou appareil. Vérifiez les mises à jour récentes dans vos outils de codage ou dans Codex lui-même. Si le déclin continue, envisagez de partager vos retours avec OpenAI et de chercher des solutions de contournement que d’autres ont trouvées.
L’utilisation de proxies ou de profils navigateurs séparés peut-elle améliorer les performances du Codex ?
Les proxys et les profils navigateurs séparés aident à séparer votre travail et vos projets personnels. Ils n’améliorent pas la qualité du codage du codex principal ni ne répondent à la régression IA du codex. Ces outils peuvent faciliter le dépannage en isolant les variables, mais ils ne corrigeront pas une véritable baisse de performance du codex.
Y a-t-il des risques à passer d’un outil de codage IA à un autre ?
Oui, utiliser plusieurs outils de codage par IA peut embrouiller votre flux de travail et augmenter le risque de confusion des données. Les risques de sécurité et de conformité augmentent également si vous partagez du code sensible ou des identifiants entre plateformes. Vérifiez toujours les paramètres de confidentialité et les conditions d’utilisation de chaque outil avant de changer.
Comment puis-je protéger mes comptes et environnements de programmation en utilisant plusieurs outils d’IA ?
Utilisez des comptes et des profils navigateur séparés pour chaque outil. Ne partagez jamais de mots de passe ou de jetons entre eux. Stockez les identifiants dans un gestionnaire de mots de passe. Déconnectez-vous régulièrement et effacez les cookies. Évitez de télécharger du code sensible à moins de faire confiance à la sécurité de la plateforme. Consultez toujours les paramètres d’autorisation dans vos environnements de codage.
Compte tenu de ces changements récents, c’est le bon moment pour réévaluer vos outils actuels et chercher des solutions mieux adaptées à vos besoins de flux de travail. Si vous êtes prêt à explorer des alternatives qui maintiennent votre productivité sur la bonne voie, envisagez d’essayer DICloak. Essayez DICloak gratuitement
 Outils gratuits
 Extension de cookie
 Générateur UA
 Générateur d'adresse MAC
 Générateur d'IP
 Liste des adresses IP
 Générateur de code 2FA
 Horloge mondiale
 Vérification Anonyme
 WebRTC Leak Test
 Générateur UUID
 Vérificateur de proxy
 Vérificateur d'annonces FB
 Extraction de données web par IA
 Outils SMM gratuits
 Vérificateur d'ombre bannissement Twitter
 Générateur UTM
 Générateur de noms d'utilisateur
 Generateur de hashtags IA
 Générateur de titre LinkedIn
 Redimensionneur d’images sociales