Du tippst einen Prompt, der Codex spuckt fünf Zeilen defektes Python aus, und plötzlich ist dein täglicher Arbeitsablauf langsamer als noch vor einem Jahr. Wenn dir aufgefallen ist, dass der Codex bei Aufgaben, die er früher hervorragend erledigte, wie dem Schreiben einfacher Skripten oder dem Beheben einfacher Bugs, dümmer geworden ist , bist du nicht allein. Überall gibt es Beschwerden über einen Rückgang der Codex-Leistung und den Qualitätsverlust des Codex, aber niemand gibt eine klare Antwort darauf, was sich tatsächlich geändert hat.
Manche sagen, es sei nur deine Einbildung oder dass die Prompts schlampiger geworden seien, aber das passt nicht zum Muster. Reproduzierbare Regressionen tauchen sogar in gut dokumentierten Codebasen auf. Das Risiko ist nicht nur eine kleine Belästigung; wenn du auf Codex für Produktionscode angewiesen bist, kann schon ein kleiner Rückgang der Genauigkeit der Vorschläge zu stundenlangem manuellem Debugging oder verpassten Fristen führen.
Die eigentliche Geschichte dreht sich weniger um die rohe Größe des Modells, sondern mehr um Veränderungen bei Trainingsdaten, Ausrichtungsrichtlinien und wie Codex hinter den Kulissen aktualisiert wird. Änderungen, die die KI "sicherer" oder allgemeiner machen sollten, schneiden oft die Randfälle weg, die Codex früher wirklich nützlich für Power-User gemacht haben. Wenn Sie generische, weniger hilfreiche Antworten sehen, bilden Sie sich das nicht ein, Modellregression ist ein reales, nachverfolgbares Problem für Entwickler.
Was verursacht also tatsächlich den Qualitätsverlust und was kann man dagegen tun? Hier beginnen die Probleme aufzutreten.
Warum sagen so viele Nutzer, dass der Codex 2026 dümmer geworden ist?
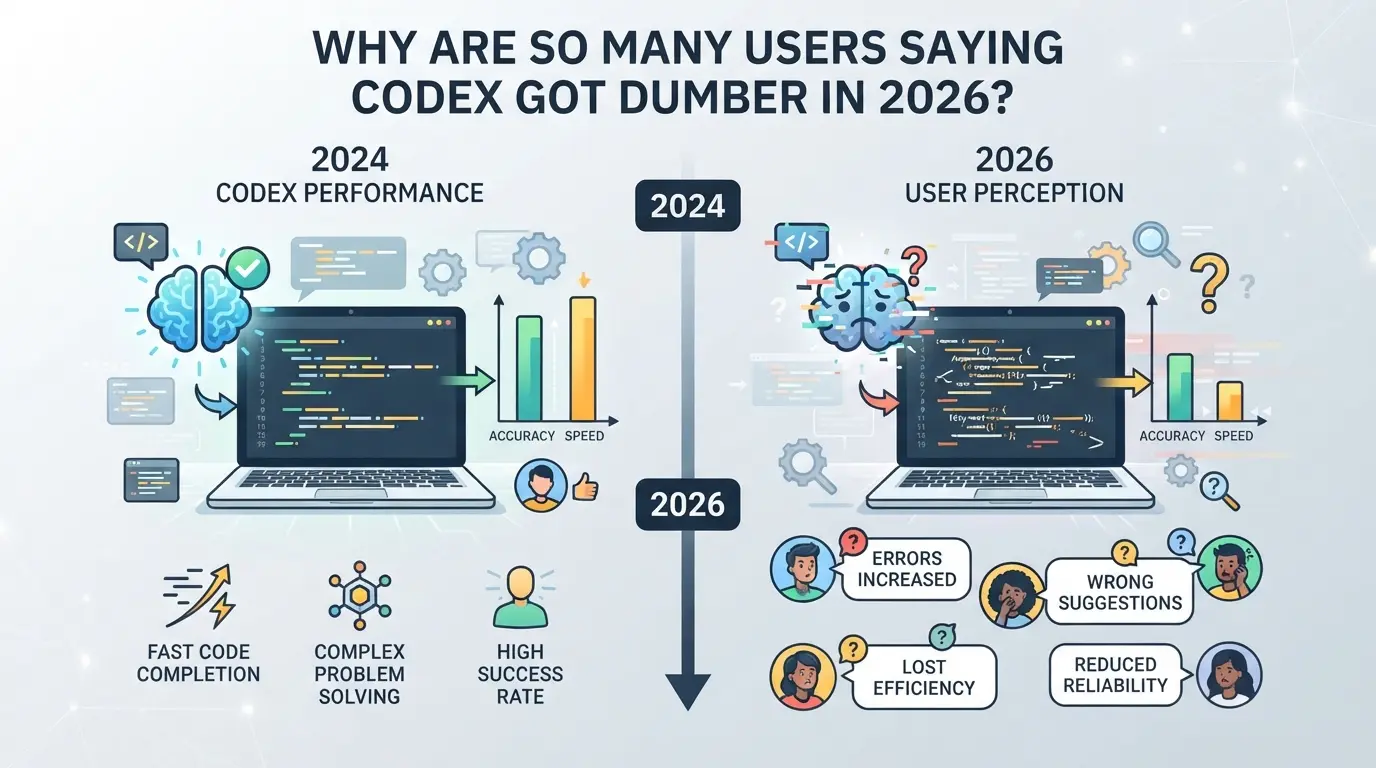
Beschwerden über die Codex-Programmierqualität sind nicht nur lauter, sondern kommen von erfahrenen Entwicklern, die auf scharfe, kontextbewusste Vorschläge angewiesen sind. Nutzer berichten jetzt von generischeren Fertigstellungen, themenfremdem Code und sogar alten Fehlern, die in früheren Versionen behoben wurden.
Häufige Beschwerden: Was Nutzer melden
Viele weisen darauf hin, dass Codex den aktuellen Kontext in mehrdateiigen Projekten vergisst, Variablen falsch benennt und Codeblöcke wiederholt, die nicht zum Prompt passen. Einfache Aufgaben wie REST-API-Stubs oder Datenparsing erhalten jetzt Standardantworten statt funktional korrektem Code.
Mögliche Auslöser: Updates, Modelländerungen oder Nutzungsverschiebungen?
Der Ausfall hängt mit großen Codex-Updates zusammen, die Ende 2025 und Anfang 2026 eingeführt wurden. Diese Updates konzentrierten sich darauf, riskante Vorschläge zu verhindern und den Code zu erweitern, um mehr Sprachen zu unterstützen, schnitten aber auch Nischen-Codemuster aus, auf die Power-User angewiesen waren. Wenn ein Modellupdate die Unterstützung für Randfall-Logik verliert, erhalten Aufgaben, die im letzten Jahr gut funktionierten, plötzlich vage oder unvollständige Antworten. Entwickler, die Codex täglich für Rapid Prototyping nutzen, sind besonders frustriert: Nach einem Update benötigt eine Aufgabe, die früher zwei Prompts benötigte, jetzt fünf oder sechs, falls sie überhaupt funktioniert. Fügt man das steigende Nutzervolumen und strengere Ausrichtungsrichtlinien hinzu, ist es keine Überraschung, dass viele sagen, Codex sei dümmer geworden. Der Schmerzpunkt ist nicht nur verlorene Geschwindigkeit; sondern der Vertrauensverlust darin, ob das Tool sich daran erinnert, wie man täglich arbeitet.
Wahrnehmung von Realität trennen
- Wenn sich dein Anwendungsfall geändert hat (z. B. größere Projekte oder neue Sprachen), ist ein Rückgang zu erwarten.
- Community-Frust, wie Threads auf Reddit, können Regressionen größer erscheinen lassen, als sie tatsächlich sind.
- Wenn man klügere Ergebnisse erwartet, sehen selbst kleine Fehler schlechter aus; die Frustration wächst schnell.
Wichtig ist jetzt zu lernen, wie man überprüft, ob dein Arbeitsablauf tatsächlich betroffen ist, und nicht nur nach dem Online-Rauschen zu hören. Das ist der nächste Schritt.
Wie kannst du feststellen, ob Codex tatsächlich schlechter für deine Aufgaben abschneidet?
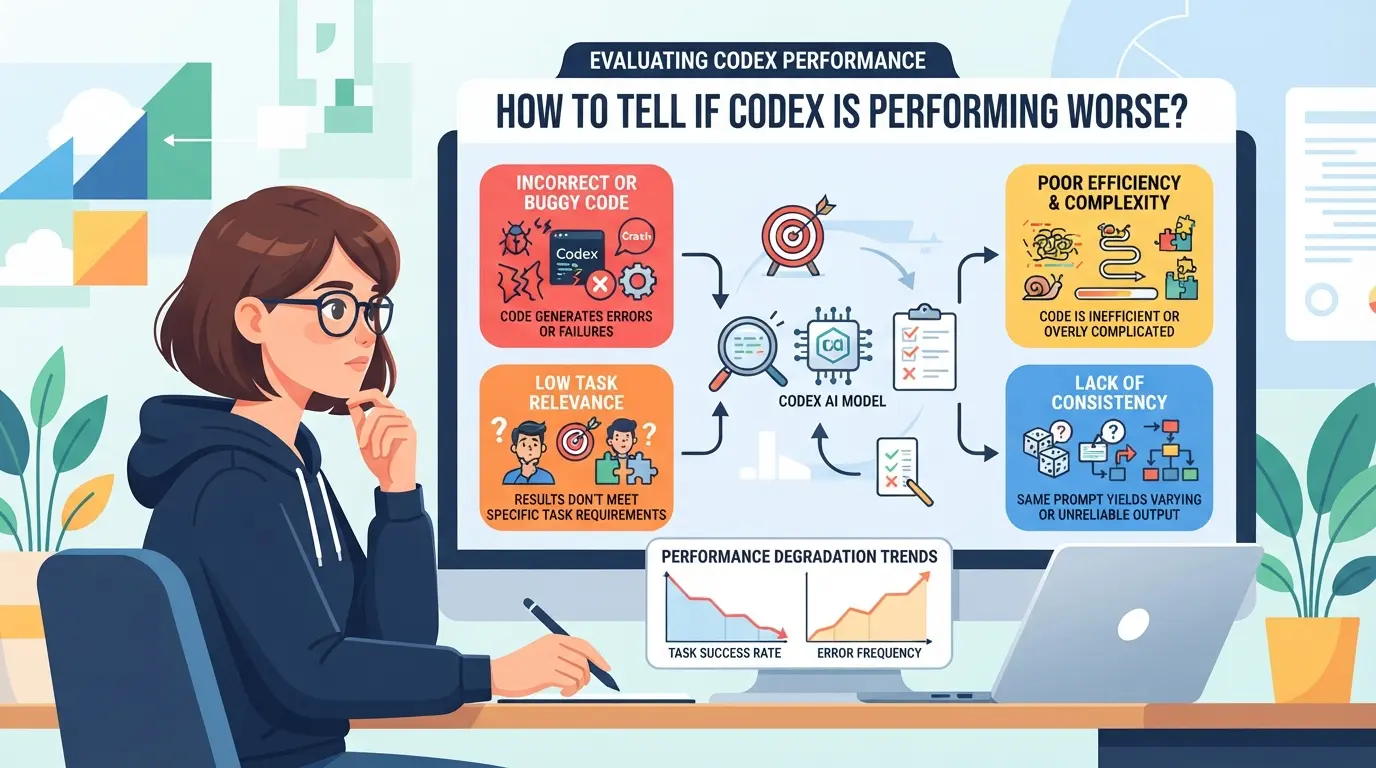
Wenn du denkst, dass der Codex schlechter wird, brauchst du einen Beweis, nicht nur ein Bauchgefühl. Viele Entwickler beschweren sich, dass "der Codex dümmer wurde", aber die meisten führen nie denselben Prompt zweimal aus oder verfolgen, was sich geändert hat. So kannst du überprüfen, ob das Tool wirklich schuld an deinem Programmieraufwand ist.
Einrichten kontrollierter Codetests
Die einzige Möglichkeit zu wissen, ob die Codex-Qualität bei deinen Aufgaben gesunken ist, ist das Durchführen von parallelen Tests. Wähle eine Reihe von Prompts, die zu deiner täglichen Arbeit passen, echte Fehlerbehebungen, Refaktoren oder Standardanfertigungen. Führe diese in Codex und wenn möglich in eine ältere Codex-Version oder ein konkurrierendes Modell ein. Nutze immer denselben Codekontext und dieselben Einstellungen. Wenn du Prompt, Seed und Umgebung nicht identisch hältst, kannst du Codex nicht für zufällige Unterschiede verantwortlich machen.
Nachverfolgung von Regressionsmustern über die Zeit hinweg
Wenn du immer wieder dieselben Fehler siehst, ist es Zeit, sie zu protokollieren. Regression zeigt sich meist als wiederholbare Probleme, nicht als zufällige Fehler. Nutze diese Mini-Checkliste, um echte Rückfälle zu erkennen:
- Speichere alle fehlgeschlagenen Abschlüsse mit Zeitstempel und Codex-Version.
- Markiere jedes Problem nach Sprache, Framework oder Aufgabe (z. B. API-Stub, Testfall).
- Vergleiche neue Fehler mit deinen alten Logs – ist genau dieser Fehler letzten Monat aufgetaucht?
Wann sollte man Codex oder Prompt-Engineering verantwortlich machen
Es ist leicht zu denken, Codex sei kaputt gegangen, obwohl sich dein Prompt tatsächlich geändert hat oder der Kontext noch unübersichtlicher wurde. Bevor du dem Modell die Schuld gibst, schau dir diese häufigen Fallen an:
- Hast du direkt vor dem Prompt Kommentare oder Codeblöcke hinzugefügt, entfernt oder neu arrangiert?
- Verwendest du jetzt ein neues Framework, eine neue Bibliothek oder Syntax, auf der Codex nicht trainiert wurde?
- Hast du deinen Prompt gekürzt oder ein wichtiges Beispiel übersprungen, das Codex früher gesehen hat?
Wenn du Prompt-Fehler betribst und Tests trotzdem scheitern, siehst du wahrscheinlich eine echte Codex-Regression. Wenn nicht, reagiert das Modell wahrscheinlich nur auf eine unschärfere Anfrage.
Der nächste Schritt ist, herauszufinden, was diese Regressionen, Modellaktualisierungen, Datenänderungen oder etwas anderes verursacht. Hier beginnen die wirklichen Antworten zu erscheinen.
Was führt dazu, dass KI-Coding-Tools wie Codex immer dümmer werden?
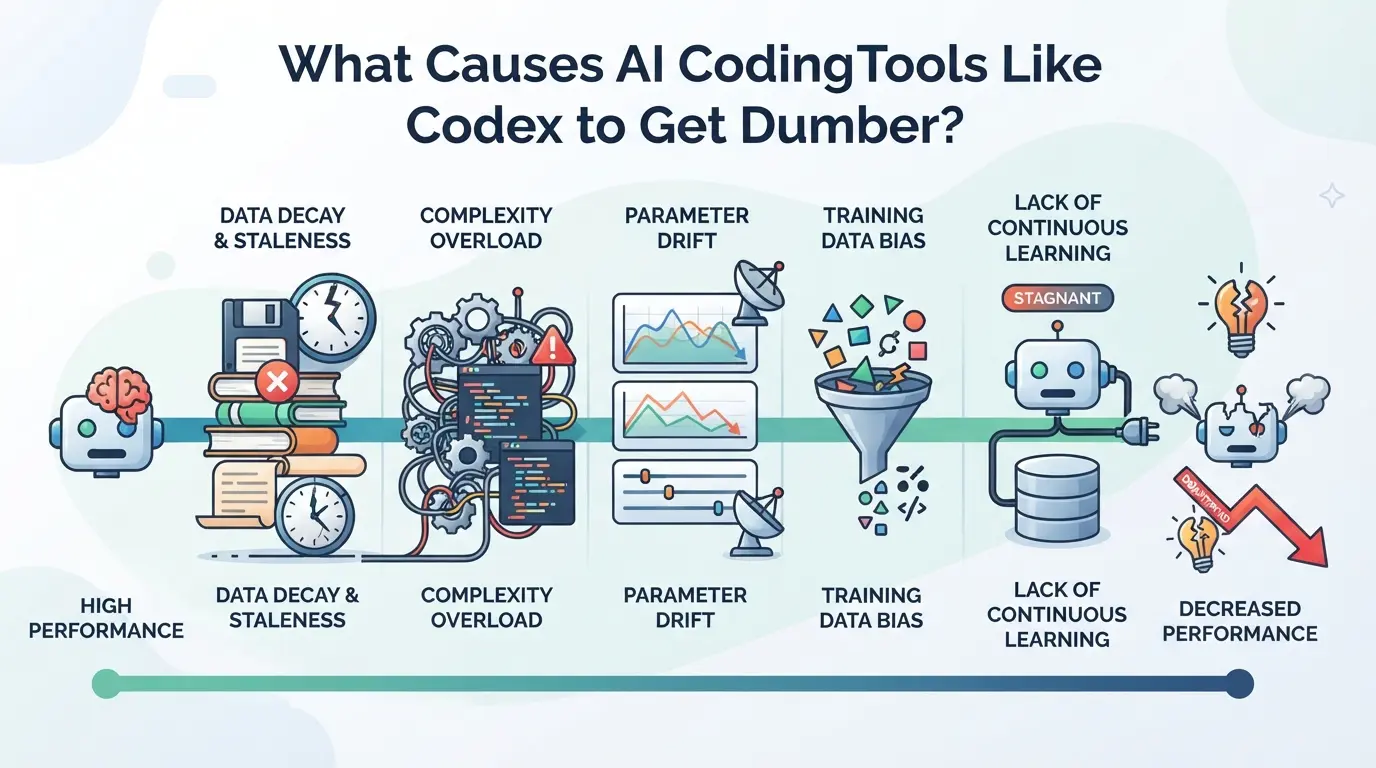
Die meisten Qualitätsrückgänge im Codex führen auf Änderungen im Hintergrund, neue Daten, strengere Regeln oder technische Abkürzungen zurück. Es handelt sich selten um einen einzelnen Bug. Wenn dir aufgefallen ist, dass Codex dümmer wurde, siehst du die Nebenwirkungen dieser Kompromisse.
Modellupdates und Trainingsdatenverschiebungen
Wenn Codex mit frischen Daten neu trainiert wird, kann das Modell ältere, nischenhafte Muster verlieren, die es früher für Randfälle scharf gemacht hatten. Bemühungen, die "Zuverlässigkeit zu verbessern", bedeuten oft, dass das System nun vielfältigen Benutzercode mittelt, sodass einzigartige oder clevere Lösungen herausgefiltert werden. Deshalb bekommen Ihre alten Prompts vielleicht jetzt langweilige, generische Antworten.
Geschäfts- und politische Entscheidungen
KI-Tools werden nicht nur von Ingenieuren gestaltet, sondern auch von Geschäftsrisiken- und Compliance-Teams gesteuert. Updates, die Codex vor Beschwerden über Urheberrechts- oder beleidigende Inhalte schützen sollen, schneiden oft ganze Codebeispiele weg. Wenn ein Unternehmen beispielsweise die Filter verschärft, um rechtliche Probleme zu vermeiden, erhalten Sie plötzlich mehr Ablehnungen oder vage Ratschläge statt direkter Code-Fertigstellungen. Das ist noch wahrscheinlicher, wenn ein hoch sichtbarer Vorfall das Unternehmen dazu zwingt, überall durchzugreifen. Die Kompromisse können hart sein: Der Schutz der Marke bedeutet manchmal, dass das Modell fortschrittliche, aber sensible Codierungstechniken überspringt. Auch Ressourcenverschiebungen können schaden; wenn das Unternehmen Codex nicht mehr priorisiert, könnten Sie langsamere Fehlerbehebungen oder weniger Investitionen in die Modellqualität sehen. Wenn Ihr KI-Coding-Tool anfängt, Fragen zu vermeiden, die es früher beantwortet hat, ist das fast immer ein Zeichen dafür, dass Sicherheits- oder Richtlinienfilter strenger geworden sind.
Technische Schulden und Skalierungsherausforderungen
- Infrastruktur-Verzögerungen: Wenn Server nicht mithalten können, steigt die Latenz und Code-Fertigstellungen werden verkürzt oder gestrichen.
- Skalierungsabkürzungen: Schnelles Nutzerwachstum kann das Team dazu zwingen, die Modellgröße zu verkleinern oder leichtere Versionen zu verwenden.
- Testlücken: Hastige Veröffentlichungen unter starker Skalierung überspringen oft tiefe Regressionsprüfungen, sodass neue Fehler einschleichen.
Diese Faktoren erklären nicht nur, warum die Codex-Leistung sinkt, sondern auch, warum Korrekturen nicht schnell oder vorhersehbar sind. Wenn du mehr Fehler oder weniger nützlichen Code siehst, liegt das meist daran, dass sich etwas vorgelagert geändert hat, oft aus Gründen außerhalb der reinen Ingenieurtechnik.
Wie Sie Ihren Programmier-Workflow anpassen, wenn die Codex-Qualität sinkt
Wenn die Codex-Performance sinkt, geh direkt damit um: Passe deinen Arbeitsablauf an, damit du keine Zeit verlierst oder fehlerhaften Code aussendest. Die richtigen Änderungen halten dich produktiv, auch wenn die Vorschläge schlechter werden.
Diversifizierung Ihres KI-Werkzeugsets
- Versuche mindestens einen alternativen Codierassistenten (wie Copilot, StarCoder oder Open-Source-Modelle). Wenn Codex nicht ausreicht, ist ein direkter Vergleich der schnellste Weg, um zu sehen, ob etwas anderes für deinen Stack besser funktioniert.
- Kombiniere KI-Tools mit deiner Standard-IDE oder Linter. Wechsle nicht einfach die Werkzeuge, sondern führe beide parallel aus. Das hilft dir, Stilprobleme oder übersehene Logik zu erkennen, die KI-Ausgaben oft verursachen.
- Dokumentiere, welches Tool oder welche Kombination deine eigentlichen Problempunkte löst. Führe ein einfaches Protokoll: "Copilot besser beim Refaktorisieren, Codex besser bei Docstrings." Das verhindert, dass du ohne Plan zwischen Tools springst.
- Achte auf plötzliche Ausfälle in jedem Tool. Der gleiche Update-Zyklus, der Codex schlechter gemacht hat, könnte auch andere treffen, also halte Alternativen geprüft und bereit.
Verbesserung von Prompt-Engineering und Überprüfungsprozessen
- Wenn Codex den Punkt verfehlt, reduzieren Sie Ihre Prompts. Verwenden Sie spezifische Funktionssignaturen, geben Sie Testfälle und staatliche Sprachversionen an, das verringert den Fokus der KI.
- Überprüfen Sie immer generierten Code, bevor Sie ihn ausführen, besonders bei Randfällen. Wenn Codex' Vorschläge früher "nur funktionierten", aber jetzt Tests nicht mehr bewirken, gehen Sie davon aus, dass jede Ausgabe genauer betrachtet werden muss.
- Wenn du weiterhin schwachen oder abweichenden Code bekommst, schreibe deinen Prompt neu und starte ihn erneut. Eine so kleine Änderung wie "Python 3.10 Syntax verwenden" kann eine bessere Antwort erzwingen.
- Kombiniere manuelle Code-Review mit KI-Ausgabe. Selbst wenn die Überprüfung dich verlangsamt, sparst sie verschwendete Stunden an stillen logischen Fehlern.
Verwaltung von Multi-Account- oder Multi-Environment-Setups
- Richte separate Browserprofile oder Sandboxen für jedes KI-Tool oder Codex-Konto ein. Das hält deine Arbeit und den Tool-Verlauf sauber, sodass ein Werkzeug, das rückfällig wird, nicht den Rest verschmutzt.
- Verfolgen Sie, welche Umgebung und Login jede größere Codeänderung verursacht haben. Wenn ein Fehler auftaucht, wissen Sie, welches Tool ihn erstellt hat, nicht nur, welche Zeile gebrochen ist.
- Wenn du merkwürdiges Verhalten bemerkst, wie Code, der kompiliert, aber zur Laufzeit fehlschlägt, prüfe, ob er von einem Tool unter einem anderen Konto stammt. Kreuzkontamination ist ein echtes Risiko beim Wechsel von Werkzeugen.
- Rotiere die Umgebung, wenn eine anfängt, zu verzögern oder Fehler zu machen. Manchmal behebt das blosse Wechseln zu einem neuen Profil "festgefahrene" KI-Sitzungen, die veraltete oder wiederholte Vorschläge zurückgeben.
Wie man Programmierumgebungen und Konten sicher trennt, wenn man mehrere KI-Tools verwendet
Risiken der Vermischung von Konten und Sitzungen
Das Mischen von Codierungssitzungen oder KI-Tool-Konten im selben Browserprofil kann Cookies leaken, API-Schlüssel offenlegen oder Plattformwarnungen auslösen. Cross-Login-Verlauf ist ein häufiger Grund, warum Nutzer plötzlich markiert oder ratenbegrenzt werden.
Best Practices für Umweltisolation
Verwenden Sie separate Browserprofile oder besser gesagt eigenständige Browser für jedes Coding-Konto oder -tool. Weisen Sie jedem Profil einen einzigartigen Proxy zu, wenn Sie sensible oder regionsspezifische Aufgaben bearbeiten. Dies verhindert, dass Sitzungsdaten und Netzwerkfingerabdrücke über verschiedene Umgebungen hinweg übergehen.
Wann sollte man fortschrittliche Werkzeuge zur Isolation in Betracht ziehen
- Sie bearbeiten täglich 3+ KI-Tools oder mehrere Benutzeranmeldungen
- Man arbeitet im Team mit gemeinsamen Geräten oder Profilen
- Plattformsperrungen oder wiederholte Verifizierungsanfragen beginnen zu erscheinen
Verwendung von DICloak für isolierte Codierumgebungen und Proxy-Konfiguration
Wenn Sie Programmiersitzungen oder Plattformkonten wirklich getrennt halten müssen, besonders nachdem Sie Probleme wie den Kodex dümmer geworden sind oder plattformspezifische KI-Qualitätsabfälle festgestellt haben, bietet DICloak Teams eine strukturierte Möglichkeit, Umgebungen und Netzwerkausgänge zu isolieren. Dieser Abschnitt zeigt, wie Betreiber DICloak nutzen können, um unterschiedliche Browserprofile einzurichten und benutzereigene Proxys für jedes Tool oder Konto zu konfigurieren, ohne das Risiko von Überschneidungen oder gemeinsamen Signalen.
Einrichten separater Browserprofile und Fingerabdruckkonfiguration in DICloak
Operatoren können in DICloak für jede Codierumgebung oder jedes Konto ein neues Browserprofil erstellen und dann die Fingerabdruckeinstellungen wie User Agent, Betriebssystem, Zeitzone und Bildschirmauflösung an den beabsichtigten Anwendungsfall anpassen. Dieser Workflow hält die Speicher- und Identifikationssignale des Browsers zwischen den Sitzungen vollständig getrennt, sodass der Wechsel zwischen KI-Tools oder Plattformkonten die Grenzen nicht verwischt. Der Anwendungsbereich ist auf Browser-Ebene beschränkt; es ändert weder das verbundene Coding-Tool noch verwaltet sie die Konten selbst. 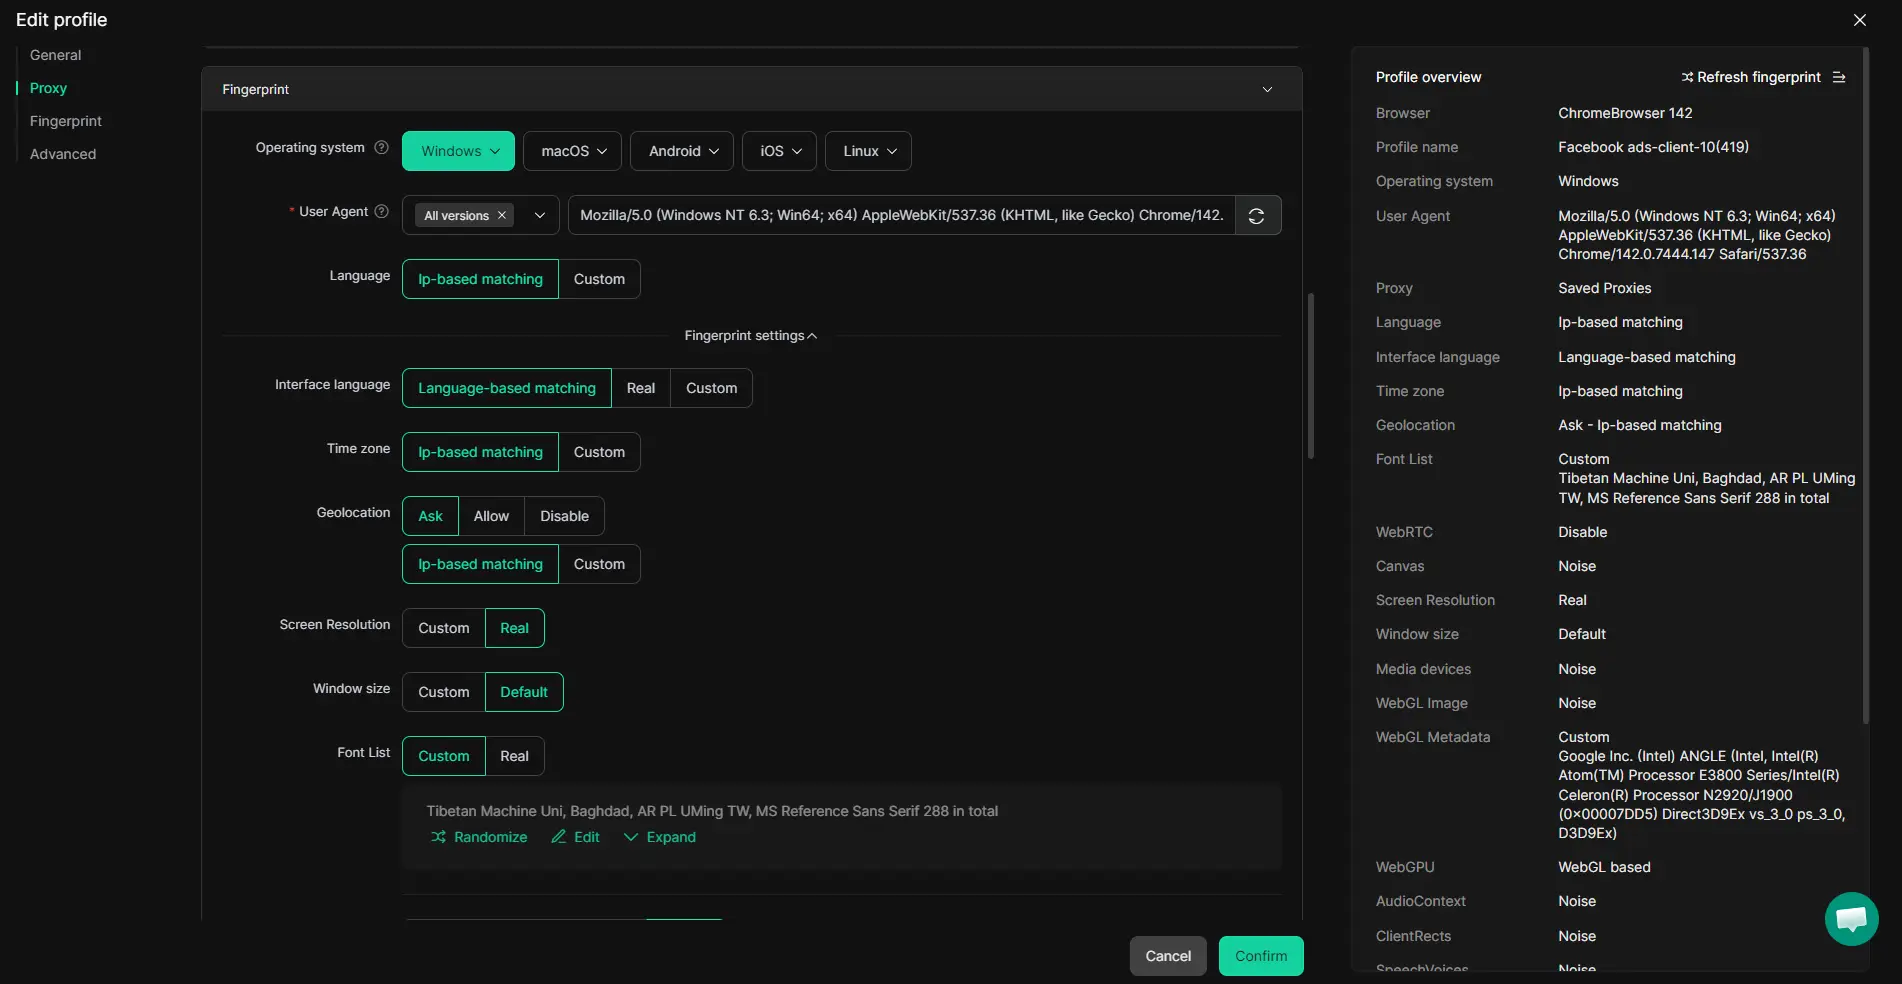
Konfiguration benutzereigener Proxys für jedes Profil
Für Workflows, bei denen verschiedene Konten oder Coding-Sitzungen ihren eigenen Netzwerkausgang benötigen, können Betreiber auf jedem DICloak-Profil eine separate Proxy-Verbindung einrichten. Sie können Ihre eigenen Proxy-Daten eingeben, sie direkt in der Profileinrichtung testen und den Netzwerkstandort bestätigen, bevor Sie dieses Profil für die Programmierung verwenden. DICloak speichert diese Einstellungen pro Profil, verkauft oder stellt nie Proxys bereit; Auswahl und Qualität bleiben Ihre Verantwortung. 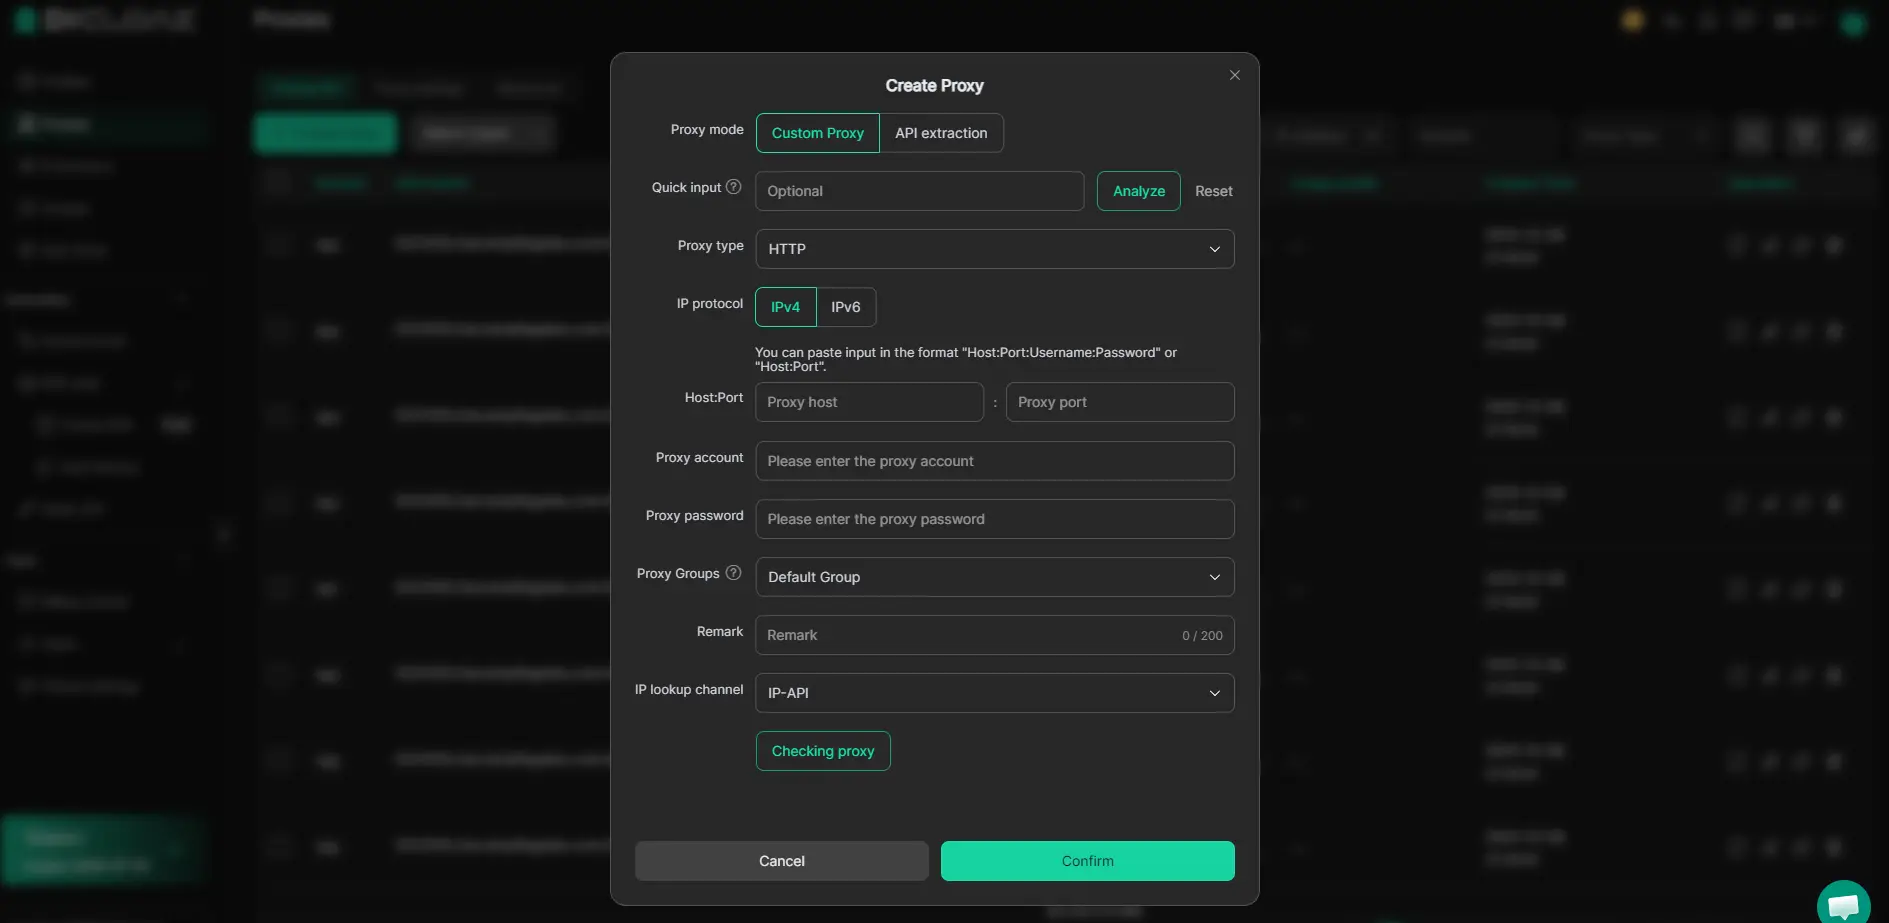
Wenn Sie diese Einrichtungsschritte überspringen, können Cross-Account-Leaks unbemerkt einschleichen. Als Nächstes behandeln wir häufige Fehler und wie Sie sie vermeiden können.
Häufige Fehler bei der Reaktion auf Codex-Regressionen (und wie man sie vermeidet)
Viele Entwickler, die Codex-Regressionen bemerken, reagieren zu schnell oder überspringen Tastenprüfungen, was die Lage noch verschlimmert. Hier stolpern Leute und wie man den üblichen Fallen ausweicht.
Voreilige Schlüsse ohne Tests ziehen
Es ist leicht anzunehmen, dass "Codex dümmer wurde" einen dauerhaften Rückgang bedeutet, aber das Überspringen grundlegender Fehlersuche kostet Zeit. Die meisten Fehler führen auf einen Tippfehler, fehlenden Kontext oder ein stilles Modellupdate zurück; ein Testen mit einer bekannten guten Eingabeaufforderung kann Stunden sparen.
Sicherheit und Compliance beim Wechsel von Tools ignorieren
- Verwenden Sie niemals Passwörter oder API-Schlüssel in neuen KI-Tools.
- Überprüfen Sie die Bedingungen jedes Tools, bevor Sie Arbeitskonten verbinden.
- Protokollieren Sie, welche Zugangsdaten und Unternehmensdaten pro Umgebung verwendet werden.
Überkomplizierte Arbeitsabläufe
Das Ausprobieren von drei neuen Coding-Tools gleichzeitig führt oft zu Verwirrung und Lecks. Bevor Sie ein neues Tool hinzufügen, prüfen Sie:
- Kannst du in deiner Taskleiste erkennen, welche Sitzung welche ist?
- Sind deine Projektordner klar nach Werkzeugen getrennt?
- Hast du dokumentiert, welches Tool für jeden Git-Commit verwendet wurde?
Wann man beim Codex bleibt, Werkzeuge wechselt oder Ansätze kombiniert
Wenn du dich fragst, ob du einen Qualitätsverlust im Codex überstehen oder abspringen sollst, fang damit an, das Problem deinen tatsächlichen Workflow-Anforderungen anzupassen, nicht nur deinem Frustrationsniveau. Ein Tool-Downgrade fühlt sich persönlich an, aber der richtige Schritt hängt vom Risiko ab und davon, wie sehr der Ausrutscher dich tatsächlich verlangsamt.
Anzeichen, dass es sich lohnt, beim Codex zu bleiben
| Szenario |
Bleib beim Codex |
Warum das Sinn ergibt |
| Regression ist geringfügig/vorübergehend |
Ja |
Kleine Drops lösen sich oft nach Updates auf |
| Alternativen stören den Arbeitsablauf |
Ja |
Ein Wechsel kann mehr Zeit kosten, als es spart |
| Nicht-kritischer Code, geringes Risiko |
Ja |
Wenn Fehler leicht zu beheben sind, schaden kleine Tropfen weniger |
Wenn der Drop nervt, aber nicht blockiert, ist es meist klüger, auf eine Lösung zu warten, als den gesamten Stack komplett zu überarbeiten.
Wann man wechseln oder mit anderen Werkzeugen ergänzen sollte
Wenn Codex bei Kern-Workflows versagt oder du ein anderes Tool findest, das auf deinen spezifischen Stack oder deine Sprache abgestimmt ist, ist der Wechsel der weniger schmerzhafte Weg. Persistente, projektblockierende Fehler sind die rote Linie – verschwende keine Tage mit der Hoffnung auf eine Lösung, die nicht kommt.
Kombinieren mehrerer Werkzeuge für maximale Produktivität
Mischwerkzeuge funktionieren am besten, wenn du verfolgest, welcher Assistent welchen Code übernimmt, und wirf nicht einfach alle Aufgaben jeder KI zu. Führe Notizen darüber, was wo unterbricht, damit du Anfragen an das Tool weiterleiten kannst, das tatsächlich liefert. Das vermeidet Doppelarbeit und hält die Produktion am Laufen.
Häufig gestellte Fragen zum Codex wurden dümmer
Wird Codex wirklich dümmer, oder ist das nur meine Erfahrung?
Um herauszufinden, ob "Codex dümmer geworden" nur Sie sind oder ein echtes Problem, vergleichen Sie Ihre aktuellen Ergebnisse mit älteren Beispielen zu denselben Aufgaben. Wenn Sie mehr Fehler oder weniger hilfreiche Vorschläge bemerken, schauen Sie in Online-Foren nach ähnlichen Beschwerden nach. Manchmal können auch Änderungen oder Aktualisierungen des Workflows in Ihrer Umgebung die Ergebnisse beeinflussen, nicht nur das Codex-Modell selbst.
Was soll ich tun, wenn Codex plötzlich schlechter bei meinen Hauptprogrammieraufgaben wird?
Versuchen Sie zunächst, Codex mit einfachen, klaren Eingabeaufforderungen zu verwenden, um zu sehen, ob das Problem spezifisch für Ihr aktuelles Projekt ist. Testen Sie in einem anderen Browser oder einem anderen Gerät. Prüfen Sie aktuelle Updates in Ihren Programmierungswerkzeugen oder im Codex selbst. Wenn der Rückgang anhält, sollten Sie in Erwägung ziehen, Feedback mit OpenAI zu teilen und nach Workarounds zu suchen, die andere gefunden haben.
Kann die Verwendung von Proxys oder separaten Browserprofilen die Codex-Leistung verbessern?
Proxys und separate Browserprofile helfen, Ihre Arbeit und persönlichen Projekte voneinander zu trennen. Sie verbessern weder die Qualität des Codex-Kerncodes noch beheben sie die Codex-KI-Regression. Diese Tools können die Fehlersuche erleichtern, indem sie Variablen isolieren, aber sie beheben keinen echten Leistungseinbruch des Codex.
Gibt es Risiken, zwischen mehreren KI-Coding-Tools zu wechseln?
Ja, die Nutzung mehrerer KI-Codierungstools kann Ihren Arbeitsablauf verwirren und die Wahrscheinlichkeit von Verwechslungen erhöhen. Sicherheits- und Compliance-Risiken steigen ebenfalls, wenn Sie sensiblen Code oder Zugangsdaten zwischen Plattformen teilen. Überprüfen Sie immer die Datenschutzeinstellungen und Nutzungsbedingungen jedes Tools, bevor Sie wechseln.
Wie halte ich meine Konten und Programmierumgebungen sicher, wenn ich mehrere KI-Tools benutze?
Verwenden Sie separate Konten und Browserprofile für jedes Tool. Teilen Sie niemals Passwörter oder Token zwischen ihnen. Speichern Sie Ihre Zugangsdaten in einem Passwortmanager. Melden Sie sich regelmäßig aus und löschen Sie Cookies. Vermeiden Sie das Hochladen von sensiblem Code, es sei denn, Sie vertrauen der Sicherheit der Plattform. Überprüfen Sie immer die Berechtigungseinstellungen in Ihren Programmierumgebungen.
Angesichts dieser jüngsten Änderungen ist es ein guter Moment, Ihre aktuellen Werkzeuge neu zu bewerten und nach Lösungen zu suchen, die besser zu Ihren Workflow-Anforderungen passen. Wenn Sie bereit sind, Alternativen zu prüfen, die Ihre Produktivität auf Kurs halten, sollten Sie DICloak ausprobieren. Probieren Sie DICloak kostenlos aus
 Kostenlose Werkzeuge
 Cookie-Erweiterung
 UA Generator
 MAC-Adressen-Generator
 IP-Generator
 IP-Adressliste
 2FA-Code-Generator
 Weltuhr
 Anonymer Check
 WebRTC Leak Test
 UUID-Generator
 Proxy-Checker
 FB Anzeigenprüfer
 KI-Web-Scraping
 Kostenlose SMM-Tools
 Twitter Shadowban-Checker
 UTM Generator
 Username Generator
 AI Hashtag Generator
 LinkedIn Headline Generator
 Bildgrößen-Tool für Social Media