Escribes un prompt, Codex te saca cinco líneas de Python roto y, de repente, tu flujo de trabajo diario es más lento que hace un año. Si has notado que Codex se ha vuelto más torpe en tareas que antes superaba, como escribir scripts básicos o arreglar errores simples, no estás solo. Las quejas sobre la caída del rendimiento y la calidad del código están por todas partes, pero nadie da una respuesta clara sobre qué ha cambiado realmente.
Algunos dicen que es solo tu imaginación, o que los prompts se han vuelto más descuidados, pero eso no coincide con el patrón. Las regresiones reproducibles aparecen incluso en bases de código bien documentadas. El riesgo no es solo una molestia menor; si dependes de Codex para el código de producción, incluso una pequeña caída en la precisión de las sugerencias puede significar horas de depuración manual o plazos incumplidos.
La verdadera historia tiene menos que ver con el tamaño bruto del modelo y más con cambios en los datos de entrenamiento, las políticas de alineación y cómo Codex se actualiza entre bastidores. Los cambios destinados a hacer que la IA sea "más segura" o más generales suelen eliminar los casos límite que antes hacían que Codex fuera realmente útil para usuarios avanzados. Si ves respuestas más genéricas y menos útiles, no te lo estás imaginando; la regresión de modelos es un problema real y rastreable para los desarrolladores.
Entonces, ¿qué es lo que realmente está causando la pérdida de calidad y qué se puede hacer al respecto? Aquí es donde empiezan a aparecer los problemas.
¿Por qué tantos usuarios dicen que Codex se volvió más tonto en 2026?
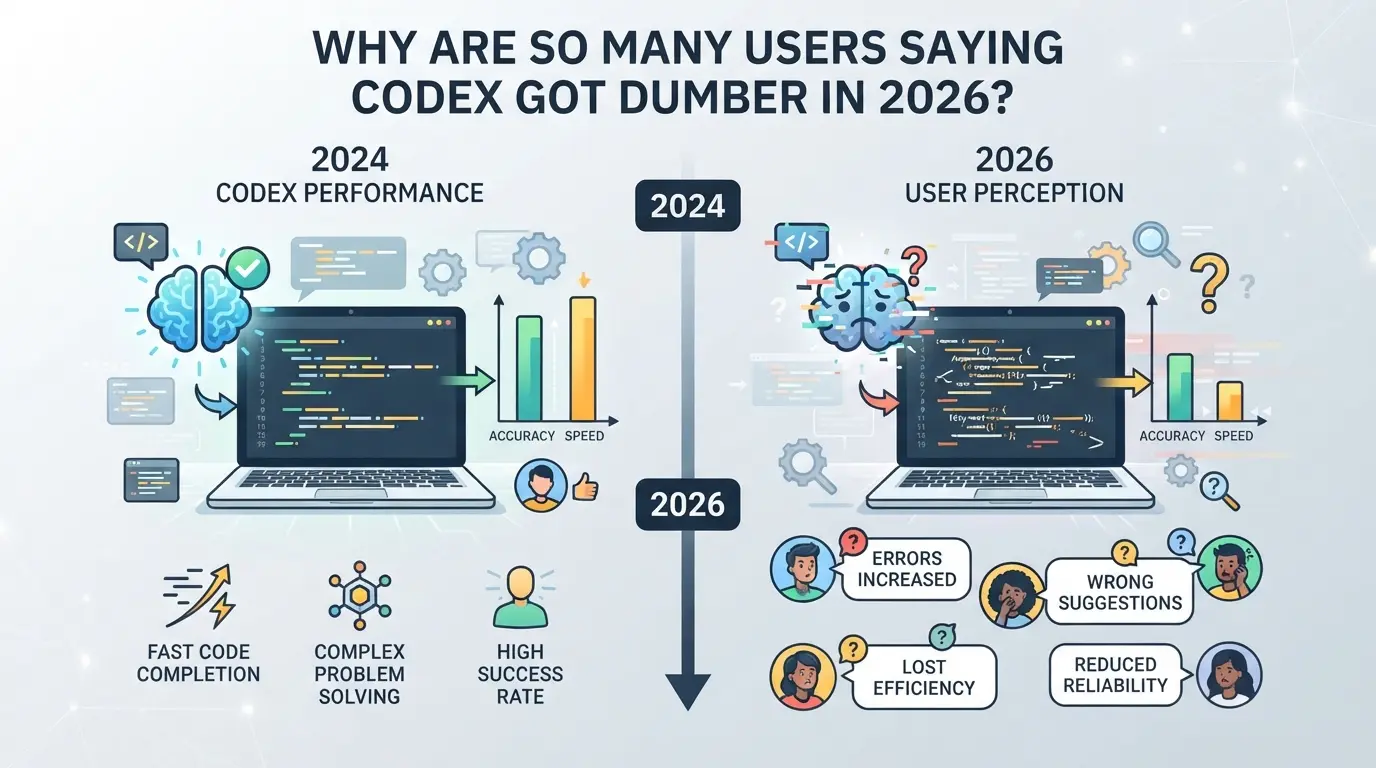
Las quejas sobre la calidad del código de Codex no solo son más fuertes, sino que provienen de desarrolladores experimentados que se apoyaban en sugerencias agudas y contextuales. Ahora los usuarios informan de completaciones más genéricas, código fuera de tema e incluso errores antiguos que se corrigieron en versiones anteriores.
Quejas comunes: qué reportan los usuarios
La gente señala que Codex olvida el contexto reciente en proyectos de varios archivos, nombra mal variables y repite bloques de código que no encajan en el prompt. Tareas simples como los stubs de API REST o el análisis de datos ahora reciben respuestas estándar en lugar de código funcionalmente correcto.
Posibles desencadenantes: ¿Actualizaciones, cambios de modelo o cambios en el uso?
La caída se relaciona con las principales actualizaciones de Codex lanzadas a finales de 2025 y principios de 2026. Estas actualizaciones se centraron en evitar sugerencias arriesgadas y ampliar la base de código para soportar más lenguajes, pero también eliminaron patrones de código de nicho de los que dependían los usuarios avanzados. Cuando una actualización de modelo deja de soportar lógica de casos límite, las tareas que funcionaban bien el año pasado de repente reciben respuestas vagas o incompletas. Los desarrolladores que usan Codex a diario para prototipado rápido se frustran especialmente: tras una actualización, una tarea que antes requería dos prompts ahora necesita cinco o seis, si es que funciona. Si añades un aumento del volumen de usuarios y políticas de alineación más estrictas, no es de extrañar que la gente diga que Codex se volvió más torpe. El problema no es solo la pérdida de velocidad; es la erosión de la confianza en si la herramienta "recuerda" cómo trabajas día a día.
Separando la percepción de la realidad
- Si tu caso de uso cambia (por ejemplo, proyectos más grandes o nuevos lenguajes), se espera cierto declive.
- Desahogarse en la comunidad, como los hilos en Reddit, puede hacer que las regresiones parezcan más grandes de lo que son.
- Cuando esperas resultados más inteligentes, incluso los errores pequeños parecen peores; la frustración se acumula rápidamente.
Lo que importa ahora es aprender a comprobar si tu flujo de trabajo realmente se ve afectado, no solo basarte en el ruido en internet. Ese es el siguiente paso.
¿Cómo puedes saber si Codex realmente está funcionando peor para tus tareas?
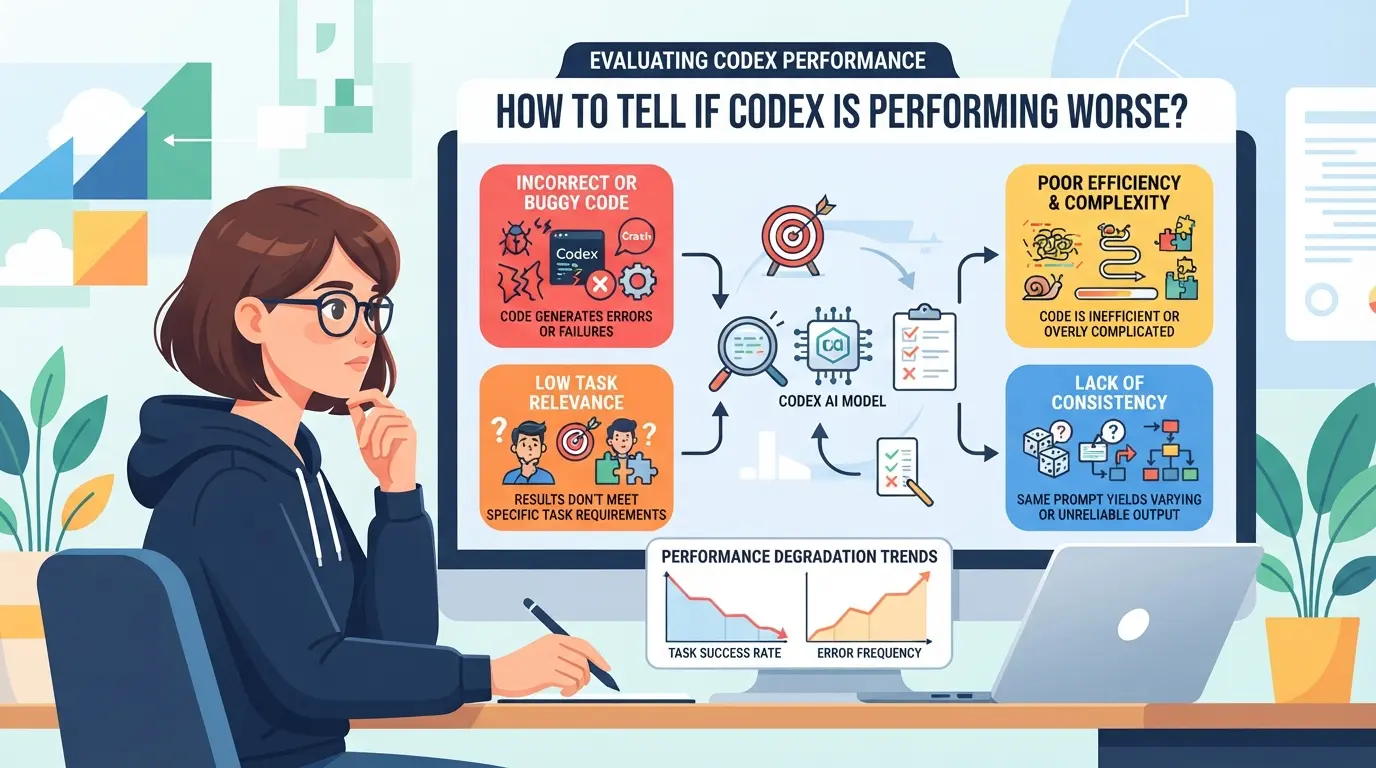
Si crees que Codex está empeorando, necesitas pruebas, no solo una corazonada. Muchos desarrolladores se quejan de que "Codex se volvió más tonto", pero la mayoría nunca ejecuta el mismo prompt dos veces ni registra qué ha cambiado. Así es como comprobar si la herramienta realmente es la responsable de tu carga de trabajo de programación.
Configuración de pruebas de código controlado
La única forma de saber si la calidad del Codex ha bajado en tus tareas es hacer pruebas lado a lado. Elige un conjunto de prompts que coincidan con tu trabajo diario, correcciones reales de errores, refactorizaciones o generación de boilerplates. Introduce estos en Codex y, si es posible, en una versión anterior de Codex o en un modelo competidor. Usa siempre el mismo contexto de código y configuraciones. Si no mantienes el prompt, la semilla y el entorno idénticos, no puedes culpar a Codex por diferencias aleatorias.
Seguimiento de patrones de regresión a lo largo del tiempo
Si sigues viendo los mismos fallos, es hora de registrarlos. La regresión suele aparecer como problemas repetibles, no como errores aleatorios. Usa esta mini-lista de comprobación para detectar rechazos reales:
- Guarda todas las finalizaciones fallidas con la marca de tiempo y la versión del códice.
- Etiqueta cada problema por lenguaje, framework o tarea (por ejemplo, stub de API, caso de prueba).
- Compara los errores nuevos con tus registros antiguos, ¿apareció exactamente este error el mes pasado?
Cuándo culpar al códice vs. ingeniería de prompts
Es fácil pensar que el Codex se ha roto, cuando en realidad tu prompt cambió o el contexto se volvió más desordenado. Antes de culpar al modelo, revisa estas trampas comunes:
- ¿Añadiste, eliminaste o reorganizaste los comentarios o bloques de código justo antes del prompt?
- ¿Ahora usas un nuevo framework, biblioteca o sintaxis en la que Codex no fue entrenado?
- ¿Has acortado tu prompt o te has saltado algún ejemplo clave que el Codex usaba para ver?
Si corriges errores en los prompts y las pruebas siguen fallando, probablemente estés viendo una regresión real del Codex. Si no, probablemente el modelo solo esté respondiendo a una petición más difusa.
El siguiente paso es investigar qué causa estas regresiones, actualizaciones de modelos, cambios en los datos u otra cosa. Ahí es donde empiezan a aparecer las respuestas reales.
¿Qué causa que herramientas de codificación con IA como Codex sean más tontas?
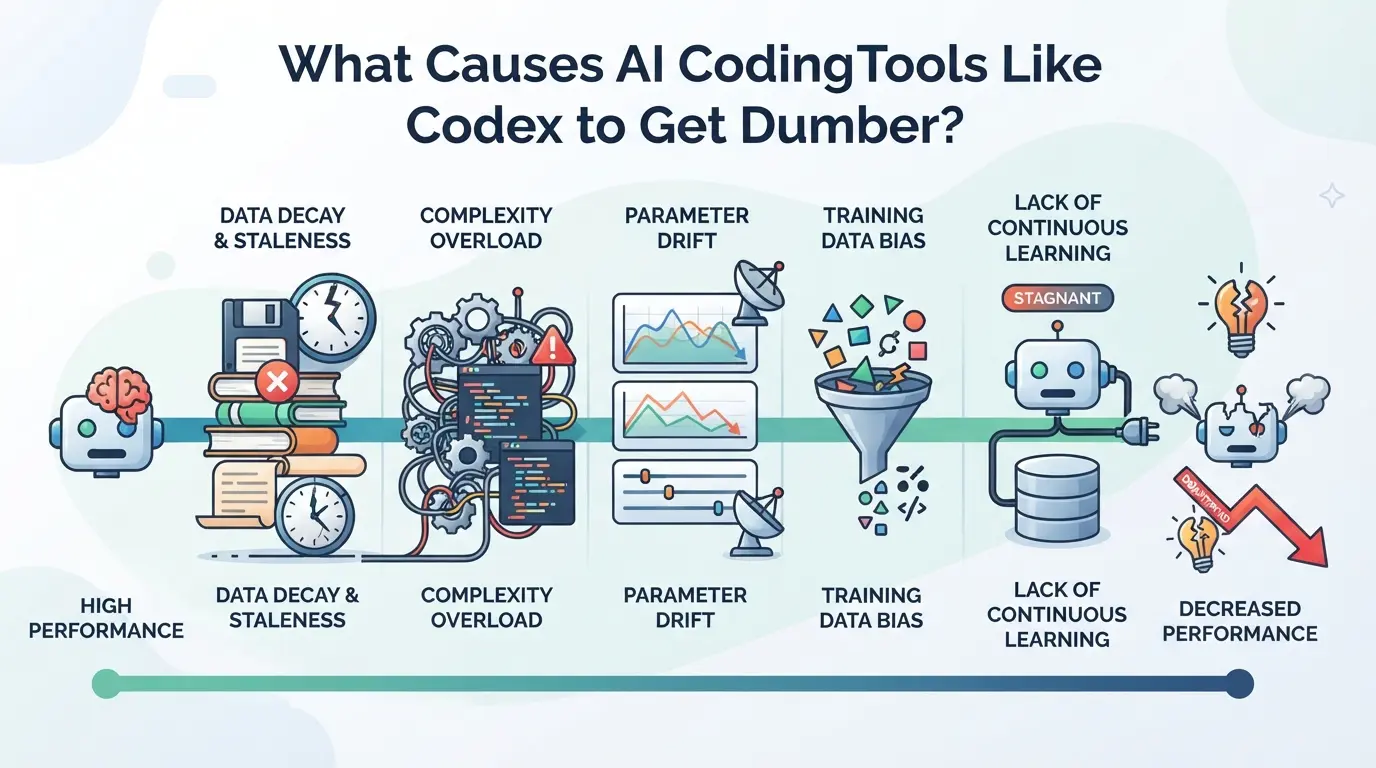
La mayoría de las caídas en la calidad de Codex se deben a cambios entre bastidores, nuevos datos, reglas más estrictas o atajos técnicos. Rara vez es un solo error. Si has notado que Codex se ha vuelto más torpe, estás viendo los efectos secundarios de estos sacrificios.
Actualizaciones de modelos y cambios de datos de entrenamiento
Cuando Codex se reentrena con datos nuevos, el modelo puede perder patrones antiguos y de nicho que antes lo hacían nítido en casos extremos. Los esfuerzos por "mejorar la fiabilidad" a menudo hacen que el sistema ahora promedia código de usuario diverso, por lo que soluciones únicas o ingeniosas quedan filtradas. Por eso tus antiguos prompts pueden ahora ser respuestas insípidas y genéricas.
Decisiones Empresariales y de Política
Las herramientas de IA no solo las moldean los ingenieros, sino que están dirigidas por equipos de riesgo empresarial y cumplimiento. Las actualizaciones destinadas a mantener el Codex "seguro" frente a quejas por derechos de autor o contenido ofensivo suelen eliminar ejemplos completos de código. Por ejemplo, si una empresa endurece los filtros para evitar problemas legales, de repente recibirás más rechazos o consejos vagos en lugar de completar código directamente. Esto es aún más probable si un incidente de alta visibilidad empuja a la empresa a tomar medidas estrictas en general. Los compromisos aquí pueden ser duros: proteger la marca a veces significa que el modelo omite técnicas de codificación avanzadas pero sensibles. Los cambios de recursos también pueden perjudicar; si la empresa deja de priorizar Codex, podrías ver correcciones de errores más lentas o menos inversión en la calidad del modelo. Si tu herramienta de codificación con IA empieza a esquivar preguntas que antes respondía, casi siempre es señal de que los filtros de seguridad o políticas se han vuelto más estrictos.
Deuda técnica y desafíos de escalado
- Retrasos en la infraestructura: Si los servidores no pueden seguir el ritmo, la latencia aumenta y las finalizaciones de código se recortan o se eliminan.
- Atajos de escalado: El rápido crecimiento de usuarios puede obligar al equipo a reducir el tamaño del modelo o a usar versiones más ligeras.
- Pruebas de lagunas: Las versiones apresuradas bajo un escalado pesado suelen saltarse comprobaciones de regresión profundas, permitiendo que se colen nuevos errores.
Estos factores se combinan para explicar no solo por qué el rendimiento del Codex baja, sino por qué las correcciones no son rápidas ni predecibles. Si ves más errores o código menos útil, normalmente es porque algo ha cambiado aguas arriba, a menudo por razones ajenas a la ingeniería pura.
Cómo adaptar tu flujo de trabajo de programación cuando la calidad del códex baja
Si el rendimiento del Codex baja, afronta la situación de frente: ajusta tu flujo de trabajo para no perder tiempo ni enviar código con errores. Los cambios adecuados te mantienen productivo, incluso cuando las sugerencias empeoran.
Diversificando tu conjunto de herramientas de IA
- Prueba al menos con un asistente de programación alternativo (como Copilot, StarCoder o modelos de código abierto). Si Codex no es suficiente, una comparación directa es la forma más rápida de ver si otra opción funciona mejor para tu stack.
- Combina herramientas de IA con tu IDE o linter estándar. No cambies solo de herramienta, ejecuta ambas en paralelo. Esto te ayuda a detectar problemas de estilo o lógica que suelen introducir las salidas de IA.
- Documenta qué herramienta o combinación resuelve tus verdaderos puntos de dolor. Lleva un registro sencillo: "Copilot mejor con refactorización, Codex mejor con docstrings." Esto evita que saltes entre herramientas sin un plan.
- Estate atento a caídas repentinas en cualquier herramienta. El mismo ciclo de actualizaciones que empeoró el Codex podría afectar a otros después, así que mantén las alternativas revisadas y preparadas.
Mejora de la ingeniería rápida y los procesos de revisión
- Cuando Codex empiece a perder el punto, reduce tus indicaciones. Usa firmas específicas de funciones, da casos de prueba y establece versiones en lenguajes, esto reduce el enfoque de la IA.
- Revisa siempre el código generado antes de ejecutarlo, especialmente en casos límite. Si las sugerencias de Codex antes "simplemente funcionaban" pero ahora fallan en las pruebas, asume que cada salida necesita un análisis más detallado.
- Si sigues recibiendo código débil o fuera de objetivo, reescribe tu prompt y vuelve a ejecutarlo. Un cambio tan pequeño como "usa la sintaxis de Python 3.10" puede forzar una mejor respuesta.
- Combina la revisión manual de código con la salida de la IA. Aunque la revisión te ralentice, ahorras horas perdidas en errores lógicos silenciosos.
Gestión de configuraciones multicuenta o multientorno
- Configura perfiles de navegador o sandboxes separados para cada herramienta de IA o cuenta de Codex. Esto mantiene limpio tu historial de trabajo y herramientas, así si una herramienta retrocede, no contaminará el resto.
- Haz un seguimiento de qué entorno y qué inicio de sesión produjeron cada cambio importante de código. Si aparece un error, sabrás qué herramienta lo creó, no solo qué línea se rompió.
- Si notas comportamientos extraños, como código que compila pero falla en tiempo de ejecución, comprueba si proviene de una herramienta con otra cuenta. La contaminación cruzada es un riesgo real al cambiar de herramienta.
- Rota los entornos si uno empieza a retrasarse o a dar errores. A veces, simplemente cambiar a un perfil nuevo arregla las sesiones de IA "atascadas" que devuelven sugerencias repetidas o apagadas.
Cómo separar de forma segura entornos de programación y cuentas al utilizar múltiples herramientas de IA
Riesgos de mezclar cuentas y sesiones
Mezclar sesiones de codificación o cuentas de herramientas de IA en el mismo perfil de navegador puede filtrar cookies, exponer claves API o activar advertencias de plataforma. El historial de inicio de sesión cruzado es una razón común por la que los usuarios son señalados o limitados por la tasa.
Mejores prácticas para el aislamiento ambiental
Utiliza perfiles de navegador separados, o mejor dicho, navegadores independientes, para cada cuenta de codificación o herramienta. Asigna un proxy único a cada perfil si gestionas tareas sensibles o específicas de región. Esto evita que los datos de sesión y las huellas digitales de red se filtren entre entornos.
Cuándo considerar herramientas avanzadas para el aislamiento
- Gestionas 3+ herramientas de IA o múltiples inicios de sesión de usuario diarios
- Trabajas en equipo con dispositivos o perfiles compartidos
- Empiezan a aparecer bloqueos de plataforma o solicitudes de verificación repetidas
Cómo usar DICloak para entornos de codificación aislados y configuración de proxy
Si necesitas mantener las sesiones de programación o cuentas de plataforma realmente separadas, especialmente después de notar problemas como que el códex se volvió más absurdo o caídas en la calidad de la IA específica de la plataforma, DICloak ofrece a los equipos una forma estructurada de aislar entornos y salidas de red. Esta sección muestra cómo los operadores pueden usar DICloak para configurar perfiles de navegador distintos y proxies propiedad de los usuarios para cada herramienta o cuenta, sin riesgo de solapamientos o señales compartidas.
Configuración de perfiles de navegador separados y configuración de huellas dactilares en DICloak
Los operadores pueden crear un nuevo perfil de navegador en DICloak para cada entorno de codificación o cuenta, y luego ajustar la configuración de huellas digitales, como el Agente de Usuario, el sistema operativo, la zona horaria y la resolución de pantalla, para ajustarla al caso de uso previsto. Este flujo de trabajo mantiene el almacenamiento e identificación del navegador completamente separados entre sesiones, por lo que cambiar entre herramientas de IA o cuentas de plataforma no difumina las líneas. El alcance aquí se limita al aislamiento a nivel de navegador; no cambia la herramienta de codificación conectada ni gestiona las cuentas en sí. 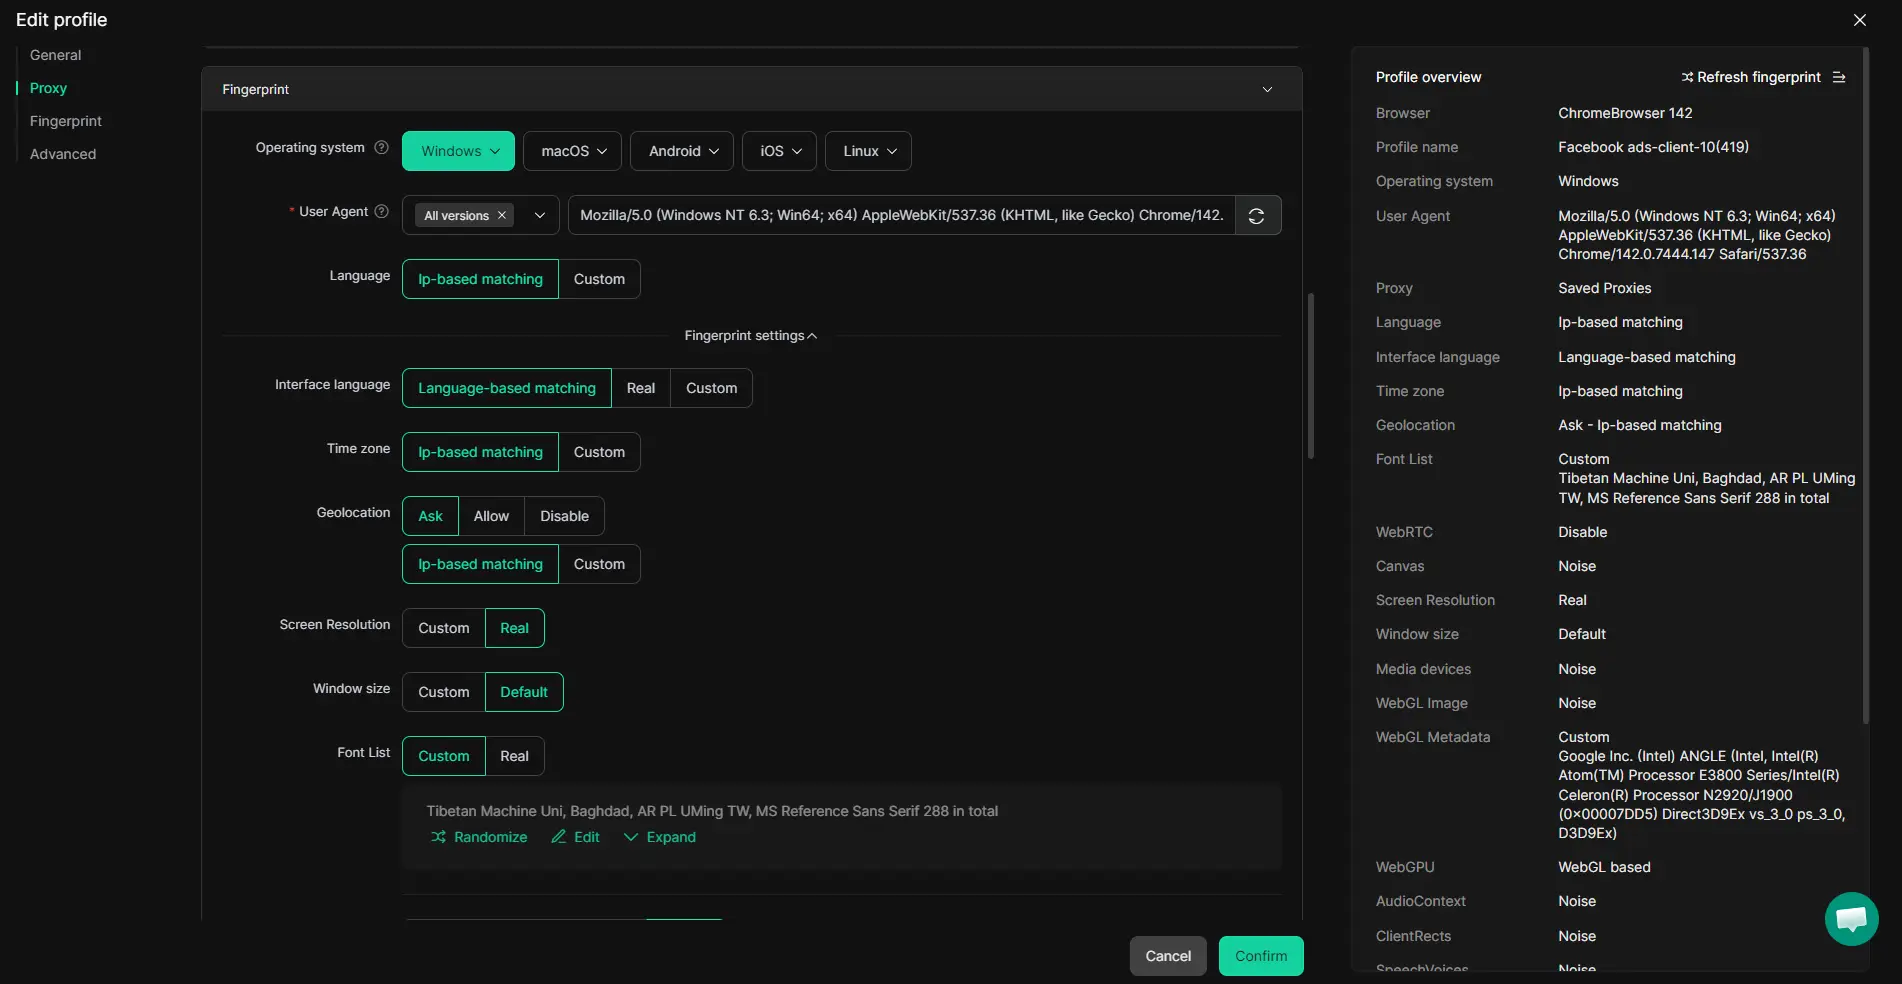
Configuración de proxies propiedad del usuario para cada perfil
Para flujos de trabajo donde diferentes cuentas o sesiones de codificación necesitan su propia salida de red, los operadores pueden configurar una conexión proxy separada en cada perfil DICloak. Puedes introducir tus propios datos de proxy, probarlos directamente en la configuración del perfil y confirmar la ubicación de la red antes de usar ese perfil para trabajos de codificación. DICloak almacena estos ajustes por perfil, pero nunca vende ni proporciona proxies; la selección y calidad siguen siendo tu responsabilidad. 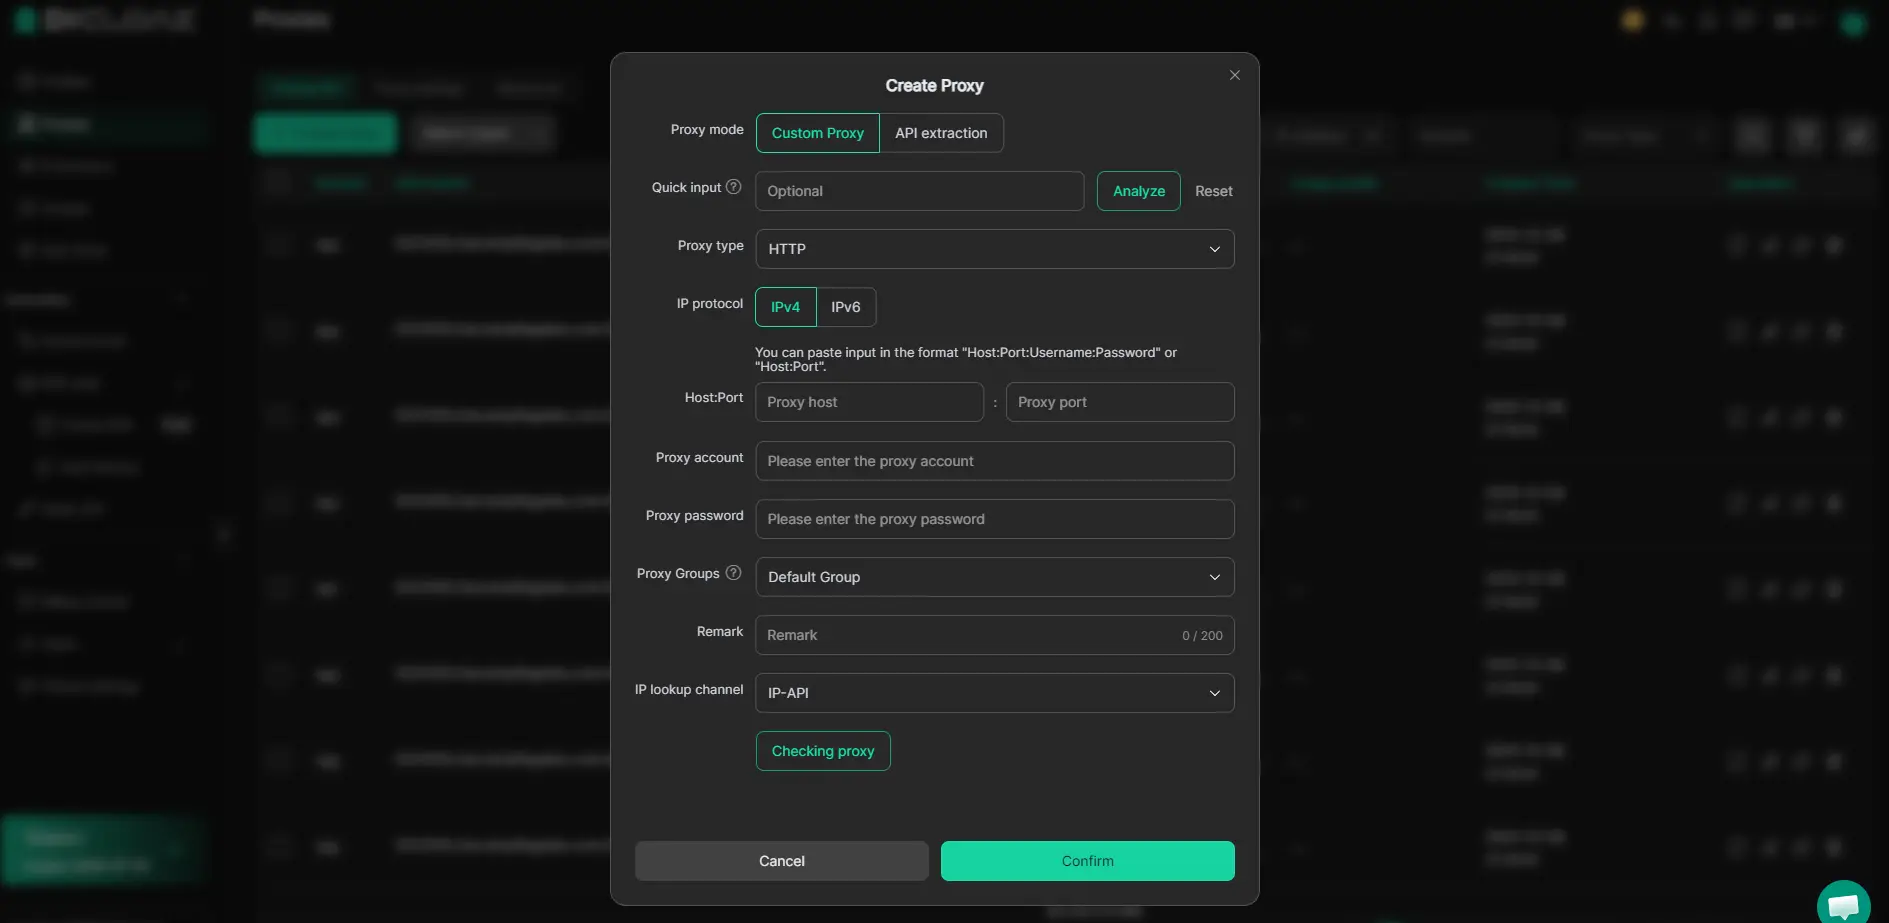
Si te saltas estos pasos de configuración, las filtraciones entre cuentas pueden aparecer sin ser detectadas; a continuación, cubriremos los errores comunes y cómo evitarlos.
Errores comunes al responder a regresiones del códex (y cómo evitarlas)
Muchos desarrolladores que notan regresiones en el Codex reaccionan demasiado rápido o se saltan comprobaciones de clave, lo que empeora las cosas. Aquí es donde la gente se equivoca y cómo esquivar las trampas habituales.
Sacar conclusiones precipitadas sin probar
Es fácil asumir que "el códex se volvió más tonto" significa un declive permanente, pero saltarse la solución de problemas básica hace perder tiempo. La mayoría de los fallos se deben a un error tipográfico, contexto faltante o actualización silenciosa del modelo; probar con un prompt conocido puede ahorrar horas.
Ignorar la seguridad y el cumplimiento al cambiar de herramienta
- Nunca reutilices contraseñas o claves API en nuevas herramientas de IA.
- Revisa los términos de cada herramienta antes de conectar cuentas de trabajo.
- Registra qué credenciales y datos de la empresa se utilizan por entorno.
Complicando demasiado tu flujo de trabajo
Probar tres nuevas herramientas de programación a la vez suele generar confusión y fugas. Antes de añadir una nueva herramienta, comprueba:
- ¿Puedes distinguir qué sesión es cuál en tu barra de tareas?
- ¿Tus carpetas de proyectos están claramente separadas por herramienta?
- ¿Documentaste qué herramienta se usó para cada commit de git?
Cuándo ceñirse a Codex, cambiar de herramienta o combinar enfoques
Si preguntas si aguantar un descenso de calidad en la codificación del códex o abandonar el barco, empieza por adaptar el problema a tus necesidades reales de flujo de trabajo, no solo a tu nivel de frustración. Un downgrade de herramienta se siente personal, pero la decisión correcta depende del riesgo y de cuánto te ralentice realmente el desliz.
Señales de que merece la pena seguir con Codex
| Escenario |
Quédate con Codex |
Por qué tiene sentido esto |
| La regresión es menor/temporal |
Sí |
Las pequeñas caídas suelen desaparecer tras las actualizaciones |
| Las alternativas interrumpen el flujo de trabajo |
Sí |
Cambiar puede costar más tiempo del que ahorra |
| Código no crítico, bajo riesgo |
Sí |
Si los errores son fáciles de corregir, las pequeñas gotas duelen menos |
Si la caída es molesta pero no bloquea, normalmente es más inteligente esperar a que se arregle que renovar todo tu stack.
Cuándo cambiar o complementar con otras herramientas
Cuando Codex empieza a fallar en los flujos de trabajo principales, o encuentras otra herramienta ajustada para tu stack o lenguaje específico, cambiar es el camino menos doloroso. Los errores persistentes que bloquean proyectos son la línea roja, no pierdas días esperando una solución que no llegará.
Combinar múltiples herramientas para maximizar la productividad
Mezclar herramientas funciona mejor cuando haces un seguimiento de qué asistente maneja qué tipo de código, no eches todas las tareas a cada IA. Toma notas de qué falla dónde, para poder enrutar las peticiones a la herramienta que realmente entrega. Esto evita el doble trabajo y mantiene la producción en movimiento.
Las preguntas frecuentes sobre el códex se volvieron más tontas
¿De verdad Codex se está volviendo más tonto o es solo mi experiencia?
Para saber si "el códex se volvió más tonto" es solo tú o un problema real, compara tus resultados recientes con ejemplos antiguos en las mismas tareas. Si notas más errores o menos sugerencias útiles, consulta foros online para quejas similares. A veces, los cambios o actualizaciones en el flujo de trabajo en tu entorno también pueden afectar a los resultados, no solo al modelo del códex en sí.
¿Qué debería hacer si Codex empeora de repente en mis tareas principales de programación?
Primero, prueba a usar Codex con indicaciones simples y claras para ver si el problema es específico de tu proyecto actual. Prueba en otro navegador o dispositivo. Consulta actualizaciones recientes en tus herramientas de programación o en Codex mismo. Si el descenso continúa, considera compartir comentarios con OpenAI y buscar soluciones alternativas que otros hayan encontrado.
¿Puede el uso de proxies o perfiles de navegador separados mejorar el rendimiento del Codex?
Los proxies y los perfiles separados del navegador ayudan a mantener separados tus proyectos laborales y personales. No mejoran la calidad del código central del códex ni abordan la regresión de IA del códex. Estas herramientas pueden facilitar la resolución de problemas aislando variables, pero no solucionarán una caída real de rendimiento en el códex.
¿Existen riesgos al cambiar entre varias herramientas de codificación con IA?
Sí, usar varias herramientas de codificación por IA puede confundir tu flujo de trabajo y aumentar la posibilidad de confusión de datos. Los riesgos de seguridad y cumplimiento también aumentan si compartes código o credenciales sensibles entre plataformas. Revisa siempre la configuración de privacidad y los términos de uso de cada herramienta antes de cambiar.
¿Cómo puedo mantener mis cuentas y entornos de programación seguros cuando uso varias herramientas de IA?
Utiliza cuentas y perfiles de navegador separados para cada herramienta. Nunca compartas contraseñas o tokens entre ellas. Guarda las credenciales en un gestor de contraseñas. Cierra sesión regularmente y borra las cookies. Evita subir código sensible a menos que confíes en la seguridad de la plataforma. Revisa siempre la configuración de permisos en tus entornos de programación.
Dadas estas recientes modificaciones, es un buen momento para reevaluar tu herramienta actual y buscar soluciones que se ajusten mejor a tus necesidades de flujo de trabajo. Si estás listo para explorar alternativas que mantengan tu productividad en marcha, considera probar DICloak. Prueba DICloak gratis
 Herramientas gratuitas
 Complemento de cookies
 Generador UA
 Generador de direcciones MAC
 Generador de IP
 Lista de direcciones IP
 Generador de código 2FA
 Reloj Mundial
 Cheque Anónimo
 WebRTC Leak Test
 Generador UUID
 Verificador de Proxy
 Verificador de anuncios de Facebook
 Raspado web con IA
 Herramientas SMM Gratis
 Verificador de Sombreado de Twitter
 Generador UTM
 Generador de usernames
 Generador de hashtags con IA
 Generador de titulares para LinkedIn
 Redimensionador de imágenes sociales