Escreves um prompt, o Codex sai cinco linhas de Python quebrado e, de repente, o teu fluxo de trabalho diário está mais lento do que há um ano. Se reparaste que o codex ficou mais burro em tarefas que antes dominava, como escrever scripts básicos ou corrigir bugs simples, não estás sozinho. As queixas sobre a queda de desempenho do codex e a diminuição da qualidade da programação estão por todo o lado, mas ninguém dá uma resposta clara sobre o que realmente mudou.
Alguns dizem que é só imaginação, ou que os prompts ficaram mais descuidados, mas isso não corresponde ao padrão. Regressões reproduzíveis aparecem mesmo em bases de código bem documentadas. O risco não é apenas um incómodo menor; se dependes do Codex para código de produção, mesmo uma pequena queda na precisão das sugestões pode significar horas de depuração manual ou prazos perdidos.
A verdadeira história tem menos a ver com o tamanho bruto do modelo e mais sobre alterações nos dados de treino, políticas de alinhamento e como o Codex é atualizado nos bastidores. As mudanças destinadas a tornar a IA "mais segura" ou mais geral muitas vezes eliminam os casos limites que antes tornavam o Codex genuinamente útil para utilizadores avançados. Se está a ver respostas mais genéricas e menos úteis, não está a imaginar, a regressão do modelo é um problema real e rastreável para os programadores.
Então, o que está realmente a causar a perda de qualidade e o que pode fazer quanto a isso? É aqui que os problemas começam a aparecer.
Porque é que tantos utilizadores dizem que a Codex ficou mais burra em 2026?
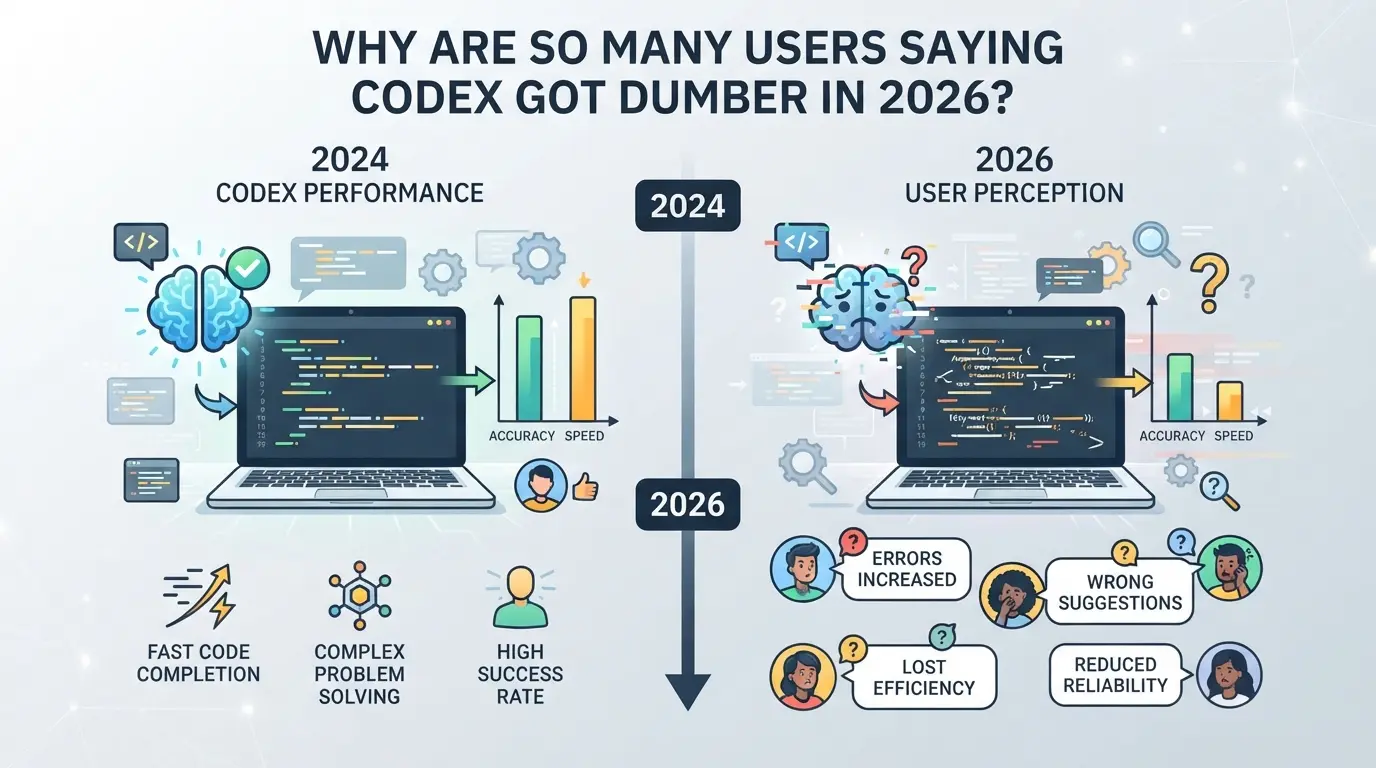
As queixas sobre a qualidade da programação do Codex não são apenas mais evidentes, vêm de programadores experientes que dependiam de sugestões precisas e conscientes do contexto. Os utilizadores agora relatam conclusões mais genéricas, código fora do tópico e até bugs antigos que foram corrigidos em versões anteriores.
Queixas Comuns: O que os Utilizadores Estão a Reportar
As pessoas apontam que o Codex está a esquecer contexto recente em projetos multi-ficheiros, a nomear mal variáveis e a repetir blocos de código que não se encaixam no prompt. Tarefas simples como stubs de API REST ou análise de dados agora recebem respostas padrão em vez de código funcionalmente correto.
Possíveis Gatilhos: Atualizações, Alterações de Modelo ou Alterações de Uso?
A queda está ligada a grandes atualizações do Codex lançadas no final de 2025 e início de 2026. Estas atualizações focaram-se em prevenir sugestões arriscadas e alargar a base de código para suportar mais linguagens, mas também eliminaram padrões de código de nicho dos quais dependiam os utilizadores avançados. Quando uma atualização de modelo deixa de suportar lógica de casos extremos, tarefas que funcionavam bem no ano passado recebem de repente respostas vagas ou incompletas. Os programadores que usam o Codex diariamente para prototipagem rápida ficam especialmente frustrados: após uma atualização, uma tarefa que antes exigia dois prompts agora precisa de cinco ou seis, se é que alguma vez funciona. Adicione o aumento do volume de utilizadores e políticas de alinhamento mais rigorosas, e não é surpresa que as pessoas digam que o Codex ficou mais burro. O ponto de dor não é apenas a perda de velocidade; é a erosão da confiança em saber se a ferramenta "se lembra" de como trabalha dia após dia.
Separar a Perceção da Realidade
- Se o seu caso de uso mudar (por exemplo, projetos maiores ou novas linguagens), espera-se algum declínio.
- Desabafar na comunidade, como tópicos no Reddit, pode fazer com que as regressões pareçam maiores do que realmente são.
- Quando esperas resultados mais inteligentes, até pequenos erros parecem piores; a frustração aumenta rapidamente.
O que importa agora é aprender a verificar se o seu fluxo de trabalho é realmente afetado, e não apenas pelo ruído online. Esse é o próximo passo.
Como podes saber se o Codex está realmente a ter um desempenho pior para as tuas tarefas?
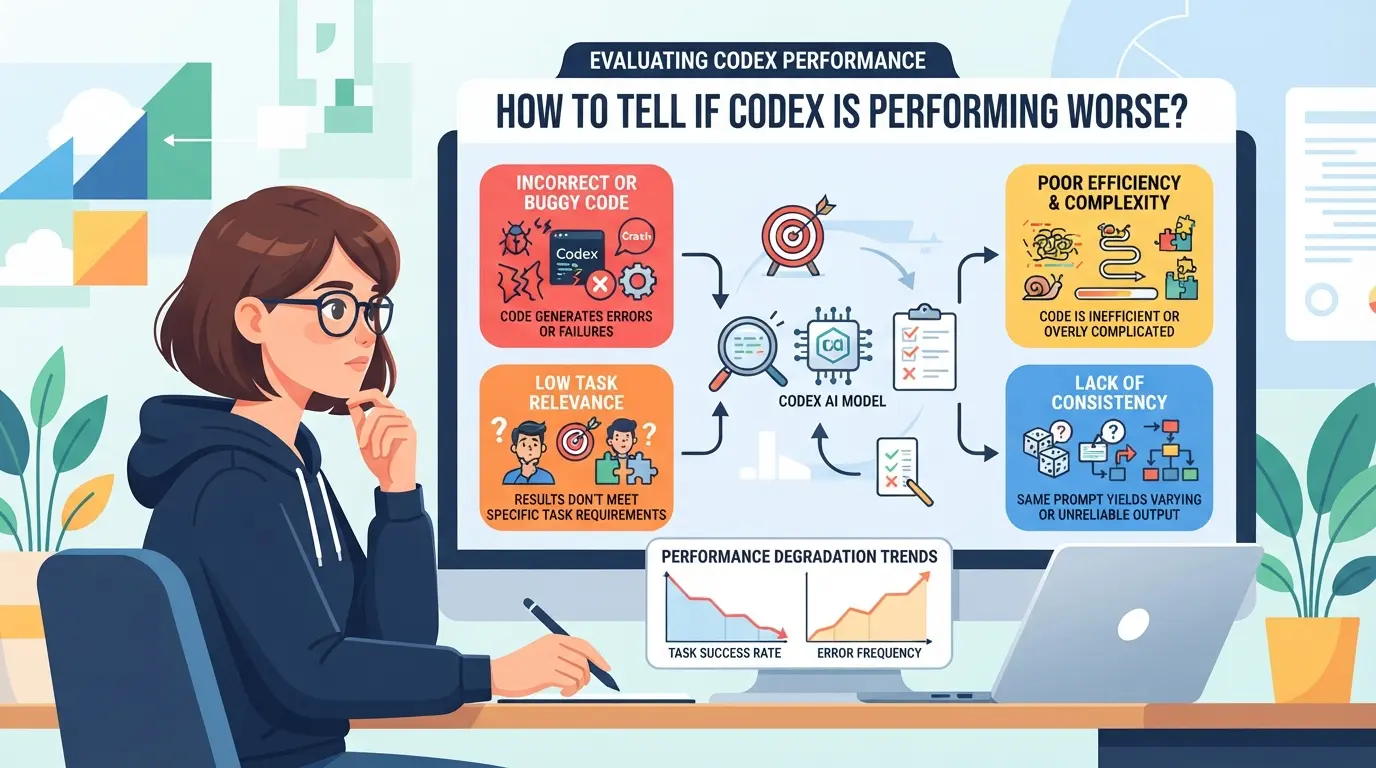
Se achas que o Codex está a piorar, precisas de provas, não apenas de um pressentimento. Muitos programadores queixam-se que "o Codex ficou mais burro", mas a maioria nunca executa o mesmo prompt duas vezes ou acompanha o que mudou. Aqui está como verificar se a ferramenta é realmente a responsável pela tua carga de trabalho de programação.
Configuração de Testes de Código Controlado
A única forma de saber se a qualidade do Codex caiu nas tuas tarefas é executar testes lado a lado. Escolhe um conjunto de prompts que correspondam ao teu trabalho diário, correções reais de bugs, refatorações ou geração de boilerplate. Insere-os no Codex e, se possível, numa versão antiga do Codex ou num modelo concorrente. Usa sempre o mesmo contexto de código e definições. Se não mantiveres o prompt, seed e ambiente idênticos, não podes culpar o Codex por diferenças aleatórias.
Acompanhamento dos Padrões de Regressão ao Longo do Tempo
Se continuares a ver as mesmas falhas, está na altura de as registar. A regressão normalmente aparece como problemas repetíveis, não como erros aleatórios. Usa esta mini-lista de verificação para apanhar recusas reais:
- Guarda todas as falhas concluídas com o carimbo temporal e a versão do Codex.
- Etiqueta cada problema por linguagem, framework ou tarefa (por exemplo, API stub, caso de teste).
- Compare os novos erros com os seus registos antigos, este bug exato apareceu no mês passado?
Quando culpar o Codex vs. Engenharia de Prompts
É fácil pensar que o Codex avariou, quando na verdade o teu prompt mudou ou o contexto ficou mais confuso. Antes de culpar o modelo, verifica estas armadilhas comuns:
- Adicionaste, removeste ou reorganizaste comentários ou blocos de código mesmo antes do prompt?
- Está agora a usar um novo framework, biblioteca ou sintaxe que o Codex não foi treinado?
- Encurtaste o teu prompt ou ignoraste um exemplo chave que o Codex usou para ver?
Se corrigir erros nos prompts e os testes ainda falharem, provavelmente está a ver uma regressão real do Codex. Se não, o modelo provavelmente está apenas a responder a um pedido mais vago.
O passo seguinte é investigar o que causa estas regressões, atualizações de modelos, alterações de dados ou outra coisa qualquer. É aí que as respostas reais começam a aparecer.
O que faz com que ferramentas de programação por IA como a Codex fiquem mais burras?
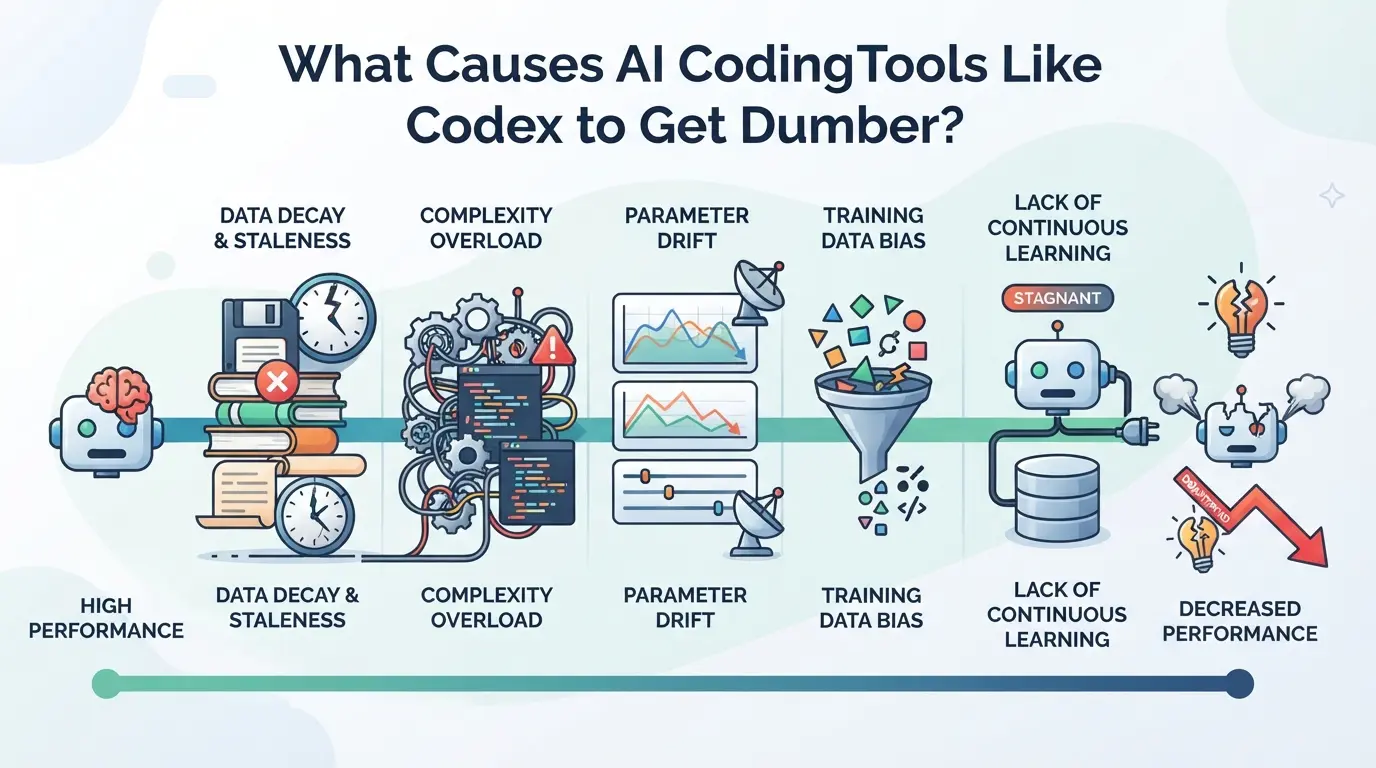
A maioria das quedas na qualidade do Codex deve-se a mudanças nos bastidores, novos dados, regras mais rigorosas ou atalhos técnicos. Raramente é um único bug. Se reparaste que o Codex ficou mais estúpido, estás a ver os efeitos secundários destas trocas.
Atualizações de Modelos e Alterações de Dados de Treino
Quando o Codex é retreinado com dados novos, o modelo pode perder padrões antigos e específicos que antes o tornavam nítido em casos extremos. Os esforços para "melhorar a fiabilidade" muitas vezes significam que o sistema agora faz a média do código de utilizador diversificado, pelo que soluções únicas ou inteligentes são filtradas. É por isso que os seus antigos prompts podem agora ser respostas insípidas e genéricas.
Decisões Empresariais e de Política
As ferramentas de IA não são apenas moldadas por engenheiros, são guiadas por equipas de risco e conformidade de negócio. Atualizações destinadas a manter o Codex "seguro" contra queixas de direitos de autor ou conteúdos ofensivos muitas vezes cortam exemplos inteiros de código. Por exemplo, se uma empresa apertar os filtros para evitar problemas legais, de repente receberá mais recusas ou conselhos vagos em vez de completar código direto. Isto é ainda mais provável se um incidente de alta visibilidade levar a empresa a reagir de forma geral. Os compromissos aqui podem ser severos: proteger a marca por vezes significa que o modelo salta técnicas de codificação avançadas, mas sensíveis. Mudanças de recursos também podem prejudicar; se a empresa deixar de priorizar o Codex, pode ver correções de bugs mais lentas ou menos investimento na qualidade do modelo. Se a sua ferramenta de programação de IA começar a evitar perguntas que antes respondia, é quase sempre sinal de que os filtros de segurança ou políticas se tornaram mais rigorosos.
Desafios de Dívida Técnica e Escalabilidade
- Infraestruturas atrasadas: Se os servidores não conseguirem acompanhar, a latência aumenta e as completações de código são truncadas ou eliminadas.
- Atalhos de escalabilidade: O crescimento rápido de utilizadores pode obrigar a equipa a reduzir o tamanho do modelo ou a usar versões mais leves.
- Testes de lacunas: Lançamentos apressados sob escalabilidade pesada frequentemente saltam verificações profundas de regressão, permitindo que novos erros escapem.
Estes fatores combinam-se para explicar não só porque é que o desempenho do Codex diminui, mas também porque é que as correções não são rápidas ou previsíveis. Se vês mais erros ou código menos útil, normalmente é porque algo a montante mudou, muitas vezes por razões fora da engenharia pura.
Como Adaptar o Seu Fluxo de Trabalho de Programação quando a Qualidade do Codex Cai
Se o desempenho do Codex cair, enfrente isso de frente: ajuste o seu fluxo de trabalho para não perder tempo ou enviar código com bugs. As mudanças certas mantêm-no produtivo, mesmo quando as sugestões pioram.
Diversificar o Seu Conjunto de Ferramentas de IA
- Experimenta pelo menos um assistente de programação alternativo (como Copilot, StarCoder ou modelos open-source). Se o Codex não for suficiente, uma comparação direta é a forma mais rápida de ver se algo funciona melhor para a tua stack.
- Combina ferramentas de IA com o teu IDE ou linter padrão. Não troques apenas de ferramentas, executa ambos em paralelo. Isto ajuda-te a detetar problemas de estilo ou falhas de lógica que as saídas da IA frequentemente introduzem.
- Documenta qual ferramenta ou combinação resolve os teus verdadeiros pontos problemáticos. Mantém um registo simples: "Copilot melhor com refatoração, Codex melhor com docstrings." Isto impede-te de saltar entre ferramentas sem um plano.
- Fique atento a quedas súbitas em qualquer ferramenta. O mesmo ciclo de atualização que piorou o Codex pode afetar outros a seguir, por isso mantém as alternativas avaliadas e prontas.
Melhorar a Engenharia Rápida e os Processos de Revisão
- Quando o Codex começar a perder o essencial, reduz os prompts. Use assinaturas específicas de funções, dê casos de teste e indique versões na linguagem, isto reduz o foco da IA.
- Revê sempre o código gerado antes de o executar, especialmente em casos extremos. Se as sugestões do Codex costumavam "simplesmente funcionar" mas agora falham nos testes, assume que cada saída precisa de uma análise mais detalhada.
- Se continuares a receber código fraco ou fora do alvo, reescreve o teu prompt e repete. Uma alteração tão pequena como "usar sintaxe Python 3.10" pode forçar uma resposta melhor.
- Combine a revisão manual de código com a saída da IA. Mesmo que a revisão o atrase, poupa horas perdidas em erros lógicos silenciosos.
Gestão de Configurações Multi-Conta ou Multi-Ambiente
- Configura perfis de navegador ou sandboxes separados para cada ferramenta de IA ou conta Codex. Isto mantém o teu histórico de trabalho e ferramentas limpo, por isso, se uma ferramenta regredir, não vai poluir as restantes.
- Acompanha qual ambiente e login produziram cada grande alteração de código. Se aparecer um bug, saberás qual ferramenta o criou, não apenas qual linha quebrou.
- Se notares um comportamento estranho, como código que compila mas falha em tempo de execução, verifica se veio de uma ferramenta com outra conta. A contaminação cruzada é um risco real ao mudar de ferramenta.
- Roda os ambientes se um deles começar a atrasar ou a dar erros. Por vezes, simplesmente mudar para um perfil novo corrige sessões de IA "presas" que devolvem sugestões repetidas ou estagnadas.
Como Separar De Forma Segura Ambientes de Programação e Contas ao Utilizar Múltiplas Ferramentas de IA
Riscos de misturar contas e sessões
Misturar sessões de programação ou contas de ferramentas de IA no mesmo perfil de navegador pode revelar cookies, expor chaves API ou ativar avisos de plataforma. O histórico de login cruzado é uma razão comum para os utilizadores serem subitamente sinalizados ou limitados pela taxa.
Boas Práticas para o Isolamento Ambiental
Use perfis de navegador separados, ou melhor, navegadores independentes, para cada conta de codificação ou ferramenta. Atribua um proxy único a cada perfil se estiver a tratar de tarefas sensíveis ou específicas de região. Isto evita que dados de sessão e impressões digitais de rede se espalhem entre ambientes.
Quando Considerar Ferramentas Avançadas para o Isolamento
- Geres 3+ ferramentas de IA ou múltiplos logins de utilizadores diariamente
- Trabalha em equipa com dispositivos ou perfis partilhados
- Bloqueios de plataformas ou pedidos de verificação repetidos começam a aparecer
Como usar o DICloak para ambientes de codificação isolados e configuração de proxy
Se precisar de manter as sessões de programação ou contas de plataforma verdadeiramente separadas, especialmente depois de notar problemas como o codex que ficou mais estúpido ou quedas de qualidade de IA específicas da plataforma, o DICloak oferece às equipas uma forma estruturada de isolar ambientes e saídas de rede. Esta secção mostra como os operadores podem usar o DICloak para configurar perfis de navegador distintos e proxies de utilizador para cada ferramenta ou conta, sem risco de sobreposição ou sinais partilhados.
Configuração de Perfis de Navegador Separados e Configuração de Impressões Digitais no DICloak
Os operadores podem criar um novo perfil de navegador no DICloak para cada ambiente de codificação ou conta, e depois ajustar as definições das impressões digitais, como User Agent, sistema operativo, fuso horário e resolução do ecrã, para corresponder ao caso de uso pretendido. Este fluxo de trabalho mantém o armazenamento e os sinais de identificação do navegador completamente separados entre sessões, pelo que a alternância entre ferramentas de IA ou contas de plataforma não desfoca as fronteiras. O âmbito aqui limita-se ao isolamento ao nível do navegador; não altera a ferramenta de codificação ligada nem gere as próprias contas. 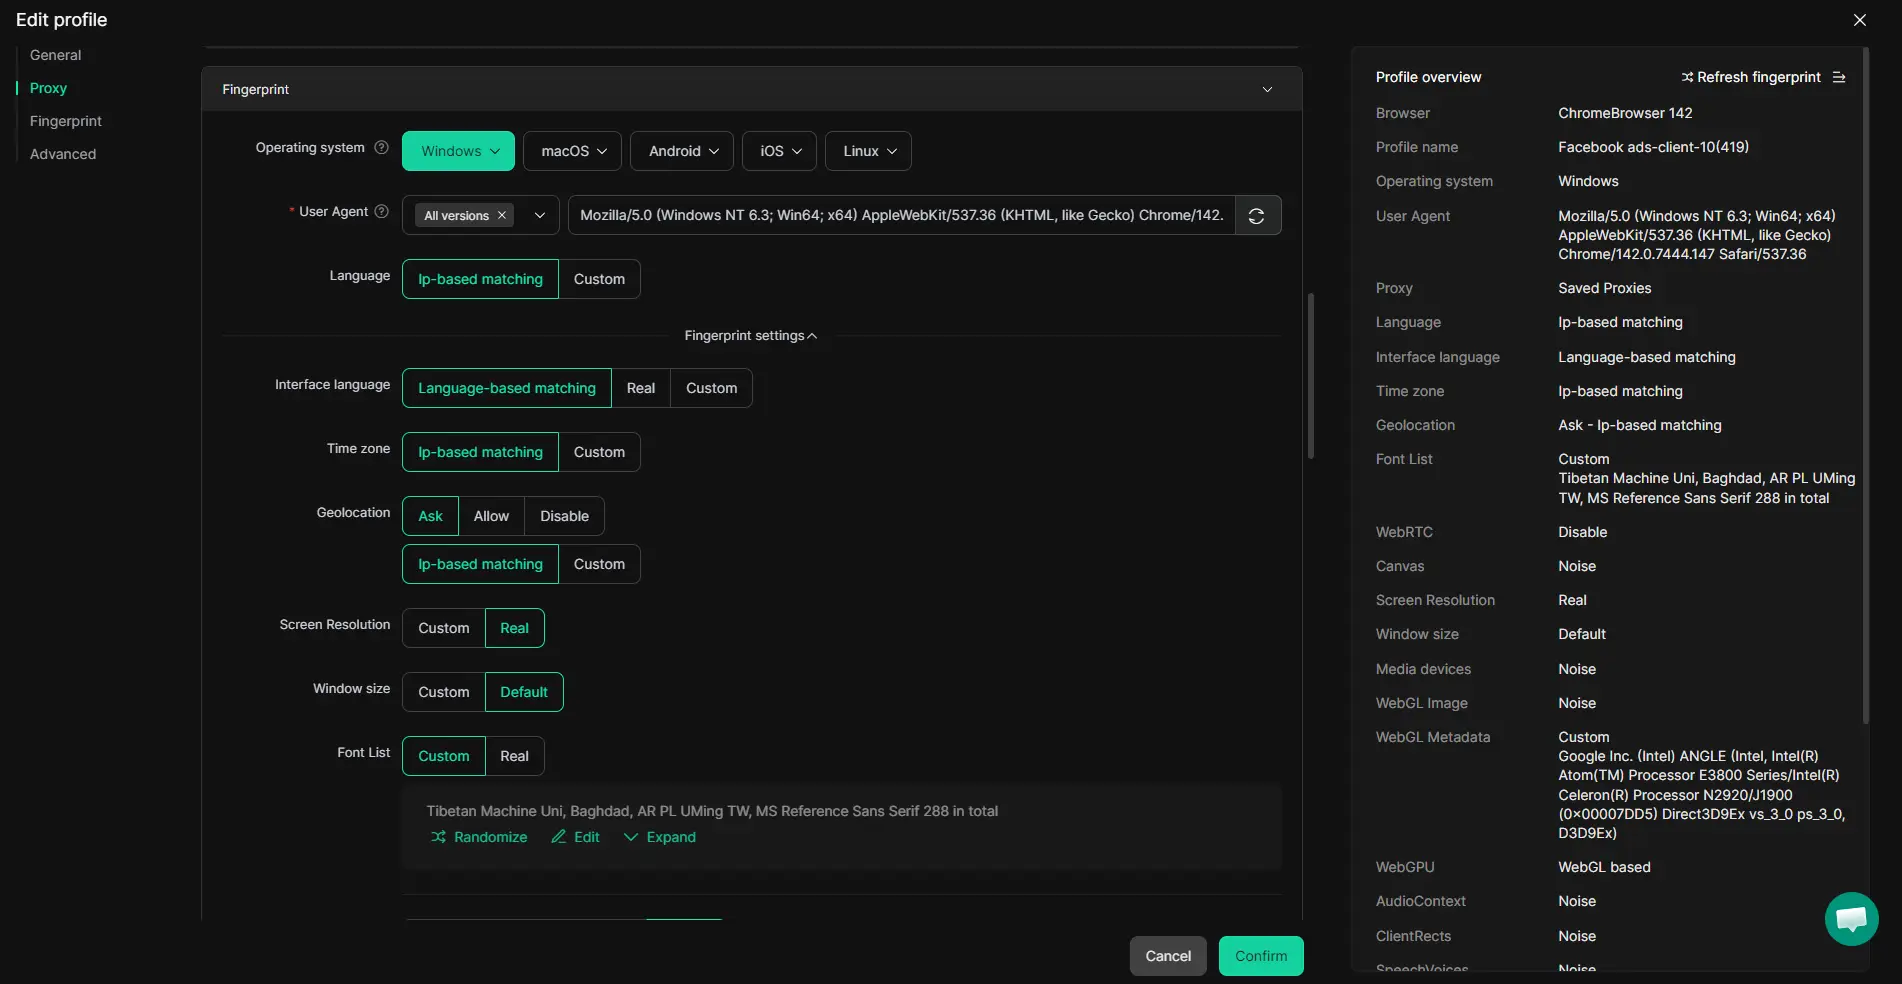
Configuração de Proxies Pertencentes ao Utilizador para Cada Perfil
Para fluxos de trabalho onde diferentes contas ou sessões de codificação precisam da sua própria saída de rede, os operadores podem configurar uma ligação proxy separada em cada perfil DICloak. Pode introduzir os seus próprios dados de proxy, testá-los diretamente na configuração do perfil e confirmar a localização da rede antes de usar esse perfil para trabalhos de programação. O DICloak armazena estas definições por perfil, mas nunca vende nem fornece proxies; a seleção e qualidade continuam da sua responsabilidade. 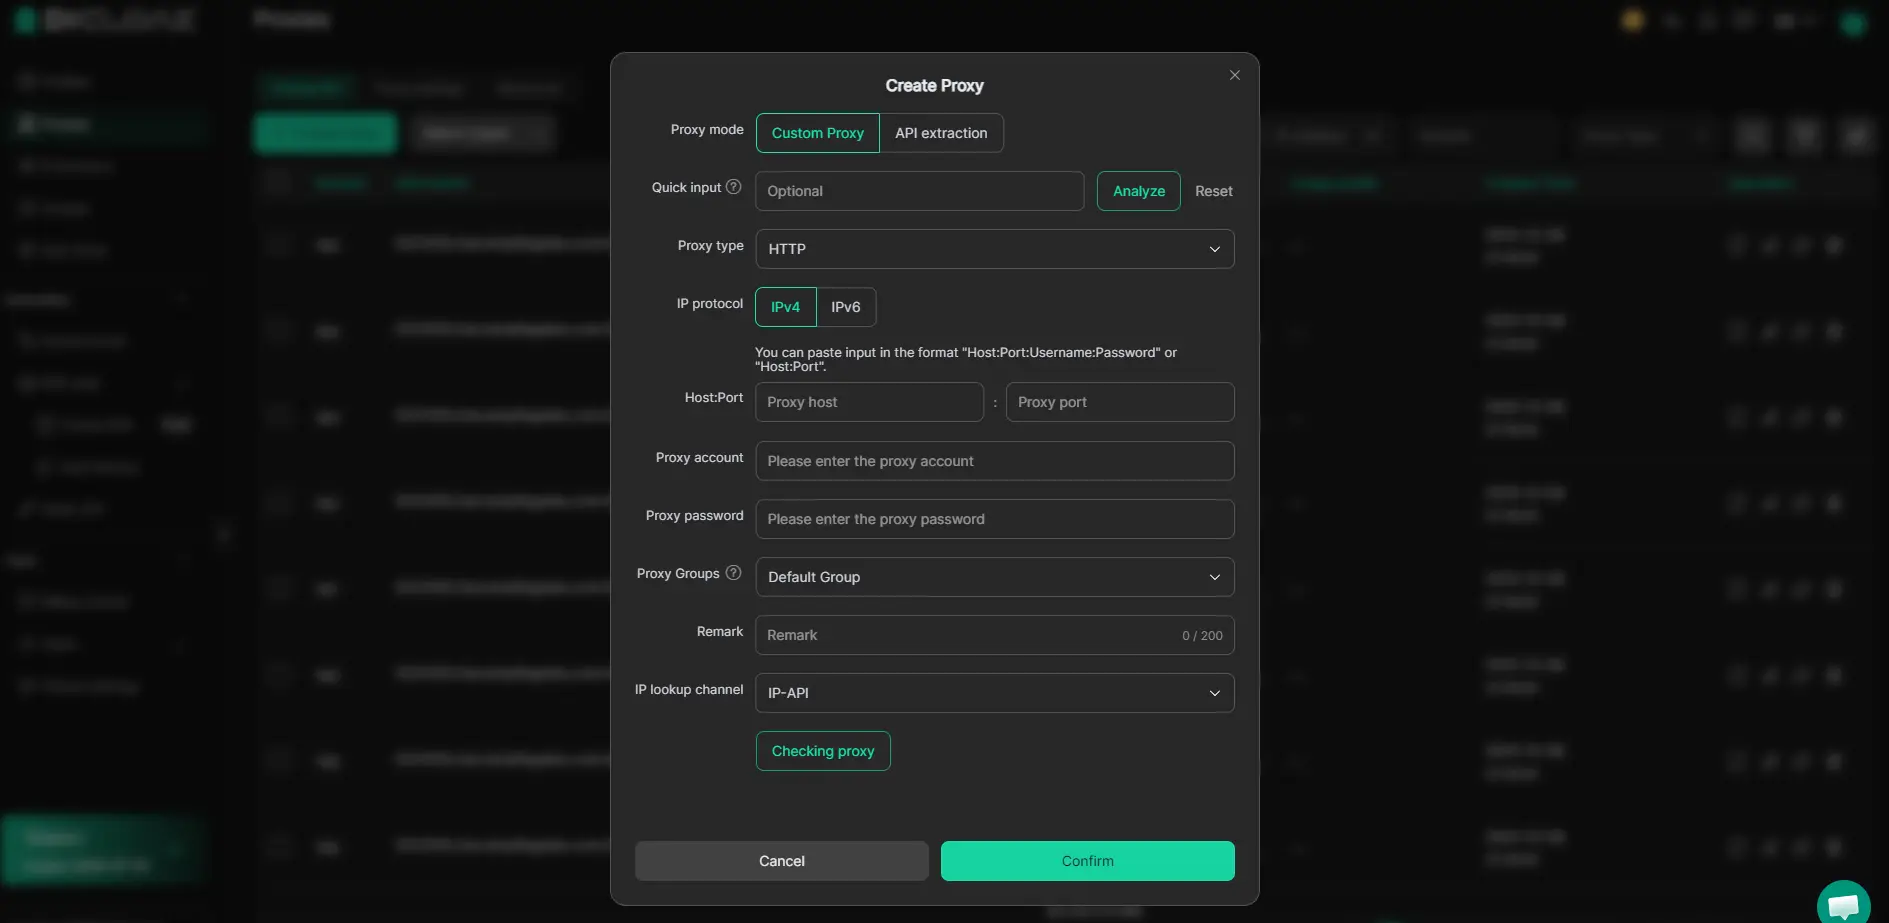
Se saltar estes passos de configuração, fugas entre contas podem surgir despercebidas; a seguir, vamos abordar os erros comuns e como os evitar.
Erros Comuns ao Responder a Regressões do Codex (e Como Evitá-los)
Muitos programadores que notam regressões no Codex reagem demasiado rápido ou saltam verificações de chaves, piorando as coisas. É aqui que as pessoas tropeçam e como evitar as armadilhas habituais.
Tirar conclusões precipitadas sem testar
É fácil assumir que "o codex ficou mais burro" significa declínio permanente, mas saltar a resolução de problemas básica faz perder tempo. A maioria das falhas tem origem num erro de digitação no prompt, contexto em falta ou atualização silenciosa do modelo; testar com um prompt conhecido como bom pode poupar horas.
Ignorar a Segurança e a Conformidade ao Mudar de Ferramenta
- Nunca reutilize palavras-passe ou chaves API em novas ferramentas de IA.
- Verifique os termos de cada ferramenta antes de ligar contas de trabalho.
- Registe quais as credenciais e dados da empresa usados por ambiente.
Complicar em Demais o Seu Fluxo de Trabalho
Experimentar três novas ferramentas de programação ao mesmo tempo muitas vezes leva a confusão e fugas. Antes de adicionar uma nova ferramenta, verife:
- Consegues identificar qual sessão é qual na tua barra de tarefas?
- As pastas do teu projeto estão claramente separadas por ferramenta?
- Documentaste que ferramenta foi usada para cada commit git?
Quando manter o Codex, mudar de ferramenta ou combinar abordagens
Se estás a perguntar se deves aguentar um declínio na qualidade da programação do códice ou mudar de barco, começa por adaptar o problema às tuas necessidades reais de fluxo de trabalho, não apenas ao teu nível de frustração. Um downgrade de ferramenta parece pessoal, mas a decisão certa depende do risco e de quanto o deslize realmente te atrasa.
Sinais de que vale a pena manter-se com Codex
| Cenário |
Fique com o Codex |
Porque é que isto faz sentido |
| A regressão é menor/temporária |
Sim |
Pequenas quedas frequentemente resolvem-se após as atualizações |
| Alternativas perturbam o fluxo de trabalho |
Sim |
Mudar pode custar mais tempo do que poupa |
| Código não crítico, baixo risco |
Sim |
Se erros são fáceis de corrigir, pequenas gotas doem menos |
Se a queda for irritante mas não bloquear, normalmente é mais inteligente esperar por uma solução do que reformular toda a stack.
Quando trocar ou complementar com outras ferramentas
Quando o Codex começa a falhar nos fluxos de trabalho principais, ou encontra outra ferramenta ajustada para a sua stack ou linguagem específica, mudar é o caminho menos doloroso. Erros persistentes que bloqueiam projetos são a linha vermelha, não perca dias à espera de uma solução que não está a chegar.
Misturar Múltiplas Ferramentas para Máxima Produtividade
Misturar ferramentas funciona melhor quando acompanhas qual assistente trata de que tipo de código, não passes todas as tarefas a todas as IAs. Mantém notas do que falha onde, para poderes encaminhar pedidos para a ferramenta que realmente entrega. Isto evita trabalho duplo e mantém a produção em movimento.
Perguntas Frequentes Sobre o Codex ficaram mais estúpidas
Será que a Codex está mesmo a ficar mais burra, ou é só a minha experiência?
Para perceberes se "o códex ficou mais burro" é só tu ou um problema real, compara os teus resultados recentes com exemplos antigos nas mesmas tarefas. Se notares mais erros ou menos sugestões úteis, consulta fóruns online para queixas semelhantes. Por vezes, alterações ou atualizações no fluxo de trabalho no teu ambiente também podem afetar resultados, não só o modelo do códex em si.
O que devo fazer se o Codex piorar subitamente nas minhas principais tarefas de programação?
Primeiro, experimente usar o Codex com prompts simples e claros para ver se o problema é específico do seu projeto atual. Teste num navegador ou dispositivo diferente. Verifique atualizações recentes nas suas ferramentas de programação ou no próprio Codex. Se o declínio continuar, considere partilhar feedback com a OpenAI e procurar soluções alternativas que outros tenham encontrado.
A utilização de proxies ou perfis de navegador separados pode melhorar o desempenho do Codex?
Proxies e perfis de navegador separados ajudam a manter o seu trabalho e projetos pessoais separados. Não melhoram a qualidade da codificação do Codex principal nem abordam a regressão de IA do codex. Estas ferramentas podem facilitar a resolução de problemas ao isolar variáveis, mas não vão corrigir uma queda real de desempenho no codex.
Existem riscos em alternar entre várias ferramentas de codificação de IA?
Sim, usar várias ferramentas de codificação por IA pode confundir o seu fluxo de trabalho e aumentar a probabilidade de confundir dados. Os riscos de segurança e conformidade também aumentam se partilhar código ou credenciais sensíveis entre plataformas. Verifique sempre as definições de privacidade e os termos de utilização de cada ferramenta antes de mudar.
Como mantenho as minhas contas e ambientes de programação seguros ao usar várias ferramentas de IA?
Use contas e perfis de navegador separados para cada ferramenta. Nunca partilhe palavras-passe ou tokens entre elas. Armazene as credenciais num gestor de palavras-passe. Faça logout regularmente e limpe os cookies. Evite carregar código sensível a menos que confie na segurança da plataforma. Revise sempre as definições de permissões nos seus ambientes de programação.
Dadas estas mudanças recentes, é um bom momento para reavaliar as suas ferramentas atuais e procurar soluções que melhor se alinhem com as suas necessidades de fluxo de trabalho. Se estiver pronto para explorar alternativas que mantenham a sua produtividade no caminho certo, considere experimentar o DICloak. Experimente o DICloak Gratuitamente
 Ferramentas Gratuitas
 Cookie Plugin
 Gerador de UA
 Gerador de Endereço MAC
 Gerador de Endereço IP
 Lista de Endereços IP
 Gerador de Código 2FA
 Relógio Mundial
 Verificação de Anonimato
 WebRTC Leak Test
 Gerador de UUID
 Verificador de Proxy
 Verificador de Anúncios FB
 Coleta Web com IA
 Ferramentas SMM Grátis
 Verificador de Shadowban do Twitter
 Verificador de Nomes do Instagram
 Gerador UTM
 Gerador de nomes de usuário
 Gerador de hashtags com IA
 Gerador de títulos para LinkedIn
 Redimensionador de imagens sociais