YouTube contient une énorme quantité d’informations publiques pouvant soutenir la recherche de contenu, le suivi des concurrents, l’analyse d’audience et l’étude de marché. Les titres des vidéos, descriptions, vues, commentaires, informations sur les chaînes, dates de mise en ligne et transcriptions disponibles peuvent tous révéler des schémas utiles. Le problème, c’est que collecter ces informations à la main devient irréaliste lorsque vous avez besoin de données provenant de centaines voire de milliers de vidéos.
Un YouTube Scraper aide à transformer ce travail en un processus structuré. Au lieu d’ouvrir chaque vidéo et de copier les informations dans un tableur, un outil de scraping peut collecter certains champs et les enregistrer sous forme CSV, JSON ou un autre format. Selon le projet, les utilisateurs peuvent choisir des outils de scraping YouTube sans code, des API scraper, des bibliothèques Python ou l’API officielle YouTube Data.
Avant d’utiliser toute méthode, il est important de comprendre les règles de YouTube. Les politiques de développement d’API de YouTube stipulent que les clients API ne doivent pas extraire les applications YouTube ni obtenir de données YouTube extraites, sauf lorsque les règles de YouTube le permettent spécifiquement. Si les informations dont vous avez besoin sont déjà disponibles via l’API officielle, c’est généralement la première option à vérifier.
Si vous débutez dans ce type de collecte de données, comprendre d’abord les concepts de base du web scraping peut également être utile. Le reste de ce guide se concentre sur le fonctionnement d’un YouTube Scraper , les outils utiles en 2026, comment collecter différents types de données YouTube, et les problèmes à prévoir.
Qu’est-ce qu’un YouTube Scraper et quelles données peut-il extraire ?
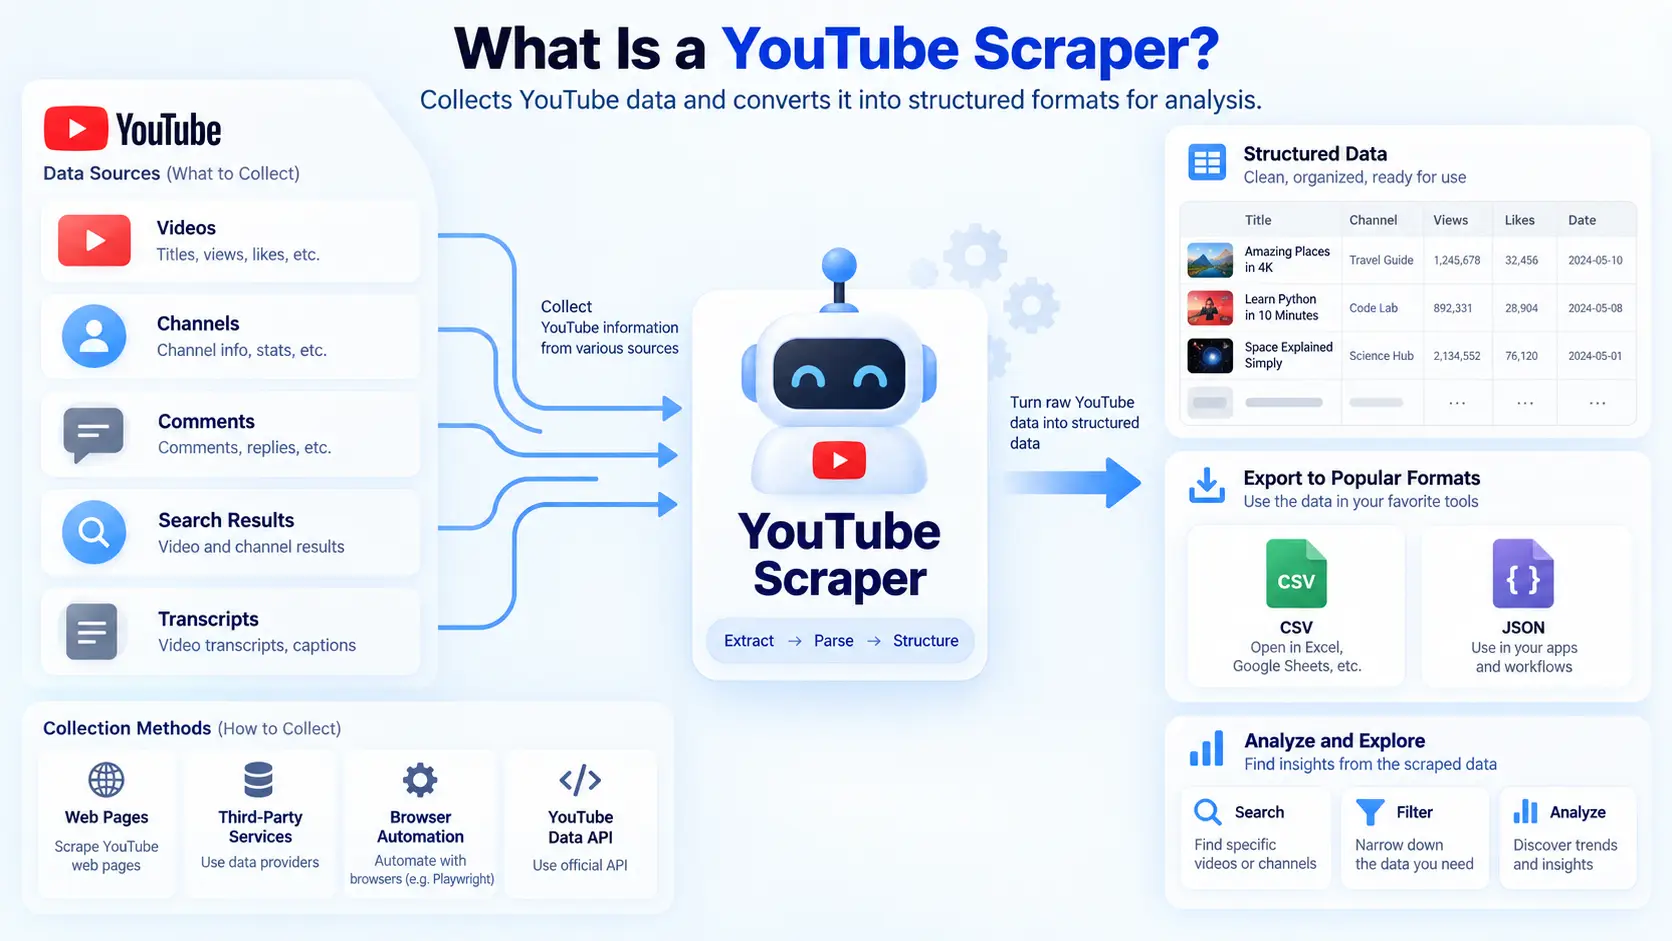
Un YouTube Scraper est un outil ou un script qui collecte des informations liées aux vidéos YouTube, chaînes, commentaires, résultats de recherche ou transcriptions. Les données collectées sont généralement converties en un format structuré afin de pouvoir être recherchées, filtrées ou analysées. Cela peut faire gagner beaucoup de temps lorsque le projet implique plus de données qu’une personne ne pourrait raisonnablement copier à la main.
Tous les scrapers ne fonctionnent pas de la même manière. Certains outils lisent les informations des pages web YouTube, tandis que d’autres utilisent des services tiers ou l’automatisation des navigateurs. L’API officielle YouTube Data adopte une approche différente en donnant aux développeurs un accès documenté aux ressources YouTube prises en charge.
Comment fonctionne un scraper YouTube
La plupart des flux de travail du YouTube Scraper commencent par une entrée. Cette entrée peut être une URL de vidéo, une URL de canal, une playlist, un mot-clé ou une liste d’identifiants de vidéo. Le scraper recherche ensuite des champs spécifiques, extrait les valeurs et les enregistre dans un résultat structuré.
Imaginez qu’une équipe marketing veuille étudier 300 vidéos sur des outils d’écriture par IA. Ouvrir chaque vidéo manuellement prendrait des heures, et l’équipe pourrait facilement manquer des détails ou copier incorrectement des chiffres. Un scraper peut collecter des champs tels que le titre de la vidéo, le nom de la chaîne, la date de publication, les vues, les likes, la description et l’identifiant de la vidéo dans un seul flux de travail répétable.
Certains outils de scraping YouTube fonctionnent directement via le site web. D’autres utilisent des API pour demander des données structurées. L’API officielle YouTube Data API, par exemple, fournit des points de terminaison pour les vidéos, les chaînes, les playlists, les commentaires et les fils de commentaires. La videos.list méthode peut renvoyer des champs tels que titre, description, identifiant de chaîne, tags et statistiques lorsque ces parties sont demandées.
La différence est importante car les outils basés sur les pages dépendent de la manière dont les pages YouTube sont construites. Si YouTube modifie la structure de sa page ou le flux interne de données, un scraper peut devoir être mis à jour. Les méthodes basées sur l’API retournent généralement des données structurées plus propres, mais elles sont accompagnées de quotas, d’autorisations et de règles de plateforme.
Quelles données YouTube peuvent être extraites ?
Le type de données que vous pouvez collecter dépend de l’outil. Pour la recherche vidéo, les champs courants incluent les titres vidéo, les descriptions, les URL, les identifiants vidéo, les noms de chaînes, les dates de publication, les durées, les vues, les likes, le nombre de commentaires, les tags et les catégories. Ces champs peuvent soutenir l’analyse de contenu, la recherche thématique et la surveillance des concurrents.
Les commentaires sont une autre cible fréquente. Un scraper de commentaires YouTube peut collecter le texte des commentaires, les noms d’utilisateur, les dates, le nombre de likes, le nombre de réponses et les identifiants de commentaires. Le point de terminaison officiel commentThreads.list peut également retourner les fils de commentaires et prend en charge la pagination lorsque de nouveaux résultats sont disponibles.
Ces données peuvent être utiles dans un véritable projet marketing. Par exemple, une entreprise de logiciels pourrait recueillir des commentaires à partir de plusieurs vidéos d’avis concernant son propre produit et les outils concurrents. L’équipe pourrait alors rechercher des plaintes répétées telles que des prix élevés, une configuration difficile, des fonctionnalités manquantes ou un support médiocre, ce qui pourrait révéler des problèmes produits non évidents uniquement à partir du nombre de vues.
Les transcriptions peuvent fournir une couche supplémentaire d’information. Un scraper de transcription YouTube peut transformer les légendes disponibles en texte consultable, ce qui facilite l’étude de ce que les créateurs abordent réellement dans une vidéo. Cela peut aider à la recherche de mots-clés, la découverte de sujets, l’analyse de contenu concurrent et la classification de texte à grande échelle.
L’accès aux transcriptions est moins prévisible que les métadonnées de base. Certaines vidéos n’ont pas de sous-titres, d’autres utilisent des sous-titres générés automatiquement, et certaines méthodes de transcription dépendent d’interfaces non officielles. Le droit d’auteur et l’utilisation autorisée doivent également être pris en compte avant de stocker ou republier de grandes quantités de texte transcrit.
YouTube Scraper vs YouTube API
Un YouTube Scraper et l’API de données YouTube peuvent parfois collecter des informations similaires, mais ce ne sont pas le même type d’outil. L’API officielle fournit un accès documenté aux ressources YouTube prises en charge et est généralement plus facile à valider car les champs et méthodes de requête sont clairement définis. C’est un bon point de départ lorsque votre projet n’a besoin que de données que YouTube expose déjà via son API.
Le quota est un facteur à prendre en compte. Google indique actuellement que videos.list cela coûte une unité de quota par requête, tout en commentThreads.list coûtant aussi une unité. Les projets utilisant l’API YouTube Data reçoivent généralement une allocation quotidienne de quota, et certaines méthodes utilisent bien plus d’unités que de simples requêtes par liste.
Une API YouTube scraper tierce peut être plus pratique lorsque vous souhaitez un système prêt à l’emploi qui gère les requêtes, les retentions, l’analyse des données et l’exportation. Cela peut réduire le temps de développement, surtout lorsque les données doivent être transférées directement dans une base de données ou un outil d’analyse. Le compromis est que vous dépendez des prix, des champs pris en charge et de la maintenance d’un autre fournisseur.
Le meilleur choix dépend du projet plutôt que du nom de l’outil. Si l’API officielle fournit déjà les statistiques vidéo dont vous avez besoin, il n’y a peut-être aucune raison de construire un scraper séparé. Si votre workflow nécessite une structure de sortie différente, une interaction navigateur ou une autre méthode de collecte prise en charge, un outil tiers peut être plus facile à gérer.
Meilleurs outils de scraping YouTube en 2026
Il n’existe pas de YouTube Scraper unique qui convienne le mieux à chaque utilisateur. Un marketeur collectant des commentaires sur 20 vidéos a des besoins très différents de ceux d’un développeur traitant des centaines de milliers de relevés. Le bon choix dépend de la quantité de données, du type de données, de vos compétences techniques, du format de sortie et de la fréquence à laquelle la tâche doit être exécutée.
Pour la plupart des utilisateurs, le choix principal est entre des outils sans code, des API scraper et des outils basés sur Python. Chaque option peut bien fonctionner lorsqu’elle correspond à la taille et à la complexité du projet. Il est généralement préférable de tester d’abord un petit échantillon plutôt que de choisir un outil uniquement parce qu’il prétend supporter de très gros jobs.
Outils de scraping YouTube sans code
Les outils de scraping YouTube sans code sont utiles pour les marketeurs, chercheurs et équipes de contenu qui ne souhaitent pas créer leurs propres scripts. Ces outils fournissent généralement un formulaire ou un tableau de bord où les utilisateurs ajoutent des URL vidéo, choisissent des champs de données, définissent des limites et exécutent la tâche. Les résultats peuvent ensuite être téléchargés ou envoyés à un autre service.
Le YouTube Comments Scraper d’Apify en est un exemple. Les utilisateurs peuvent ajouter une ou plusieurs URL de vidéos, limiter le nombre de commentaires collectés, trier les commentaires et exporter les résultats vers des formats tels que JSON, CSV ou Excel. L’outil collecte actuellement des informations telles que le texte des commentaires, les noms d’utilisateurs, les dates de publication, les comptes et les réponses.
Cette configuration peut bien fonctionner pour la recherche d’audience. Supposons qu’une marque e-commerce veuille étudier les commentaires sous 40 vidéos de critiques de produits. Au lieu de lire des milliers de commentaires un par un, l’équipe peut les collecter dans un seul jeu de données et rechercher des questions répétées sur les produits, des plaintes ou des préoccupations d’achat.
Bright Data propose également une API YouTube Scraper qui peut être utilisée via un panneau de contrôle sans construire le système de collecte complet de zéro. Son produit actuel prend en charge les vidéos, les chaînes, les commentaires et la sortie structurée dans des formats tels que JSON, NDJSON et CSV. Le service annonce actuellement une allocation gratuite de 5 000 enregistrements par mois, bien que les prix et les limites puissent changer.
Pour ceux qui souhaitent une option de collecte de données plus large basée sur un navigateur, DICloak propose également un outil d’indexation IA pour le web scraping. Il permet aux utilisateurs de fournir une page et des instructions de tâche au lieu de construire tout le flux de travail à partir du code. La documentation de DICloak décrit cette fonctionnalité comme un robot d’indexation sans code capable d’organiser les informations extraites en résultats structurés.
API de scraper YouTube
Une API de scraper YouTube convient souvent mieux lorsque les données collectées doivent être transférées directement dans un autre système. Au lieu de télécharger un fichier manuellement, un développeur peut envoyer une requête, recevoir des données structurées et les stocker dans une base de données ou un pipeline analytique. Cela facilite l’automatisation des tâches récurrentes.
L’API officielle de données YouTube doit être examinée en premier. Un développeur pourrait stocker une liste d’identifiants vidéo et l’utiliser videos.list pour demander des informations publiques mises à jour selon un calendrier. Un autre processus pourrait être utilisé commentThreads.list pour collecter des fils de commentaires pour certaines vidéos.
Les API scraper tierces peuvent réduire la quantité d’infrastructure qu’une équipe doit maintenir. L’API YouTube Scraper actuelle de Bright Data accepte les URL cibles et retourne les enregistrements structurés, tout en prenant en charge les appels API, les webhooks et la livraison cloud. Sa page produit liste actuellement Python, Node.js, requêtes HTTP et plusieurs formats de livraison.
Une API de scraper est particulièrement utile lorsque le projet s’exécute en boucle. Par exemple, un système de surveillance de marque pourrait vérifier chaque jour certaines chaînes YouTube et envoyer de nouveaux enregistrements dans un tableau de bord interne. Le développeur doit toujours valider les résultats, mais l’étape de collecte des données devient plus facile à connecter au reste de l’application.
Python YouTube Scrapers
Python est utile lorsque vous avez besoin de plus de contrôle sur le flux de travail de collecte et de traitement. Un scraper YouTube Python peut être connecté à une base de données, combiné à une analyse de texte, ou programmé pour s’exécuter à des heures régulières. Le principal compromis est que les solutions Python nécessitent généralement plus d’entretien qu’un service managé.
Pour les projets de transcription, youtube-transcript-api c’est un exemple bien connu. Sa documentation actuelle indique qu’il peut récupérer manuellement et automatiquement des transcriptions, travailler avec différentes langues, traduire les transcriptions supportées et retourner des données structurées de transcription. Il ne nécessite pas la clé officielle de l’API de données YouTube pour son flux de travail de base sur les transcriptions.
Le même projet donne aussi un avertissement important. Il utilise une partie non documentée du client web YouTube, donc rien ne garantit que la méthode continuera à fonctionner si YouTube modifie l’interface. Cela la rend utile pour certains projets, mais cela signifie aussi que les développeurs doivent s’attendre à des échecs occasionnels et à des mises à jour.
Un autre outil technique populaire est YT-DLP. Il peut extraire une large gamme d’informations vidéo, mais les récents changements de YouTube ont rendu certains flux de travail plus complexes. Le projet yt-dlp documente actuellement l’utilisation croissante de la preuve d’origine, ou PO Tokens, par YouTube, et note que certains formats et fonctionnalités peuvent ne pas fonctionner sans eux.
C’est un rappel utile pour toute personne qui construit un scraper YouTube personnalisé. Un script qui fonctionne aujourd’hui peut ne pas fonctionner éternellement, même si le code lui-même n’a pas changé. YouTube peut modifier la structure des pages, les règles de requête, les exigences de jetons et les terminaux internes, donc la maintenance devrait faire partie du plan dès le départ.
Comment utiliser un grattoir YouTube
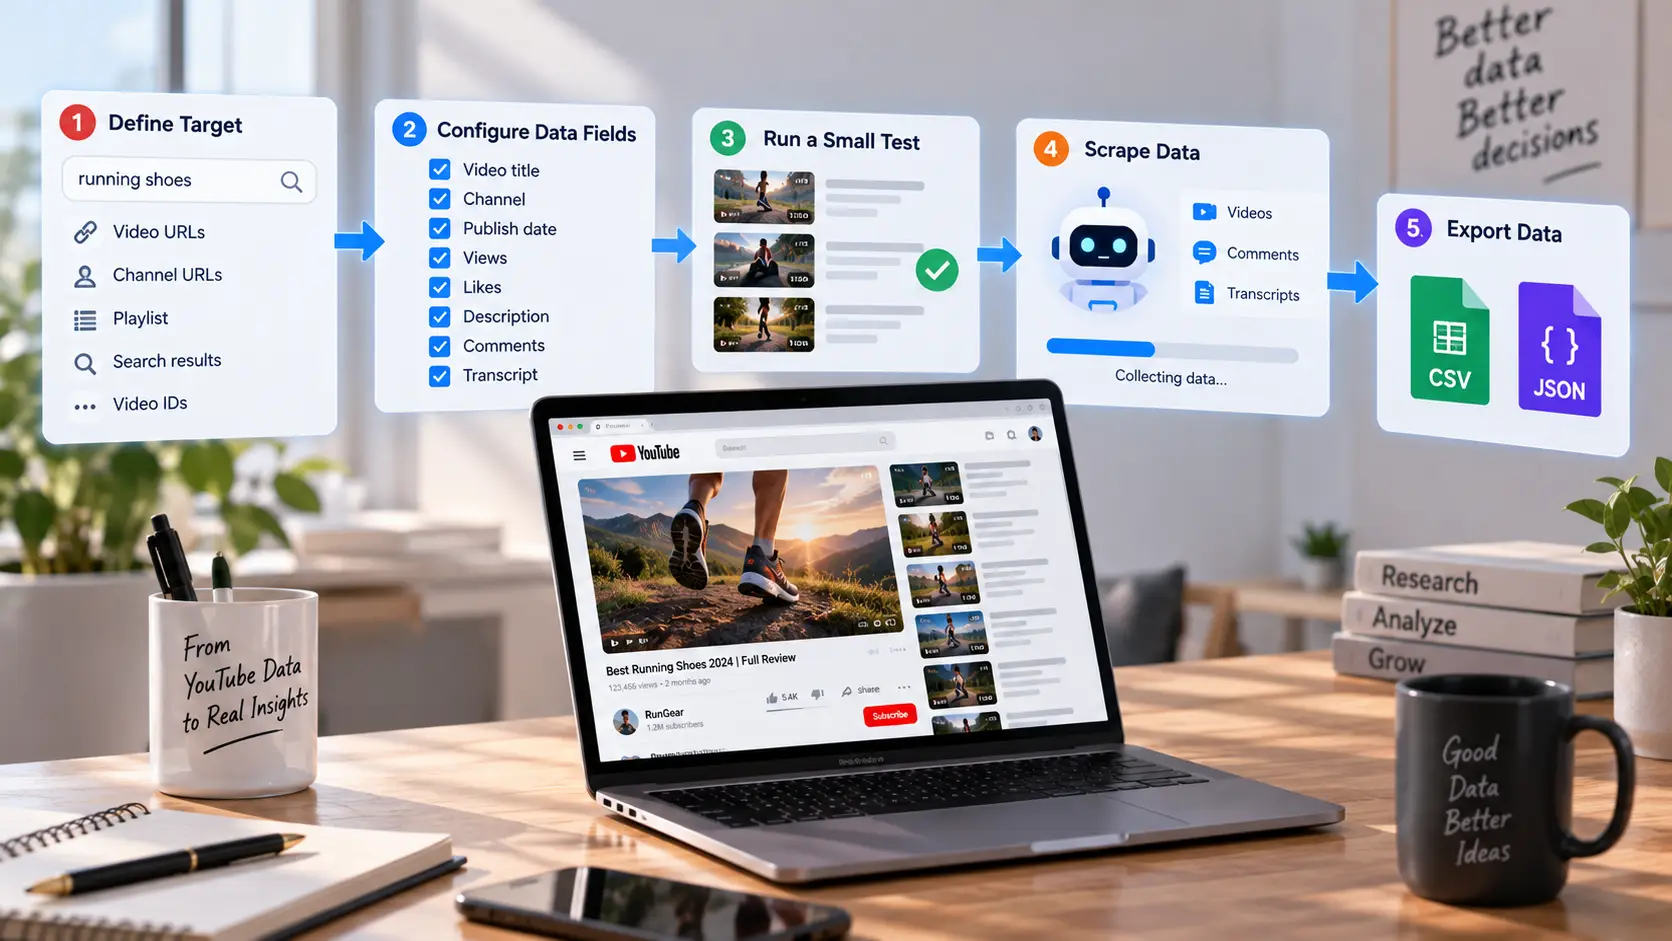
Un projet de scraping réussi commence généralement par une question claire, pas par une longue liste d’URLs. Si vous ne savez pas ce que vous voulez apprendre, il est facile de collecter de grandes quantités de données qui ne sont jamais utilisées. Définir l’objectif en premier facilite aussi le choix du bon YouTube Scraper et des bons champs de données.
Commencez petit même si votre outil peut traiter des milliers d’enregistrements. Un petit test facilite la détection de champs manquants, de mauvais formats, de doublons ou de résultats inattendus. Une fois que les données du test sont correctes, vous pouvez augmenter la taille du travail avec beaucoup plus de confiance.
Configurez et configurez votre scraper YouTube
La première étape consiste à définir la cible. Imaginez que vous vouliez rechercher des vidéos YouTube sur les chaussures de course publiées au cours des six derniers mois. Vous pouvez commencer par 100 URL de vidéos, plusieurs URL de chaînes ou une liste d’identifiants de vidéo collectés dans les résultats de recherche.
Ensuite, décidez quelles informations sont réellement nécessaires. Si l’objectif est la recherche de contenu, le titre de la vidéo, la chaîne, la date de publication, les vues, les likes, la description et l’URL peuvent suffire. Si l’objectif est la recherche client, vous pourriez aussi avoir besoin de commentaires, de nombre de réponses ou de texte de transcription.
Faites un petit test avant de tout collecter. Dix vidéos suffisent généralement pour vérifier si les champs sont corrects et si des données manquent. Ouvrez quelques pages YouTube originales et comparez les informations visibles avec les enregistrements extraits avant de faire confiance au jeu de données plus large.
Cette étape peut sembler lente, mais elle évite des problèmes plus importants plus tard. Si votre format de date est incorrect sur dix enregistrements, il est facile à corriger. Si le même problème apparaît après avoir collecté 200 000 dossiers, le nettoyage devient beaucoup plus coûteux.
Récupérez les vidéos YouTube, commentaires et transcriptions
Les métadonnées vidéo sont généralement le type de données YouTube le plus simple à collecter. La méthode officielle videos.list peut renvoyer les informations prises en charge via des champs tels que snippet, statistics, et contentDetails. Cela la rend utile pour les projets qui comparent des titres vidéo, des dates, des chiffres d’engagement et d’autres attributs publics.
Les commentaires nécessitent une planification plus approfondie car les vidéos populaires peuvent recevoir des milliers de réponses. Le point de terminaison officiel commentThreads.list prend en charge la pagination, et des sections de commentaires plus grandes peuvent nécessiter plusieurs requêtes. Si vous avez besoin de réponses individuelles, le comments.list point de terminaison peut aussi être utilisé pour les enregistrements de commentaires pris en charge.
Un scraper de commentaires YouTube peut faciliter ce flux de travail lorsque l’objectif est la recherche plutôt que le développement d’API. Par exemple, une agence marketing pourrait collecter des commentaires issus de vidéos d’avis de produits puis les regrouper par questions courantes, réactions positives et retours négatifs. L’analyse peut révéler pourquoi les spectateurs aiment un produit et en rejettent un autre.
Les transcriptions doivent normalement être considérées comme une tâche distincte. Un extracteur de transcription YouTube peut aider à convertir les légendes disponibles en texte structuré pour la recherche de mots-clés, l’analyse de sujets ou la recherche interne. Cependant, les utilisateurs doivent vérifier à la fois la disponibilité des transcriptions et l’utilisation autorisée avant de stocker ou réutiliser de grandes quantités de contenu protégé par le droit d’auteur.
Exportez les données YouTube en CSV ou JSON
Une fois que vous avez extrait les données YouTube, le format de sortie doit correspondre à ce qui se passe ensuite. Le CSV fonctionne bien lorsque les données sont plates et s’ouvrent dans Excel, Google Sheets ou un autre outil de tableur. Il est facile de trier les vidéos par date, vues, chaîne ou engagement et de partager le fichier avec des membres de l’équipe non techniques.
Le JSON est souvent meilleur pour les développeurs. Il peut conserver des informations imbriquées, ce qui est utile lorsqu’une vidéo contient plusieurs champs liés ou qu’un commentaire a des réponses. Le JSON s’intègre également naturellement dans les API, bases de données et pipelines de traitement automatisés.
Les identifiants stables sont importants dans les deux formats. Un titre peut changer, et deux vidéos peuvent avoir le même titre, mais un identifiant vidéo vous donne une clé plus fiable. La même idée s’applique aux identifiants de canal et aux identifiants de commentaires lorsqu’ils sont disponibles.
Il est également utile d’enregistrer la date ou l’horodatage de la collecte. Une vidéo peut avoir 25 000 vues aujourd’hui et 80 000 vues le mois prochain, donc le chiffre a peu de valeur sans savoir quand elle a été collectée. Une bonne extraction de données YouTube conserve à la fois la valeur et son contexte.
Problèmes et risques courants des scrapers YouTube
Même un bon extracteur YouTube peut donner des résultats incomplets ou cesser de fonctionner. Parfois, le scraper est cassé, mais parfois les données sources ont changé ou disparu. Comprendre la différence rend le dépannage beaucoup plus rapide.
La fiabilité ne consiste pas seulement à maintenir un script en fonctionnement. Vous devez aussi savoir si les données sont complètes, actuelles et collectées selon les règles applicables à la plateforme et à votre projet. Cela est particulièrement important lorsque les résultats seront utilisés pour des décisions commerciales.
Pourquoi les scrapers YouTube cessent de fonctionner
Les outils de scraping basés sur les pages de YouTube dépendent de la structure des pages YouTube et des requêtes internes. Si YouTube modifie la façon dont une valeur est chargée, un scraper peut ne plus trouver le même champ. Cela peut arriver même lorsque l’URL et la page visible sont presque identiques.
Les bibliothèques non officielles rencontrent un problème similaire. Le youtube-transcript-api projet précise clairement qu’il dépend d’une interface non documentée utilisée par le client web YouTube. Si YouTube modifie cette interface, l’outil peut temporairement cesser de fonctionner jusqu’à la mise à jour du projet.
Les modifications techniques peuvent également affecter les outils d’extraction vidéo. Le projet yt-dlp documente actuellement une application plus large des jetons PO pour certaines requêtes YouTube et avertit que certaines fonctionnalités peuvent ne pas être disponibles sans le jeton requis. Cela explique pourquoi les outils de scraping nécessitent des mises à jour régulières au lieu d’être traités comme des scripts permanents.
Tous les résultats manquants ne sont pas une défaillance technique. Une vidéo peut être devenue privée, les commentaires peuvent être désactivés, ou les sous-titres peuvent ne pas exister. Avant de modifier votre code, vérifiez si la source originale fournit toujours les informations attendues.
Comment améliorer la précision et la stabilité du grattage
La façon la plus simple d’améliorer la précision est de valider manuellement un petit échantillon. Comparez plusieurs enregistrements extraits avec les pages YouTube originales ou les réponses officielles de l’API. Si les chiffres ou le texte ne correspondent pas, trouvez la raison avant d’augmenter la taille du travail.
Conservez la sortie brute ainsi que la version nettoyée. Le traitement des données peut introduire ses propres erreurs, surtout lorsque les scripts changent de dates, suppriment des doublons, traduisent du texte ou combinent plusieurs champs. Enregistrer la réponse originale vous donne un moyen de revenir lorsqu’une étape ultérieure produit des résultats inattendus.
Les gros travaux doivent aussi enregistrer les cibles échouées au lieu de les ignorer silencieusement. Si vous envoyez 10 000 identifiants vidéo et recevez 9 600 enregistrements, les 400 manquants devraient être enregistrés dans un journal de défaillance. Sinon, votre jeu de données final peut sembler complet même si un groupe important de vidéos manque.
Pour les projets récurrents, séparez la collecte de l’analyse. Commencez par collecter et enregistrer les données sources, puis effectuer le nettoyage, la classification, l’analyse de sentiment ou le reporting en deuxième étape. Cela facilite grandement l’identification d’un problème provenant du YouTube Scraper ou de votre propre code de traitement.
Limites de scraping et conformité sur YouTube
Le scraping YouTube a des limites techniques, mais aussi des limites de politique. Les politiques de développement de l’API de YouTube stipulent que les clients API ne doivent pas directement ou indirectement extraire les applications YouTube ni obtenir les données YouTube extraites. Les développeurs utilisant l’API officielle doivent également respecter les Conditions d’utilisation de l’API de YouTube, les règles de confidentialité, les exigences de sécurité et les politiques de gestion des données.
La confidentialité mérite une attention particulière lorsque des commentaires ou des informations utilisateur sont impliqués. Les directives développeurs de YouTube indiquent que les clients API ne doivent pas collecter ni stocker les informations d’identification des utilisateurs sans consentement et respecter la vie privée de l’utilisateur. Collecter uniquement les champs réellement nécessaires peut réduire à la fois les risques et le stockage de données inutiles.
Par exemple, une étude de sentiment peut n’avoir besoin que d’informations sur le texte des commentaires, la date et l’engagement. Elle n’a peut-être pas besoin de stocker le nom d’utilisateur d’une personne pendant des mois. Se demander si chaque domaine est vraiment nécessaire est une manière simple de construire un flux de travail de recherche plus propre.
Les transcriptions nécessitent un soin similaire. Les légendes visibles publiquement restent du contenu, et collecter du texte pour une analyse interne des sujets est différent de copier des transcriptions complètes et de les republier ailleurs. Un flux de travail fiable sur YouTube Scraper doit prendre en compte la précision technique, les règles de la plateforme, la confidentialité et le droit d’auteur ensemble.
Améliorer le scraping YouTube avec DICloak
Pour certaines équipes, la collecte des données n’est qu’une partie du problème. Elles peuvent aussi devoir gérer différentes sessions de navigateur, paramètres de proxy, projets clients et scripts d’automatisation sans tout mélanger. Dans ces cas, l’organisation du navigateur peut être aussi importante que le scraper lui-même.
DICloak peut agir comme une couche de gestion de navigateur pour les flux de données approuvés. Sa principale valeur ici n’est pas de remplacer l’API de données YouTube ni de modifier les règles de YouTube. Il fournit des profils de navigateur, une configuration de proxy et des outils d’API locale qui peuvent aider à organiser différents projets basés sur navigateur.
Si l’isolation du navigateur fait partie de votre configuration de recherche, ce guide d’un navigateur antidétection pour le web scraping explique comment des profils de navigateur distincts peuvent s’intégrer dans des flux de données plus vastes. La même idée peut être utile lorsque plusieurs projets ou membres d’équipe ont besoin de leurs propres paramètres et sessions.
Tâches de scraping séparées avec profils de navigateur
DICloak utilise des profils de navigateur séparés pour garder les données et paramètres du navigateur organisés. Son API locale peut lister les profils de navigateur et les filtrer par informations telles que groupe, type de proxy, hôte proxy, IP de sortie, statut et plateforme. Cela offre aux équipes un moyen plus clair de séparer un projet de recherche d’un autre.
Par exemple, une équipe de recherche pourrait utiliser un Profil de navigateur pour un projet d’analyse de la concurrence et un autre pour tester un outil de données basé sur un navigateur. Un Profil distinct pourrait être attribué à un projet client afin que les cookies, sessions et paramètres du navigateur ne soient pas mélangés avec des travaux sans rapport.
Cette approche est également utile lorsque plusieurs personnes travaillent sur le même processus de recherche. Au lieu d’ouvrir chaque tâche dans un navigateur normal, chaque projet peut avoir son propre Profil et ses paramètres nommés. L’avantage est une organisation plus propre, pas une collecte de données plus agressive.
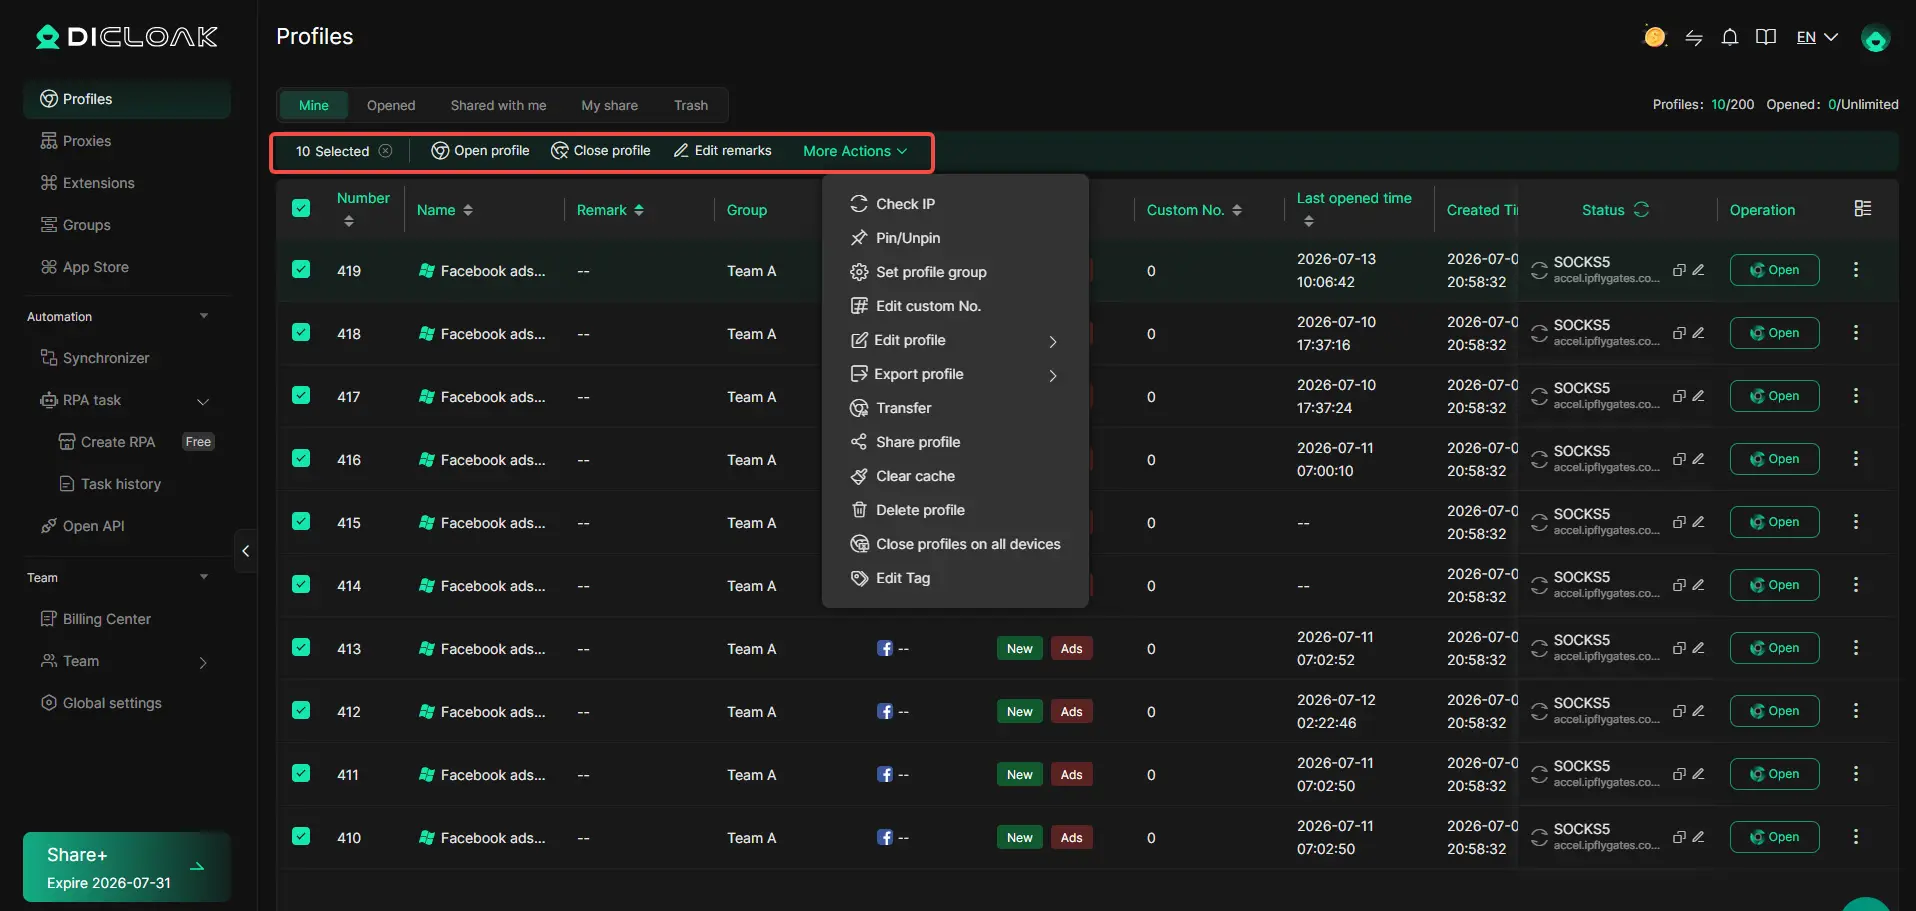
DICloak prend en charge différents modes de proxy au niveau du profil navigateur. Sa documentation actuelle liste No Proxi, Proxy personnalisé, Proxies sauvegardés et extraction d’API, tandis que l’API locale prend en charge les types de proxy tels que HTTP, HTTPS et SOCKS5.
Cela peut aider les équipes à garder les paramètres réseau liés au bon projet. Par exemple, une tâche de recherche basée sur navigateur peut utiliser une connexion réseau d’entreprise, tandis qu’un autre projet régional approuvé utilise une configuration proxy spécifique. Garder ces paramètres dans des profils séparés facilite l’évitement des modifications de configuration accidentelles.
Pour les utilisateurs ayant besoin de plus de contexte, le contenu de DICloak sur les flux de travail de proxy et de web scraping couvre des sujets liés au proxy, tels que le scraping de l’infrastructure et la performance réseau. Un proxy doit toujours être traité comme un outil réseau plutôt que comme un moyen d’ignorer les limites de la plateforme.
La même règle s’applique à un YouTube Scraper. Modifier le chemin du réseau ne modifie pas les politiques de YouTube, les règles de droit d’auteur ou les obligations de confidentialité. L’objectif doit être une infrastructure stable et organisée pour les tâches autorisées.

Intégrer DICloak avec Python et des API
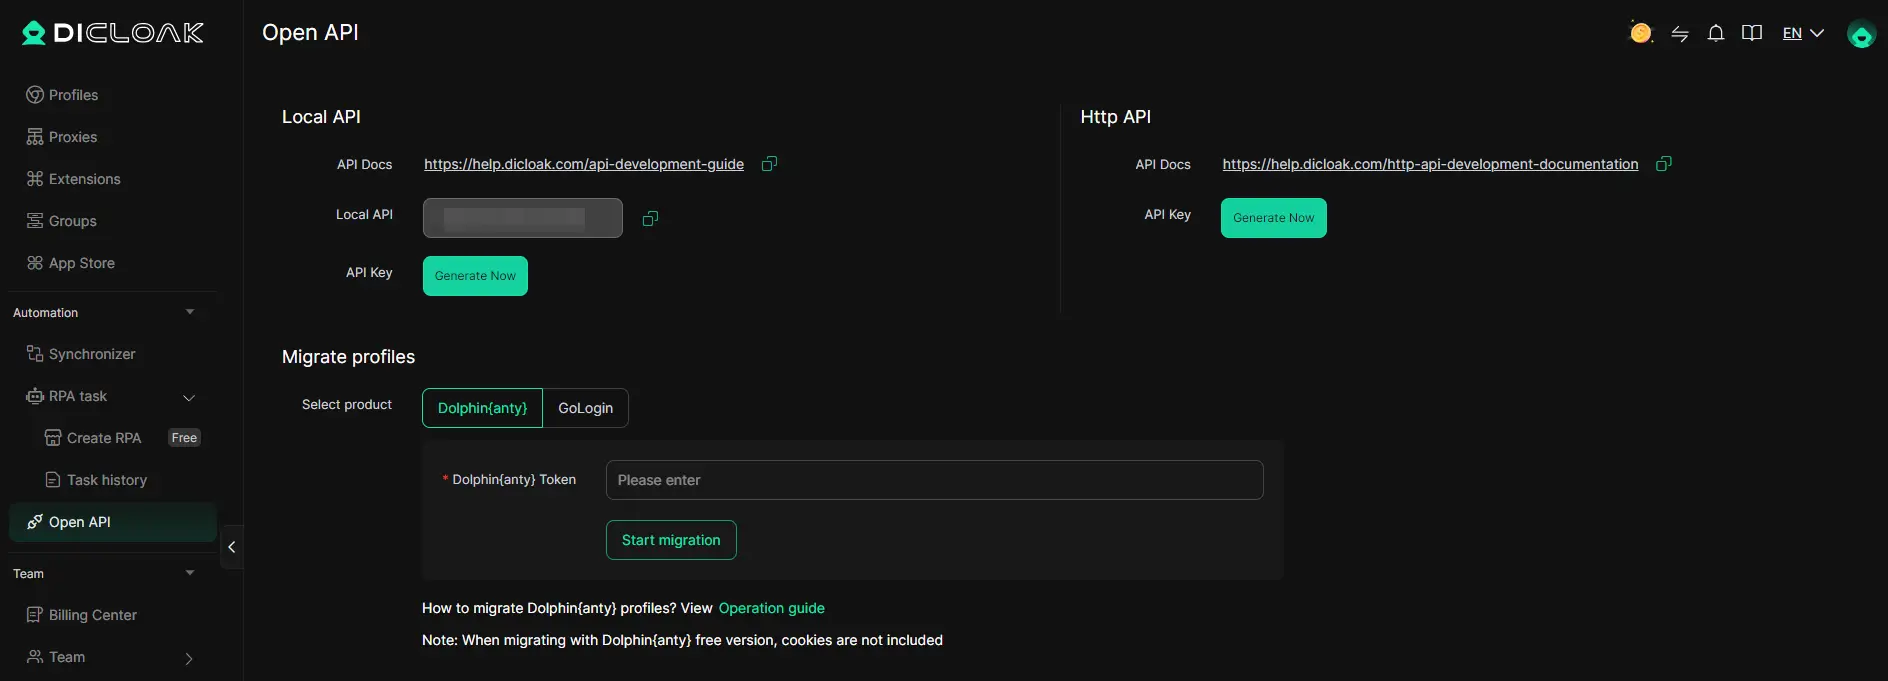
Les équipes techniques peuvent connecter DICloak à leur propre automatisation via l’API locale Open. Le guide de développement actuel inclut des exemples pour Python avec Playwright et ChromeDriver, Node.js avec Puppeteer, et Java avec ChromeDriver. Il documente également des actions telles que l’affichage des profils de navigateur, leur ouverture, la connexion d’outils d’automatisation, l’interaction avec les fenêtres du navigateur et la fermeture des sessions.
Cela peut s’intégrer dans un flux de travail Python plus large lorsque l’interaction avec le navigateur est requise. Un script pourrait demander un profil navigateur spécifique via l’API locale, ouvrir ce profil, connecter Playwright, accomplir une tâche de navigateur approuvée, enregistrer le résultat et fermer le profil. La partie traitement des données peut alors continuer en Python sans mélanger la logique de gestion du navigateur à chaque étape.
L’API de profil navigateur de DICloak et son interface proxy permettent également de lire les profils et la configuration réseau de manière programmatique. Cela peut aider les équipes plus larges à maintenir la cohérence des règles de nommage, de regroupement, d’attribution de proxy et d’automatisation sur de nombreux projets.
La configuration la plus fiable est généralement à plusieurs niveaux. Utilisez l’API officielle YouTube Data lorsqu’elle fournit déjà les informations dont vous avez besoin, choisissez une API de scraper YouTube adaptée ou un autre outil autorisé lorsque le projet nécessite un autre flux de travail, et n’utilisez les profils navigateur que lorsque le travail basé sur navigateur en a réellement besoin. Cela facilite les tests du processus, la maintenance et la compréhension pour une équipe.
FAQ à propos de YouTube Scraper
Q1 : Qu’est-ce qu’un extracteur YouTube ?
Un YouTube Scraper est un outil ou un script qui collecte des données publiques de YouTube, telles que des titres de vidéos, des descriptions, des vues, des commentaires, des informations sur les chaînes, des dates de publication et des transcriptions disponibles. Les données peuvent ensuite être sauvegardées dans des formats tels que CSV ou JSON pour la recherche, l’analyse ou le reportage.
Q2 : Quelles données un YouTube Scraper peut-il collecter ?
Un YouTube Scraper peut collecter différents types de données selon l’outil. Des exemples courants incluent les métadonnées vidéo, les informations sur les chaînes, les commentaires, le nombre de réponses, les résultats de recherche, les playlists, les données d’engagement et les transcriptions. Certains outils de scraping YouTube permettent également aux utilisateurs de ne sélectionner que les champs dont ils ont besoin.
Q3 : Un YouTube Scraper est-il le même que l’API de données YouTube ?
Non. Un YouTube Scraper peut collecter des informations à partir de pages web, d’automatisation de navigateur ou de services de scraping tiers, tandis que l’API YouTube Data offre un accès officiel et documenté aux données YouTube prises en charge. Si les informations dont vous avez besoin sont disponibles via l’API officielle, il est généralement utile de vérifier cette option d’abord.
Q4 : Un Scraper YouTube peut-il collecter des commentaires et des transcriptions ?
Oui, certains outils YouTube Scraper peuvent collecter les commentaires, réponses et transcriptions disponibles. Un scraper de commentaires YouTube peut aider à la recherche d’audience ou de sentiment, tandis qu’un scraper de transcription YouTube peut transformer les légendes disponibles en texte structuré. Cependant, les commentaires peuvent être désactivés et certaines vidéos peuvent ne pas avoir de transcriptions.
Q5 : Comment choisir le meilleur scraper YouTube en 2026 ?
Choisissez un YouTube Scraper en fonction des données dont vous avez besoin, du nombre de vidéos que vous prévoyez de traiter, de vos compétences techniques et du format de sortie que vous préférez. Les outils no-code sont plus faciles pour les débutants, les API scraper fonctionnent bien pour les flux de travail automatisés, et les outils Python offrent plus de contrôle. Vous devriez aussi prendre en compte la précision des données, la maintenance, les règles YouTube, et la possibilité que l’outil puisse exporter des données en CSV, JSON ou votre base de données.
 Outils gratuits
 Extension de cookie
 Générateur UA
 Générateur d'adresse MAC
 Générateur d'IP
 Liste des adresses IP
 Générateur de code 2FA
 Horloge mondiale
 Vérification Anonyme
 WebRTC Leak Test
 Générateur UUID
 Vérificateur de proxy
 Vérificateur d'annonces FB
 Extraction de données web par IA
 Outils SMM gratuits
 Vérificateur d'ombre bannissement Twitter
 Générateur UTM
 Générateur de noms d'utilisateur
 Generateur de hashtags IA
 Générateur de titre LinkedIn
 Redimensionneur d’images sociales