O YouTube contém uma enorme quantidade de informação pública que pode apoiar a pesquisa de conteúdos, o rastreio de concorrentes, a análise de audiência e a pesquisa de mercado. Títulos de vídeos, descrições, visualizações, comentários, informação do canal, datas de upload e transcrições disponíveis podem todos revelar padrões úteis. O problema é que recolher esta informação manualmente torna-se irrealista quando se precisam de dados de centenas ou milhares de vídeos.
Um YouTube Scraper ajuda a transformar este trabalho num processo estruturado. Em vez de abrir todos os vídeos e copiar informação para uma folha de cálculo, uma ferramenta de scraping pode recolher campos selecionados e guardá-los como CSV, JSON ou outro formato. Dependendo do projeto, os utilizadores podem escolher ferramentas de scraping no YouTube sem código, APIs de scraper, bibliotecas Python ou a API oficial de dados do YouTube.
Antes de usar qualquer método, é importante compreender as regras do YouTube. As Políticas de Desenvolvimento da API do YouTube estabelecem que os clientes API não devem extrair aplicações do YouTube nem obter dados extraídos do YouTube, exceto quando as regras do YouTube o permitam especificamente. Se a informação de que precisa já estiver disponível através da API oficial, essa é geralmente a primeira opção que vale a pena verificar.
Se é novo neste tipo de recolha de dados, compreender primeiro os conceitos básicos de web scraping também pode ajudar. O resto deste guia foca-se em como funciona um YouTube Scraper , que ferramentas serão úteis em 2026, como recolher diferentes tipos de dados do YouTube e que problemas deve esperar.
O que é um YouTube Scraper e que dados pode extrair?
Um YouTube Scraper é uma ferramenta ou script que recolhe informações relacionadas com vídeos do YouTube, canais, comentários, resultados de pesquisa ou transcrições. Os dados recolhidos são geralmente convertidos para um formato estruturado para que possam ser pesquisados, filtrados ou analisados. Isto pode poupar muito tempo quando o projeto envolve mais dados do que uma pessoa poderia copiar razoavelmente à mão.
Nem todos os scrapers funcionam da mesma forma. Algumas ferramentas leem informação das páginas web do YouTube, enquanto outras usam serviços de terceiros ou automação do navegador. A API oficial de dados do YouTube adota uma abordagem diferente, dando aos programadores acesso documentado aos recursos suportados do YouTube.
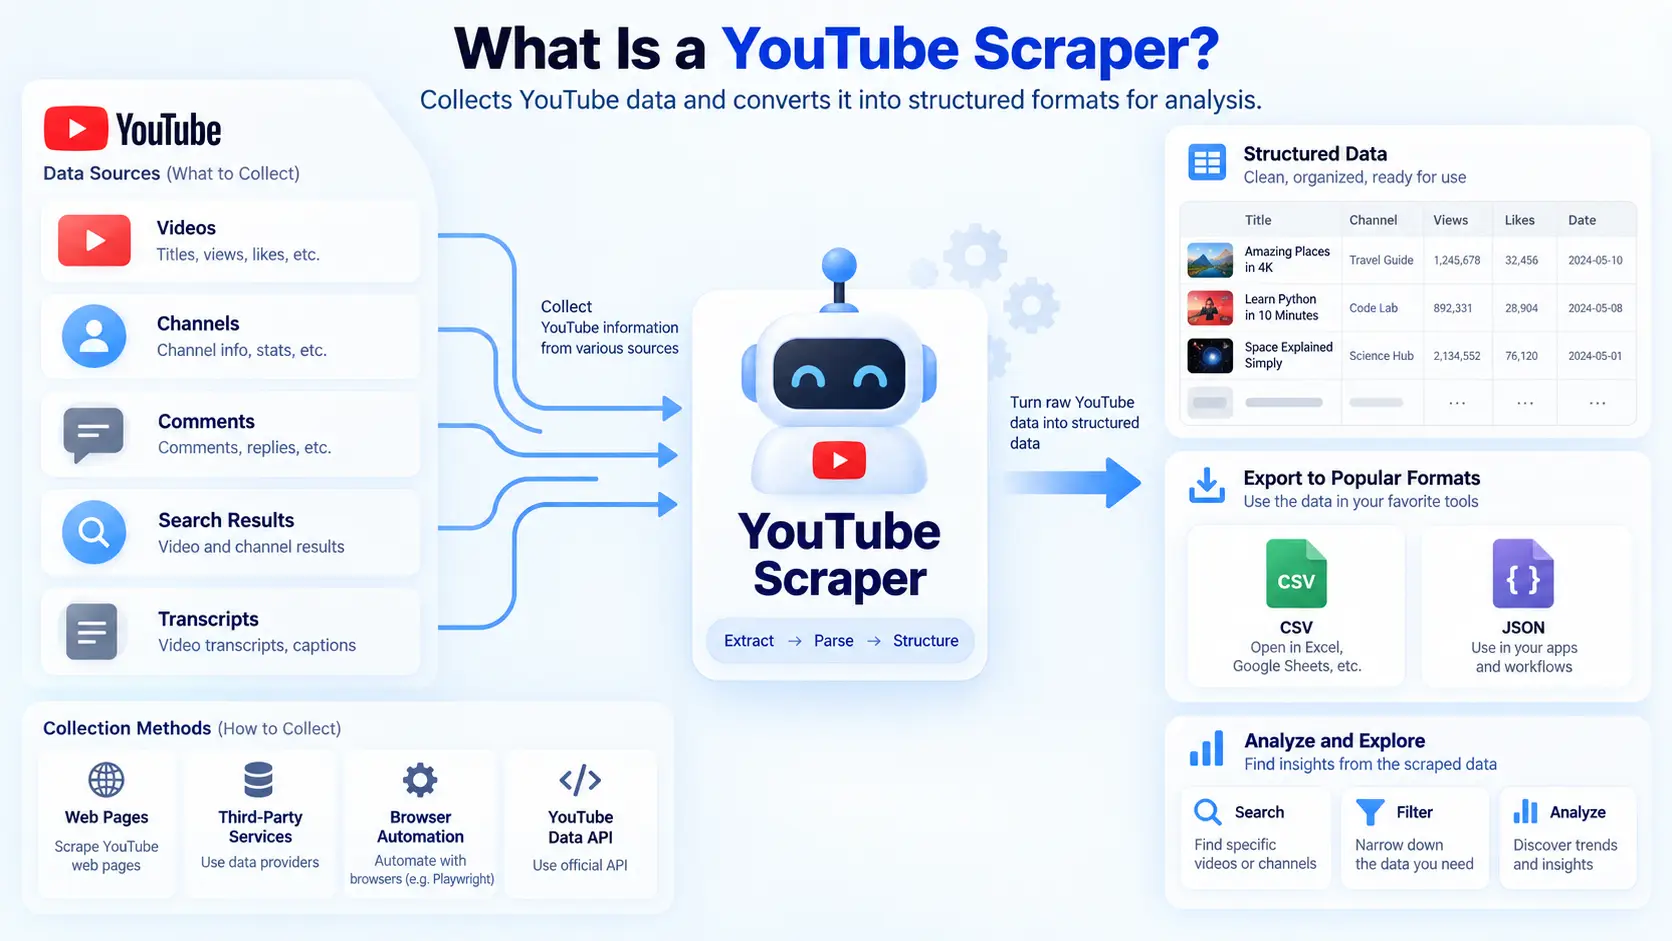
Como Funciona um Raspador do YouTube
A maioria dos fluxos de trabalho do YouTube Scraper começa com uma entrada. Essa entrada pode ser uma URL de vídeo, URL de canal, playlist, palavra-chave ou lista de IDs de vídeo. O scraper procura então campos específicos, extrai os valores e guarda-os num resultado estruturado.
Imagine que uma equipa de marketing quer estudar 300 vídeos sobre ferramentas de escrita por IA. Abrir cada vídeo manualmente demoraria horas, e a equipa poderia facilmente perder detalhes ou copiar números incorretamente. Um scraper pode recolher campos como título do vídeo, nome do canal, data de publicação, visualizações, gostos, descrição e ID do vídeo num único fluxo de trabalho repetível.
Algumas ferramentas de scraping do YouTube funcionam através do próprio site. Outras usam APIs para solicitar dados estruturados. A API oficial de dados do YouTube, por exemplo, fornece endpoints para vídeos, canais, playlists, comentários e tópicos de comentários. O videos.list método pode devolver campos como título, descrição, ID do canal, etiquetas e estatísticas quando essas partes são solicitadas.
A diferença é importante porque as ferramentas baseadas em páginas dependem de como as páginas do YouTube são construídas. Se o YouTube alterar a estrutura da página ou o fluxo interno de dados, um scraper pode precisar de ser atualizado. Os métodos baseados em API normalmente devolvem dados estruturados mais limpos, mas vêm com quotas, permissões e regras de plataforma.
Que dados do YouTube podem ser extraídos?
O tipo de dados que pode recolher depende da ferramenta. Para pesquisa em vídeo, campos comuns incluem títulos de vídeos, descrições, URLs, IDs de vídeo, nomes de canais, datas de publicação, duração, visualizações, gostos, contagens de comentários, etiquetas e categorias. Estes campos podem suportar análise de conteúdos, pesquisa de tópicos e monitorização de concorrentes.
Os comentários são outro alvo comum. Um raspador de comentários do YouTube pode recolher texto de comentários, nomes de utilizador, datas, contagens de gostos, contagens de respostas e IDs de comentários. O endpoint oficial commentThreads.list também pode devolver tópicos de comentários e suporta a paginação quando há mais resultados disponíveis.
Estes dados podem ser úteis num projeto real de marketing. Por exemplo, uma empresa de software pode recolher comentários de vários vídeos de análise sobre o seu próprio produto e ferramentas concorrentes. A equipa pode então procurar reclamações repetidas, como preços elevados, configuração difícil, funcionalidades em falta ou suporte deficiente, que podem revelar problemas de produto que não são óbvios apenas pelo número de visualizações.
As transcrições podem fornecer outra camada de informação. Um scraper de transcrições do YouTube pode transformar legendas disponíveis em texto pesquisável, facilitando o estudo do que os criadores realmente discutem dentro de um vídeo. Isto pode ajudar na pesquisa de palavras-chave, descoberta de temas, análise de conteúdos concorrentes e classificação de texto em grande escala.
O acesso às transcrições é menos previsível do que os metadados básicos. Alguns vídeos não têm legendas, outros usam legendas geradas automaticamente e alguns métodos de transcrição dependem de interfaces não oficiais. Os direitos de autor e o uso permitido também devem ser considerados antes de armazenar ou republicar grandes quantidades de texto transcrito.
YouTube Scraper vs YouTube API
Um YouTube Scraper e a YouTube Data API podem, por vezes, recolher informações semelhantes, mas não são o mesmo tipo de ferramenta. A API oficial fornece acesso documentado aos recursos suportados do YouTube e é geralmente mais fácil de validar porque os campos e métodos de pedido estão claramente definidos. É um bom ponto de partida quando o seu projeto só precisa de dados que o YouTube já expõe através da sua API.
A quota é um dos fatores a considerar. O Google afirma atualmente que videos.list isso custa uma unidade de quota por pedido, enquanto commentThreads.list também custa uma unidade. Projetos que usam a API de Dados do YouTube geralmente recebem uma quota diária, e alguns métodos usam muito mais unidades do que simples pedidos de lista.
Uma API de scraper do YouTube de terceiros pode ser mais conveniente quando pretende um sistema pronto que gere pedidos, tentativas, análise de dados e exportação. Isto pode reduzir o tempo de desenvolvimento, especialmente quando os dados precisam de ser transferidos diretamente para uma base de dados ou ferramenta de análise. A desvantagem é que depende dos preços, campos suportados e manutenção de outro fornecedor.
A melhor escolha depende do projeto e não do nome da ferramenta. Se a API oficial já fornece as estatísticas de vídeo de que precisas, pode não haver razão para construir um scraper separado. Se o teu fluxo de trabalho precisar de uma estrutura de saída diferente, interação com o navegador ou outro método de recolha suportado, uma ferramenta de terceiros pode ser mais fácil de gerir.
Melhores Ferramentas para Raspadores do YouTube em 2026
Não existe um único YouTube Scraper que funcione melhor para todos os utilizadores. Um marketeer que recolhe comentários de 20 vídeos tem necessidades muito diferentes de um programador que processa centenas de milhares de registos. A escolha certa depende da quantidade de dados, do tipo de dados, das suas competências técnicas, do formato de saída e da frequência com que a tarefa precisa de ser executada.
Para a maioria dos utilizadores, a principal escolha é entre ferramentas no-code, APIs de scraper e ferramentas baseadas em Python. Cada opção pode funcionar bem quando corresponde ao tamanho e complexidade do projeto. Normalmente, é melhor testar primeiro uma pequena amostra em vez de escolher apenas uma ferramenta porque afirma suportar trabalhos muito grandes.
Ferramentas de Raspagem do YouTube sem Código
As ferramentas de scraping sem código do YouTube são úteis para profissionais de marketing, investigadores e equipas de conteúdos que não querem criar os seus próprios scripts. Estas ferramentas normalmente fornecem um formulário ou painel onde os utilizadores adicionam URLs de vídeo, escolhem campos de dados, definem limites e executam a tarefa. Os resultados podem depois ser descarregados ou enviados para outro serviço.
O Raspador de Comentários do YouTube do Apify é um exemplo. Os utilizadores podem adicionar uma ou mais URLs de vídeo, limitar o número de comentários recolhidos, ordenar comentários e exportar os resultados para formatos como JSON, CSV ou Excel. Atualmente, a ferramenta recolhe informações como texto de comentários, nomes de utilizador, datas de publicação, contagens e respostas.
Esta configuração pode funcionar bem para pesquisa de audiências. Suponha que uma marca de comércio eletrónico quer estudar comentários abaixo de 40 vídeos de análises de produtos. Em vez de ler milhares de comentários um a um, a equipa pode recolhê-los num único conjunto de dados e procurar perguntas repetidas sobre produtos, reclamações ou preocupações de compra.
A Bright Data também fornece uma API do YouTube Scraper que pode ser usada através de um painel de controlo sem construir o sistema completo de recolha do zero. O seu produto atual suporta vídeos, canais, comentários e saída estruturada em formatos como JSON, NDJSON e CSV. O serviço anuncia atualmente uma autorização gratuita de 5.000 registos por mês, embora os preços e limites possam mudar.
Para quem procura uma opção mais ampla de recolha de dados baseada no navegador, o DICloak também disponibiliza um rastreador de IA para web scraping. Permite aos utilizadores fornecer uma página e instruções de tarefa, em vez de construir todo o fluxo de trabalho a partir do código. A própria documentação do DICloak descreve esta funcionalidade como um rastreador sem código que pode organizar a informação extraída em resultados estruturados.
YouTube Scraper APIs
Uma API de scraper do YouTube é frequentemente mais adequada quando os dados recolhidos precisam de ser transferidos diretamente para outro sistema. Em vez de descarregar um ficheiro manualmente, um programador pode enviar um pedido, receber dados estruturados e armazená-los numa base de dados ou num pipeline de análise. Isto facilita a automatização de tarefas recorrentes.
A API oficial de Dados do YouTube deve ser revista primeiro. Um programador poderia armazenar uma lista de IDs de vídeo e usar videos.list para solicitar informação pública atualizada num calendário. Outro processo poderia ser usado commentThreads.list para recolher tópicos de comentários para vídeos selecionados.
APIs de scraper de terceiros podem reduzir a quantidade de infraestrutura que uma equipa precisa de manter. A atual API do YouTube Scraper da Bright Data aceita URLs de destino e devolve registos estruturados, ao mesmo tempo que suporta chamadas API, webhooks e entrega na cloud. A sua página de produto lista atualmente Python, Node.js, pedidos HTTP e múltiplos formatos de entrega.
Uma API de scraper é especialmente útil quando o projeto é executado repetidamente. Por exemplo, um sistema de monitorização de marca poderia verificar canais selecionados do YouTube todos os dias e enviar novos registos para um painel interno. O programador ainda precisa de validar os resultados, mas a etapa de recolha de dados torna-se mais fácil de ligar ao resto da aplicação.
Python YouTube Scrapers
Python é útil quando precisas de mais controlo sobre o fluxo de trabalho de recolha e processamento. Um scraper Python do YouTube pode ser ligado a uma base de dados, combinado com análise de texto, ou agendado para correr em horários regulares. A principal desvantagem é que as soluções Python normalmente exigem mais manutenção do que um serviço gerido.
Para projetos de transcrições, youtube-transcript-api é um exemplo bem conhecido. A sua documentação atual diz que pode recuperar transcrições manuais e geradas automaticamente, trabalhar com diferentes línguas, traduzir transcrições suportadas e devolver dados estruturados de transcrições. Não necessita da chave oficial da API de dados do YouTube para o seu fluxo básico de transcrições.
O mesmo projeto também dá um aviso importante. Utiliza uma parte não documentada do cliente web do YouTube, pelo que não há garantia de que o método continue a funcionar se o YouTube alterar a interface. Isso torna-o útil para alguns projetos, mas também significa que os programadores devem esperar falhas e atualizações ocasionais.
Outra ferramenta técnica popular é o yt-dlp. Pode extrair uma vasta gama de informação de vídeo, mas as mudanças recentes no YouTube tornaram alguns fluxos de trabalho mais complexos. O projeto yt-dlp documenta atualmente o uso crescente do Proof of Origin no YouTube, ou PO Tokens, e nota que alguns formatos e funcionalidades podem não funcionar sem eles.
Este é um lembrete útil para quem está a construir um YouTube Scraper personalizado. Um script que funciona hoje pode não funcionar para sempre, mesmo que o código em si não tenha mudado. O YouTube pode alterar estruturas de páginas, regras de pedido, requisitos de tokens e endpoints internos, por isso a manutenção deve fazer parte do plano desde o início.
Como Usar um Raspador do YouTube
Um projeto de scraping bem-sucedido geralmente começa com uma pergunta clara, não com uma grande lista de URLs. Se não souber o que quer aprender, é fácil recolher grandes quantidades de dados que nunca são usadas. Definir o objetivo primeiro também facilita a escolha do YouTube Scraper certo e dos campos de dados certos.
Comece pequeno, mesmo que a sua ferramenta consiga processar milhares de registos. Um pequeno teste facilita detetar campos em falta, formatos errados, registos duplicados ou resultados inesperados. Quando os dados do teste parecerem corretos, pode aumentar o tamanho do trabalho com muito mais confiança.
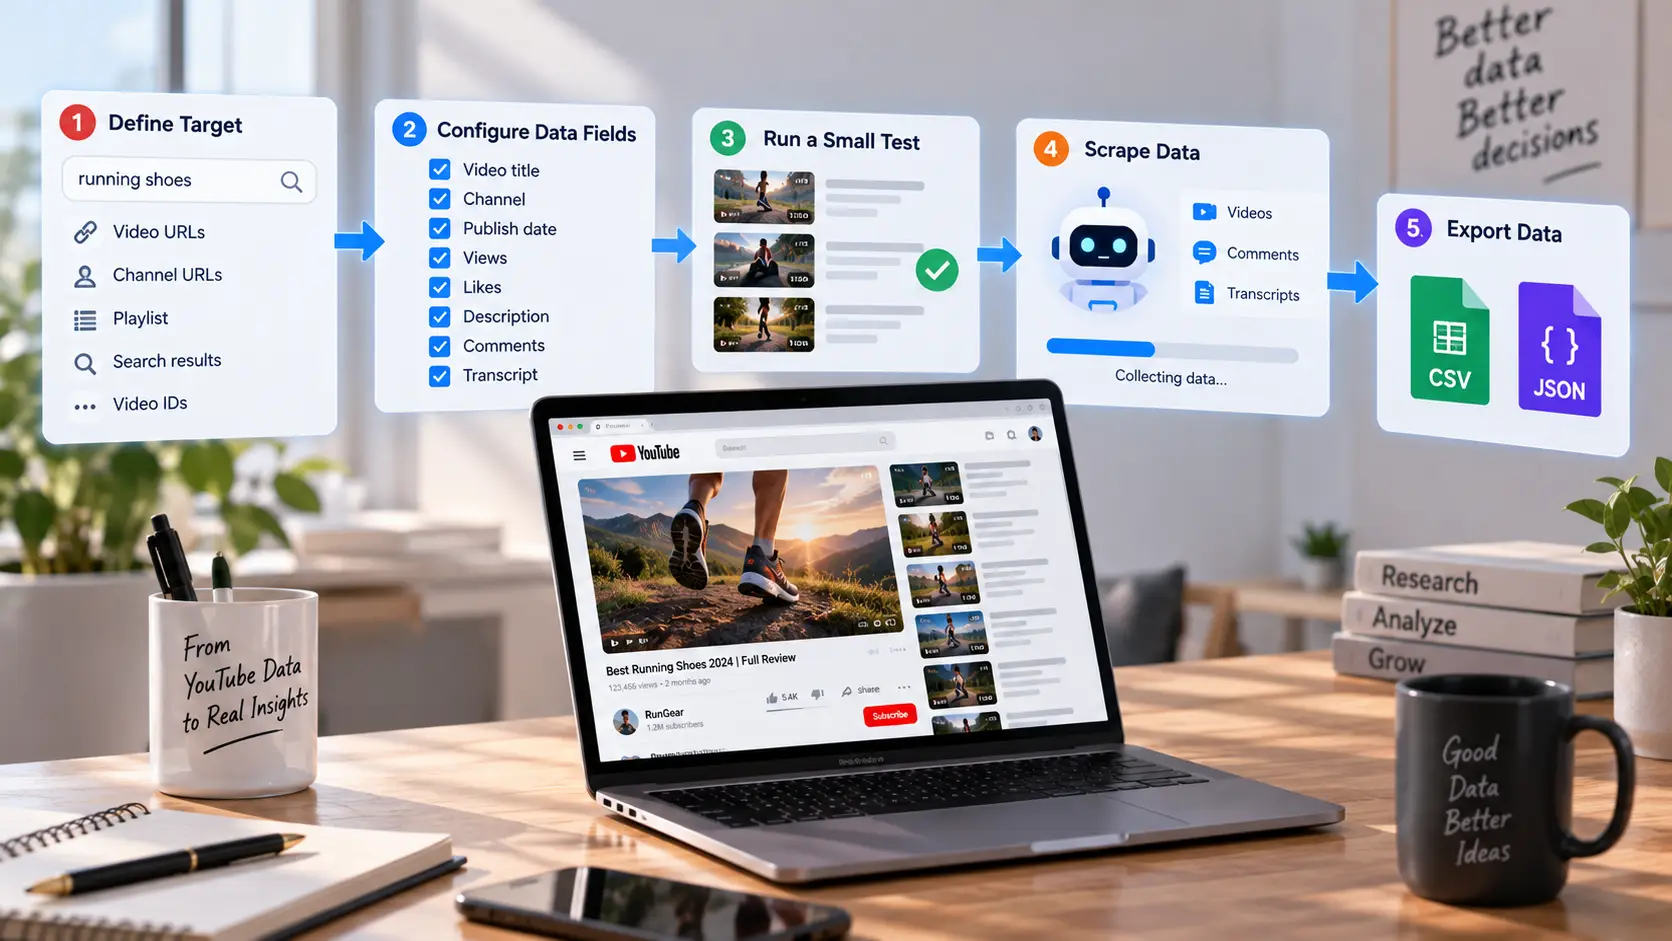
Configura e Configura o Teu Scraper do YouTube
O primeiro passo é definir o alvo. Imagine que quer pesquisar vídeos do YouTube sobre ténis de corrida publicados nos últimos seis meses. Pode começar com 100 URLs de vídeos, vários URLs de canais ou uma lista de IDs de vídeo recolhidos nos resultados de pesquisa.
De seguida, decida que informação é realmente necessária. Se o objetivo for pesquisa de conteúdo, título do vídeo, canal, data de publicação, visualizações, gostos, descrição e URL podem ser suficientes. Se o objetivo for pesquisa de clientes, poderá também precisar de comentários, contagens de respostas ou texto de transcrição.
Faça um pequeno teste antes de recolher tudo. Dez vídeos são geralmente suficientes para ver se os campos estão corretos e se falta algum dado. Abra algumas páginas originais do YouTube e compare a informação visível com os registos extraídos antes de confiar no conjunto de dados maior.
Este passo pode parecer lento, mas evita problemas maiores mais tarde. Se o formato da data estiver errado em dez registos, é fácil de corrigir. Se o mesmo problema surgir após a recolha de 200.000 registos, a limpeza torna-se muito mais dispendiosa.
Extrair vídeos, comentários e transcrições do YouTube
Os metadados de vídeo são geralmente o tipo de dados do YouTube mais fácil de recolher. O método oficial videos.list pode devolver informação suportada através de campos como snippet, statistics, e contentDetails. Isto torna-o útil para projetos que comparam títulos de vídeos, datas, números de envolvimento e outros atributos públicos.
Os comentários precisam de mais planeamento porque vídeos populares podem ter milhares de respostas. O endpoint oficial commentThreads.list suporta paginação, e secções maiores de comentários podem exigir múltiplos pedidos. Se precisar de respostas individuais, o comments.list endpoint também pode ser usado para registos de comentários suportados.
Um scraper de comentários no YouTube pode facilitar este fluxo de trabalho quando o objetivo é a investigação e não o desenvolvimento de APIs. Por exemplo, uma agência de marketing pode recolher comentários de vídeos de análises de produtos e depois agrupá-los por perguntas comuns, reações positivas e feedback negativo. A análise pode revelar porque é que os espectadores gostam de um produto e rejeitam outro.
As transcrições devem normalmente ser tratadas como uma tarefa separada. Um scraper de transcrições no YouTube pode ajudar a converter legendas disponíveis em texto estruturado para pesquisa de palavras-chave, análise de tópicos ou pesquisa interna. No entanto, os utilizadores devem verificar tanto a disponibilidade das transcrições como o uso permitido antes de armazenar ou reutilizar grandes quantidades de conteúdo protegido por direitos de autor.
Exportar Dados do YouTube para CSV ou JSON
Depois de extrair dados do YouTube, o formato de saída deve corresponder ao que acontece a seguir. O CSV funciona bem quando os dados estão planos e são abertos no Excel, Google Sheets ou noutra ferramenta de folhas de cálculo. É fácil ordenar vídeos por data, visualizações, canal ou interação e partilhar o ficheiro com membros da equipa não técnicos.
O JSON é frequentemente melhor para os programadores. Pode manter informação aninhada, o que é útil quando um vídeo contém vários campos relacionados ou um comentário tem respostas. O JSON também encaixa naturalmente em APIs, bases de dados e pipelines de processamento automatizado.
Identificadores estáveis são importantes em ambos os formatos. Um título pode mudar, e dois vídeos podem ter o mesmo título, mas um ID de vídeo dá-te uma chave mais fiável. A mesma ideia aplica-se aos IDs de canal e de comentários quando estão disponíveis.
Também é útil guardar a data ou carimbo temporal da recolha. Um vídeo pode ter hoje 25.000 visualizações e 80.000 no próximo mês, pelo que o número tem pouco valor sem saber quando foi recolhido. Uma boa extração de dados no YouTube mantém tanto o valor como o seu contexto.
Problemas e Riscos Comuns dos Raspadores do YouTube
Mesmo um raspador forte do YouTube pode devolver resultados incompletos ou deixar de funcionar. Por vezes o raspador está avariado, mas por vezes os dados de origem mudaram ou desapareceram. Compreender a diferença torna a resolução de problemas muito mais rápida.
Fiabilidade não é apenas manter um script a funcionar. Também precisa de saber se os dados estão completos, atualizados e recolhidos segundo as regras que se aplicam à plataforma e ao seu projeto. Isto é especialmente importante quando os resultados serão usados para decisões de negócio.
Porque é que os raspadores do YouTube deixam de funcionar
As ferramentas de scraping baseadas em páginas do YouTube dependem da estrutura das páginas do YouTube e dos pedidos internos. Se o YouTube alterar a forma como um valor é carregado, um scraper pode deixar de encontrar o mesmo campo. Isto pode acontecer mesmo quando o URL e a página visível parecem quase idênticos.
Bibliotecas não oficiais enfrentam um problema semelhante. O youtube-transcript-api projeto afirma claramente que depende de uma interface não documentada usada pelo cliente web do YouTube. Se o YouTube alterar essa interface, a ferramenta pode deixar de funcionar temporariamente até o projeto ser atualizado.
Alterações técnicas também podem afetar ferramentas de extração de vídeo. O projeto yt-dlp documenta atualmente a aplicação mais ampla do PO Token para alguns pedidos do YouTube e alerta que algumas funcionalidades podem não estar disponíveis sem o token necessário. Isto mostra porque as ferramentas de scraping precisam de atualizações regulares em vez de serem tratadas como scripts permanentes.
Nem todos os resultados em falta são uma falha técnica. Um vídeo pode ter-se tornado privado, os comentários podem estar desativados ou as legendas podem não existir. Antes de alterar o seu código, verifique se a fonte original ainda fornece a informação que esperava.
Como Melhorar a Precisão e a Estabilidade da Raspagem
A forma mais simples de melhorar a precisão é validar manualmente uma pequena amostra. Compare vários registos extraídos com as páginas originais do YouTube ou as respostas oficiais da API. Se os números ou o texto não coincidirem, encontre a razão antes de aumentar o tamanho do trabalho.
Mantém tanto a saída bruta como a versão limpa. O processamento de dados pode introduzir erros próprios, especialmente quando scripts mudam datas, removem duplicados, traduzem texto ou combinam vários campos. Guardar a resposta original dá-te algo a que regressar quando uma etapa posterior produzir resultados inesperados.
Trabalhos grandes também devem registar alvos falhados em vez de os ignorar silenciosamente. Se enviar 10.000 IDs de vídeo e receber 9.600 registos, os 400 em falta devem ser armazenados num registo de falhas. Caso contrário, o seu conjunto de dados final pode parecer completo mesmo que falte um grupo importante de vídeos.
Para projetos recorrentes, separe a recolha da análise. Primeiro, recolhe e guarde os dados de origem, depois execute limpeza, classificação, análise de sentimento ou relatórios como segundo passo. Isto torna muito mais fácil identificar se um problema veio do YouTube Scraper ou do seu próprio código de processamento.
Limites de Raspagem e Conformidade no YouTube
O scraping do YouTube tem limites técnicos, mas também tem limites de política. As Políticas de Desenvolvedores de API do YouTube estipulam que os clientes API não devem, direta ou indiretamente, extrair aplicações do YouTube nem obter dados extraídos do YouTube. Os programadores que utilizam a API oficial também devem seguir os Termos da API, regras de privacidade, requisitos de segurança e políticas de tratamento de dados.
A privacidade merece atenção especial quando estão envolvidos comentários ou informações dos utilizadores. As orientações para desenvolvedores do YouTube dizem que os clientes da API não devem recolher ou armazenar informações identificativas do utilizador sem consentimento e devem respeitar a privacidade do utilizador. Recolher apenas os campos realmente necessários pode reduzir tanto o risco como o armazenamento desnecessário de dados.
Por exemplo, um estudo de sentimento pode precisar apenas de texto de comentário, data e informações de envolvimento. Pode não precisar de armazenar o nome de utilizador de uma pessoa durante meses. Perguntar se cada campo é realmente necessário é uma forma simples de construir um fluxo de trabalho de investigação mais limpo.
As transcrições requerem cuidados semelhantes. Legendas publicamente visíveis continuam a ser conteúdo, e recolher texto para análise interna do tema é diferente de copiar transcrições completas e republicá-las noutro local. Um fluxo de trabalho fiável do YouTube Scraper deve considerar a precisão técnica, as regras da plataforma, a privacidade e os direitos de autor em conjunto.
Melhore o Scraping do YouTube com o DICloak
Para algumas equipas, recolher os dados é apenas uma parte do problema. Podem também precisar de gerir diferentes sessões do navegador, definições de proxy, projetos do cliente e scripts de automação sem misturar tudo. Nestes casos, a organização do navegador pode ser tão importante quanto o próprio scraper.
O DICloak pode funcionar como uma camada de gestão de navegadores para fluxos de trabalho de dados aprovados. O seu principal valor aqui não é substituir a API de Dados do YouTube nem alterar as regras do YouTube. Fornece Perfis de Navegador, configuração de proxy e ferramentas de API Local que podem ajudar a manter diferentes projetos baseados em navegador organizados.
Se o isolamento do navegador faz parte da sua configuração de pesquisa, este guia para um navegador antideteção para web scraping explica como perfis separados de navegador podem encaixar em fluxos de trabalho de dados maiores. A mesma ideia pode ser útil quando vários projetos ou membros da equipa precisam das suas próprias definições e sessões.
Tarefas de Raspagem Separadas com Perfis de Navegador
O DICloak utiliza Perfis de Navegador separados para manter os dados e definições do navegador organizados. A sua API Local pode listar Perfis de Navegador e filtrá-los por informações como grupo, tipo de proxy, host proxy, IP de saída, estado e plataforma. Isto dá às equipas uma forma mais clara de separar um projeto de investigação de outro.
Por exemplo, uma equipa de investigação pode usar um Perfil de Navegador para um projeto de análise de concorrência e outro para testar uma ferramenta de dados baseada em navegador. Um Perfil separado pode ser atribuído a um projeto cliente para que cookies, sessões e definições de navegador não se confundam com trabalhos não relacionados.
Esta abordagem é também útil quando mais do que uma pessoa trabalha no mesmo processo de investigação. Em vez de abrir todas as tarefas num navegador normal, cada projeto pode ter o seu próprio Perfil e definições rotuladas. O benefício é uma organização mais limpa, não uma recolha de dados mais agressiva.
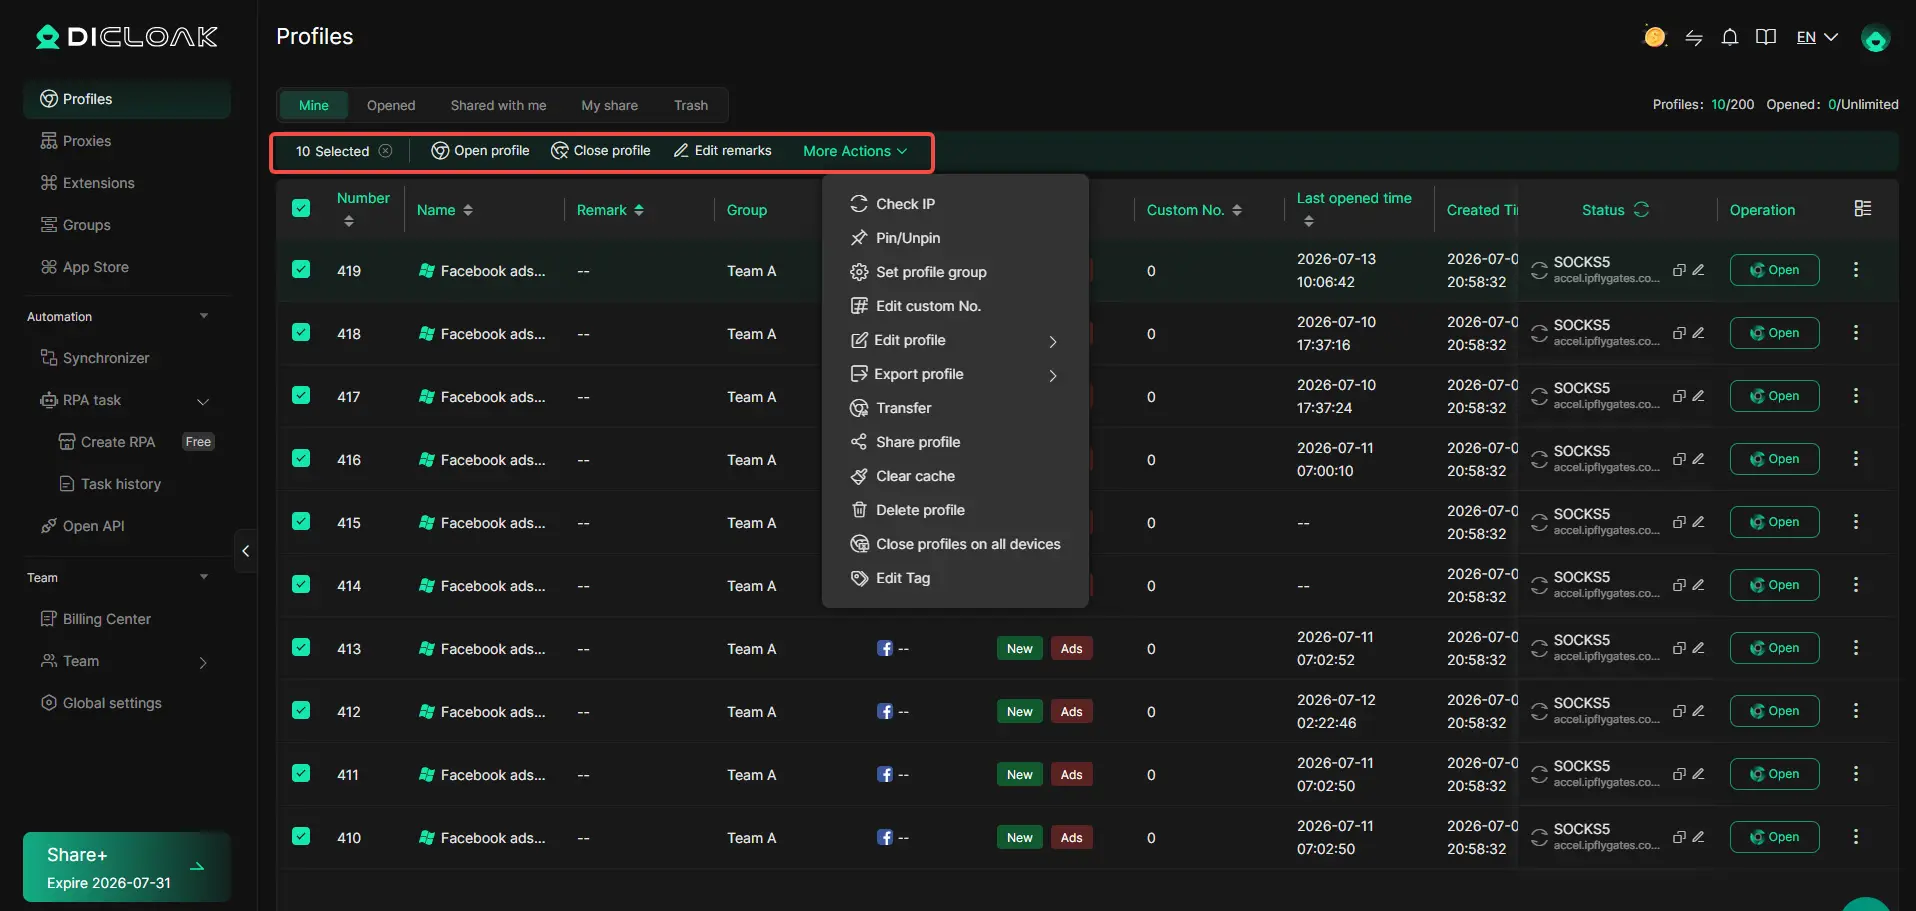
Configurar Proxies para o YouTube Scraping
O DICloak suporta diferentes modos de proxy ao nível do Perfil do Navegador. A sua documentação atual lista No Proxy, Proxy Personalizado, Proxies Guardados e extração de APIs, enquanto a API Local suporta tipos de proxy como HTTP, HTTPS e SOCKS5.
Isto pode ajudar as equipas a manter as definições de rede ligadas ao projeto correto. Por exemplo, uma tarefa de investigação baseada em browser pode usar uma ligação de rede da empresa, enquanto outro projeto regional aprovado usa uma configuração proxy específica. Manter essas definições dentro de Perfis separados torna mais fácil evitar alterações acidentais de configuração.
Para utilizadores que necessitem de mais contexto, o conteúdo do DICloak sobre fluxos de trabalho de proxy e web scraping cobre tópicos relacionados com proxy, como scraping de infraestrutura e desempenho de rede. Um proxy deve continuar a ser tratado como uma ferramenta de rede, e não como uma forma de ignorar os limites da plataforma.
A mesma regra aplica-se a um Scraper do YouTube. Alterar o caminho da rede não altera as políticas, regras de direitos de autor ou obrigações de privacidade do YouTube. O objetivo deve ser uma infraestrutura estável e organizada para tarefas permitidas.

Integrar DICloak com Python e APIs
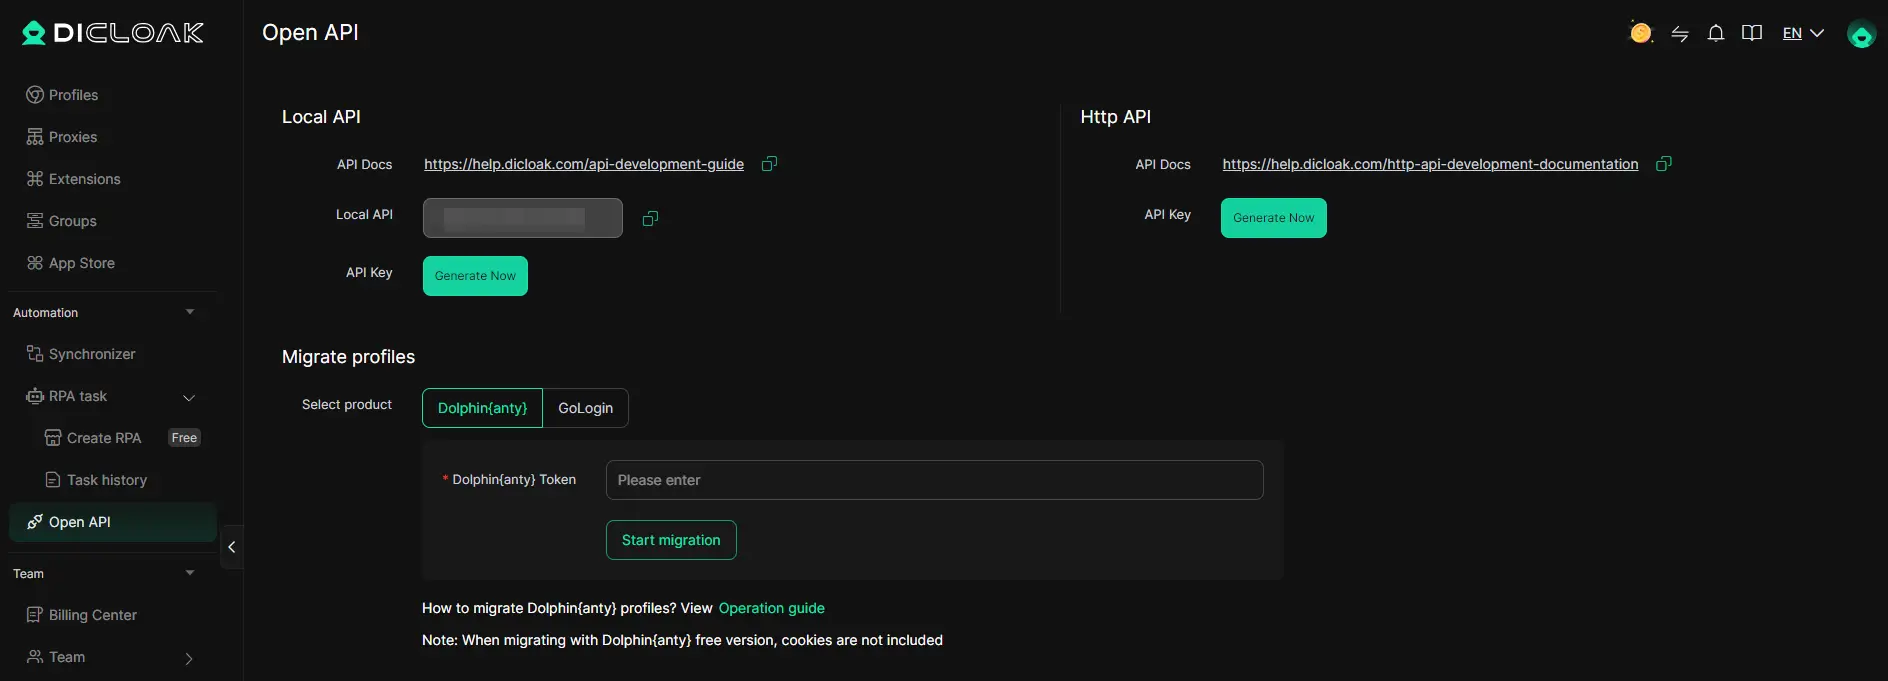
As equipas técnicas podem ligar o DICloak à sua própria automação através da API Local Open. O guia de desenvolvimento atual inclui exemplos para Python com Playwright e ChromeDriver, Node.js com Puppeteer e Java com ChromeDriver. Também documenta ações como listar Perfis do Navegador, abri-los, ligar ferramentas de automação, interagir com janelas do navegador e encerrar sessões.
Isto pode encaixar-se num fluxo de trabalho maior em Python quando é necessária a interação do navegador. Um script pode solicitar um Perfil de Navegador específico através da API Local, abrir esse Perfil, ligar o Playwright, completar uma tarefa aprovada do navegador, guardar o resultado e fechar o Perfil. A parte do processamento de dados pode então continuar em Python sem misturar a lógica de gestão do navegador em cada etapa.
A API de Perfil do Navegador e a interface de proxy do DICloak também tornam possível ler o Perfil e a configuração da rede de forma programática. Isto pode ajudar equipas maiores a manterem as regras de nomeação, agrupamento, atribuição de proxy e automação consistentes em muitos projetos.
A configuração mais fiável é geralmente uma em camadas. Use a API oficial de dados do YouTube quando já fornecer a informação necessária, escolha uma API adequada para scraper do YouTube ou outra ferramenta permitida quando o projeto necessitar de um fluxo de trabalho diferente, e use os Perfis do Navegador apenas quando o trabalho baseado em navegador realmente os necessita. Isto torna o processo mais fácil de testar, de manter e muito mais fácil de compreender para a equipa.
Perguntas frequentes sobre o YouTube Scraper
P1: O que é um YouTube Scraper?
Um YouTube Scraper é uma ferramenta ou script que recolhe dados públicos do YouTube, como títulos de vídeos, descrições, visualizações, comentários, informações de canais, datas de publicação e transcrições disponíveis. Os dados podem depois ser guardados em formatos como CSV ou JSON para investigação, análise ou reportagem.
P2: Que dados pode um YouTube Scraper recolher?
Um YouTube Scraper pode recolher diferentes tipos de dados dependendo da ferramenta. Exemplos comuns incluem metadados de vídeo, informações de canais, comentários, contagens de respostas, resultados de pesquisa, playlists, dados de envolvimento e transcrições. Algumas ferramentas de scraping do YouTube também permitem aos utilizadores selecionar apenas os campos de que necessitam.
P3: Um YouTube Scraper é igual à YouTube Data API?
Não. Um YouTube Scraper pode recolher informação de páginas web, automação de navegadores ou serviços de scraping de terceiros, enquanto a YouTube Data API fornece acesso oficial e documentado aos dados suportados do YouTube. Se a informação de que precisa estiver disponível através da API oficial, normalmente vale a pena verificar essa opção primeiro.
P4: Pode um Scraper do YouTube recolher comentários e transcrições?
Sim, algumas ferramentas do YouTube Scraper podem recolher comentários, respostas e transcrições disponíveis. Um scraper de comentários do YouTube pode ajudar na pesquisa de audiência ou sentimento, enquanto um scraper de transcrições do YouTube pode transformar legendas disponíveis em texto estruturado. No entanto, os comentários podem estar desativados e alguns vídeos podem não ter transcrições.
P5: Como escolho o melhor YouTube Scraper em 2026?
Escolha um Scraper do YouTube com base nos dados de que precisa, no número de vídeos que planeia processar, nas suas competências técnicas e no formato de saída que prefere. Ferramentas sem código são mais fáceis para iniciantes, APIs de scraper funcionam bem para fluxos de trabalho automatizados e ferramentas Python oferecem mais controlo. Deve também considerar a precisão dos dados, manutenção, regras do YouTube e se a ferramenta pode exportar dados para CSV, JSON ou para a sua base de dados.
 Ferramentas Gratuitas
 Cookie Plugin
 Gerador de UA
 Gerador de Endereço MAC
 Gerador de Endereço IP
 Lista de Endereços IP
 Gerador de Código 2FA
 Relógio Mundial
 Verificação de Anonimato
 WebRTC Leak Test
 Gerador de UUID
 Verificador de Proxy
 Verificador de Anúncios FB
 Coleta Web com IA
 Ferramentas SMM Grátis
 Verificador de Shadowban do Twitter
 Verificador de Nomes do Instagram
 Gerador UTM
 Gerador de nomes de usuário
 Gerador de hashtags com IA
 Gerador de títulos para LinkedIn
 Redimensionador de imagens sociais