YouTube enthält eine riesige Menge an öffentlichen Informationen, die Content-Recherche, Konkurrenzverfolgung, Zielgruppenanalyse und Marktforschung unterstützen können. Videotitel, Beschreibungen, Aufrufe, Kommentare, Kanalinformationen, Upload-Daten und verfügbare Transkripte können alle nützliche Muster aufzeigen. Das Problem ist, dass das manuelle Sammeln dieser Informationen unrealistisch wird, sobald man Daten aus Hunderten oder Tausenden von Videos benötigt.
Ein YouTube Scraper hilft, diese Arbeit in einen strukturierten Prozess zu verwandeln. Anstatt jedes Video zu öffnen und Informationen in eine Tabelle zu kopieren, kann ein Scraping-Tool ausgewählte Felder sammeln und sie als CSV, JSON oder ein anderes Format speichern. Je nach Projekt können Nutzer No-Code-YouTube-Scraping-Tools, Scraper-APIs, Python-Bibliotheken oder die offizielle YouTube Data API wählen.
Bevor man irgendeine Methode verwendet, ist es wichtig, die Regeln von YouTube zu verstehen. Die API-Entwicklerrichtlinien von YouTube besagen, dass API-Clients keine YouTube-Anwendungen scrapen oder gescrapte YouTube-Daten erhalten dürfen, außer wenn die Regeln von YouTube dies ausdrücklich erlauben. Wenn die benötigten Informationen bereits über die offizielle API verfügbar sind, ist dies in der Regel die erste Option, die es wert ist, überprüft zu werden.
Wenn Sie neu in dieser Art der Datenerhebung sind, kann es auch helfen, zunächst grundlegende Web-Scraping-Konzepte zu verstehen. Der Rest dieses Leitfadens konzentriert sich darauf, wie ein YouTube-Scraper funktioniert, welche Tools im Jahr 2026 nützlich sind, wie man verschiedene Arten von YouTube-Daten sammelt und welche Probleme Sie erwarten sollten.
Was ist ein YouTube-Scraper und welche Daten kann er extrahieren?
Ein YouTube Scraper ist ein Werkzeug oder Skript, das Informationen zu YouTube-Videos, Kanälen, Kommentaren, Suchergebnissen oder Transkripten sammelt. Die gesammelten Daten werden üblicherweise in ein strukturiertes Format umgewandelt, sodass sie gesucht, gefiltert oder analysiert werden können. Dies kann viel Zeit sparen, wenn das Projekt mehr Daten enthält, als eine Person vernünftigerweise von Hand kopieren könnte.
Nicht jeder Scraper funktioniert auf die gleiche Weise. Einige Tools lesen Informationen von YouTube-Webseiten, während andere Drittanbieterdienste oder Browserautomatisierung nutzen. Die offizielle YouTube Data API verfolgt einen anderen Ansatz, indem sie Entwicklern dokumentierten Zugang zu unterstützten YouTube-Ressourcen gewährt.
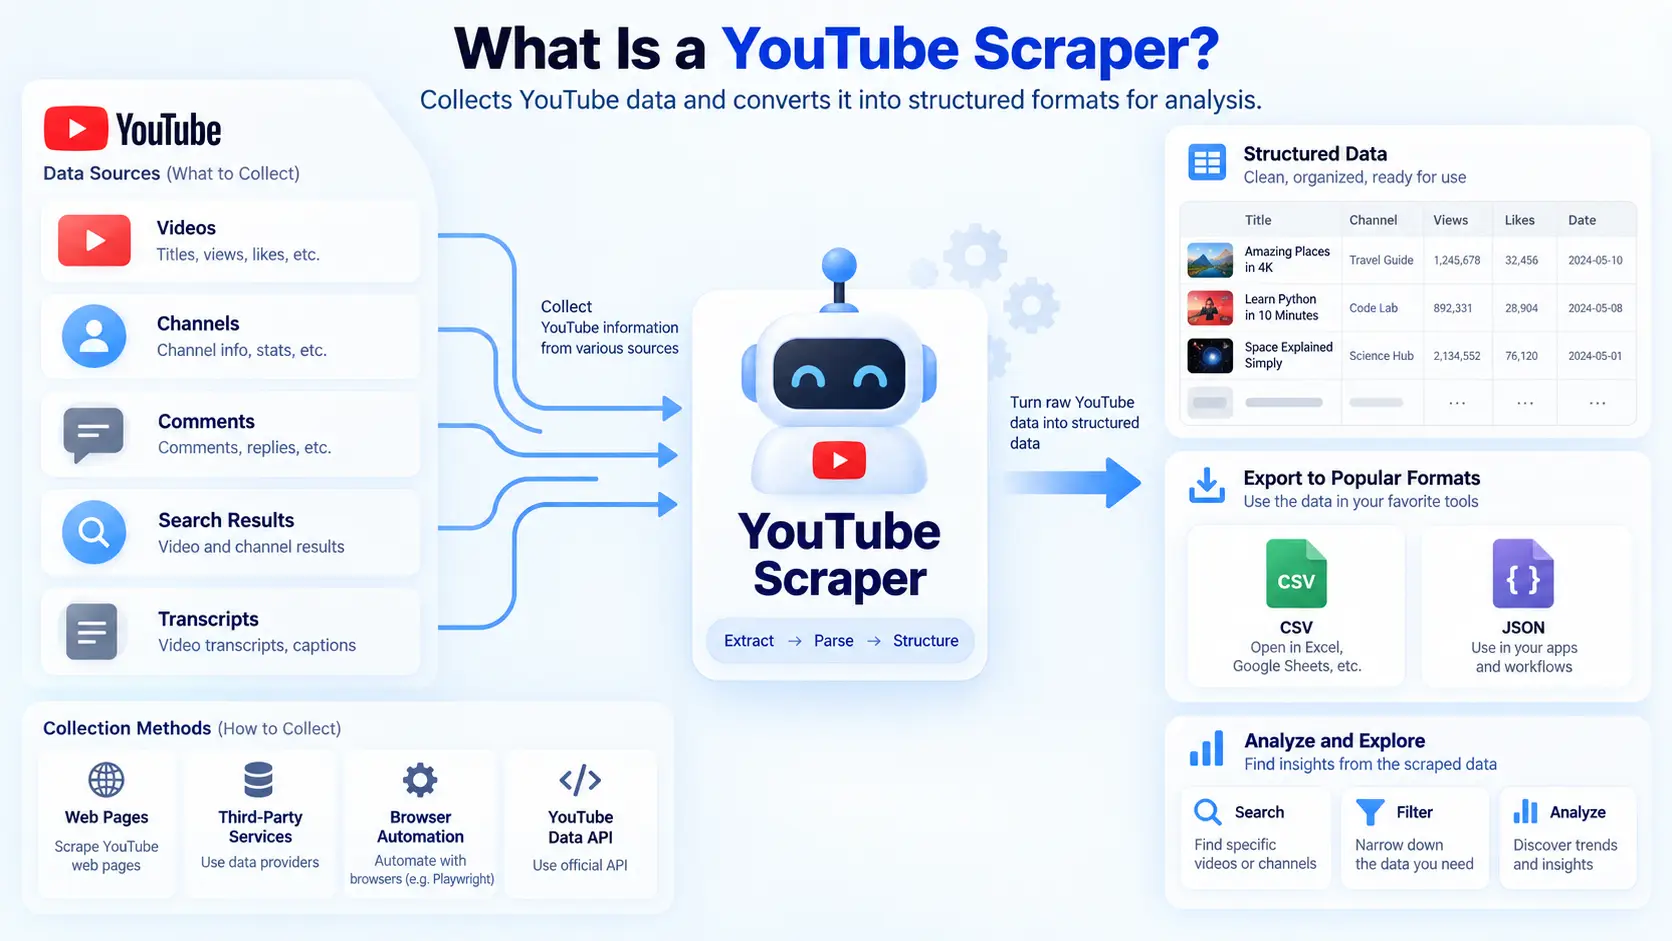
Wie ein YouTube-Scraper funktioniert
Die meisten YouTube-Scraper-Workflows beginnen mit einer Eingabe. Diese Eingabe kann eine Video-URL, Kanal-URL, Playlist, Schlüsselwort oder eine Liste von Video-IDs sein. Der Scraper sucht dann nach bestimmten Feldern, extrahiert die Werte und speichert sie in einem strukturierten Ergebnis.
Stellen Sie sich vor, ein Marketingteam möchte 300 Videos über KI-Schreibwerkzeuge studieren. Das manuelle Öffnen jedes Videos würde Stunden dauern, und das Team könnte leicht Details übersehen oder Zahlen falsch kopieren. Ein Scraper kann Felder wie Videotitel, Kanalname, Veröffentlichungsdatum, Aufrufe, Likes, Beschreibung und Video-ID in einem einzigen wiederholbaren Workflow sammeln.
Einige YouTube-Scraping-Tools funktionieren über die Website selbst. Andere nutzen APIs, um strukturierte Daten anzufordern. Die offizielle YouTube Data API bietet beispielsweise Endpunkte für Videos, Kanäle, Playlists, Kommentare und Kommentarthreads. Die Methode videos.list kann Felder wie Titel, Beschreibung, Kanal-ID, Tags und Statistiken zurückgeben, wenn diese angefordert werden.
Der Unterschied ist wichtig, weil seitenbasierte Tools davon abhängen, wie YouTube-Seiten aufgebaut sind. Wenn YouTube seine Seitenstruktur oder den internen Datenfluss ändert, muss möglicherweise ein Scraper aktualisiert werden. API-basierte Methoden liefern in der Regel sauberere strukturierte Daten, aber sie kommen mit Quoten, Berechtigungen und Plattformregeln verbunden.
Welche YouTube-Daten können gescrapt werden?
Die Art der Daten, die Sie sammeln können, hängt vom Tool ab. Für Videorecherche gehören gängige Felder zu den üblichen Feldern Videotitel, Beschreibungen, URLs, Video-IDs, Kanalnamen, Veröffentlichungsdaten, Dauern, Aufrufe, Likes, Kommentaranzahl, Tags und Kategorien. Diese Felder können Inhaltsanalyse, Themenrecherche und Wettbewerberüberwachung unterstützen.
Kommentare sind ein weiteres häufiges Ziel. Ein YouTube-Kommentar-Scraper kann Kommentartexte, Benutzernamen, Daten, Like-Zahlen, Antwortzahlen und Kommentar-IDs sammeln. Der offizielle commentThreads.list Endpunkt kann auch Kommentar-Threads zurückgeben und unterstützt die Paginierung, wenn weitere Ergebnisse verfügbar sind.
Diese Daten können in einem echten Marketingprojekt nützlich sein. Zum Beispiel könnte ein Softwareunternehmen Kommentare aus mehreren Bewertungsvideos zu seinem eigenen Produkt und konkurrierenden Tools sammeln. Das Team könnte dann nach wiederholten Beschwerden wie hohen Preisen, schwieriger Einrichtung, fehlenden Funktionen oder schlechtem Support suchen, was Produktprobleme aufdecken kann, die allein durch die Aufrufzahlen nicht offensichtlich sind.
Transkripte können eine weitere Informationsebene bieten. Ein YouTube-Transkript-Scraper kann verfügbare Bildunterschriften in durchsuchbaren Text umwandeln, was es erleichtert, zu analysieren, worüber Ersteller tatsächlich in einem Video sprechen. Dies kann bei der Keyword-Recherche, der Themenentdeckung, der Analyse von Wettbewerberinhalten und der groß angelegten Textklassifikation helfen.
Der Zugriff auf das Transkript ist weniger vorhersehbar als grundlegende Metadaten. Einige Videos haben keine Untertitel, andere verwenden automatisch generierte Untertitel, und manche Transkriptmethoden sind auf inoffizielle Schnittstellen angewiesen. Urheberrecht und erlaubte Nutzung sollten ebenfalls berücksichtigt werden, bevor große Mengen an Transkripttext gespeichert oder neu veröffentlicht werden.
YouTube Scraper vs. YouTube API
Ein YouTube-Scraper und die YouTube Data API können manchmal ähnliche Informationen sammeln, sind aber nicht die gleichen Werkzeugtypen. Die offizielle API bietet dokumentierten Zugriff auf unterstützte YouTube-Ressourcen und ist in der Regel leichter zu validieren, da die Felder und Anfragemethoden klar definiert sind. Es ist ein guter Ausgangspunkt, wenn dein Projekt nur Daten benötigt, die YouTube bereits über seine API bereitstellt.
Die Quote ist ein Faktor, den man berücksichtigen sollte. Google gibt derzeit an, dass es videos.list pro Anfrage eine Quoteneinheit kostet und commentThreads.list gleichzeitig eine Einheit. Projekte, die die YouTube Data API nutzen, erhalten in der Regel eine tägliche Quotenzuteilung, und einige Methoden verwenden deutlich mehr Einheiten als einfache Listenanfragen.
Eine Drittanbieter-YouTube-Scraper-API ist möglicherweise bequemer, wenn Sie ein fertiges System möchten, das Anfragen, Wiederholungen, Datenparsing und Export verarbeitet. Dies kann die Entwicklungszeit verkürzen, besonders wenn die Daten direkt in eine Datenbank oder ein Analysetool übertragen werden müssen. Der Nachteil ist, dass Sie auf die Preisgestaltung, unterstützten Felder und Wartung eines anderen Anbieters angewiesen sind.
Die beste Wahl hängt vom Projekt ab und nicht vom Tool-Namen. Wenn die offizielle API bereits die benötigten Videostatistiken bereitstellt, gibt es möglicherweise keinen Grund, einen separaten Scraper zu erstellen. Wenn Ihr Workflow eine andere Ausgabestruktur, Browserinteraktion oder eine andere unterstützte Sammelmethode benötigt, könnte ein Drittanbieter-Tool leichter zu verwalten sein.
Beste YouTube-Scraper-Tools im Jahr 2026
Es gibt keinen einzelnen YouTube-Scraper , der für jeden Nutzer am besten funktioniert. Ein Marketer, der Kommentare zu 20 Videos sammelt, hat ganz andere Anforderungen als ein Entwickler, der Hunderttausende von Datensätzen verarbeitet. Die richtige Wahl hängt von der Datenmenge, der Art der Daten, deinen technischen Fähigkeiten, dem Ausgabeformat und der Häufigkeit der Aufgabe ab.
Für die meisten Nutzer besteht die Hauptwahl zwischen No-Code-Tools, Scraper-APIs und Python-basierten Tools. Jede Option kann gut funktionieren, wenn sie der Größe und Komplexität des Projekts entspricht. Es ist in der Regel besser, zuerst eine kleine Stichprobe zu testen, anstatt ein Tool nur zu wählen, weil es sehr große Jobs unterstützt.
No-Code YouTube-Scraping-Tools
No-Code-YouTube-Scraping-Tools sind nützlich für Marketer, Forscher und Content-Teams, die keine eigenen Skripte erstellen möchten. Diese Tools bieten in der Regel ein Formular oder Dashboard, in dem Nutzer Video-URLs hinzufügen, Datenfelder auswählen, Limits setzen und die Aufgabe ausführen. Die Ergebnisse können dann heruntergeladen oder an einen anderen Dienst gesendet werden.
Apifys YouTube Comments Scraper ist ein Beispiel. Nutzer können eine oder mehrere Video-URLs hinzufügen, die Anzahl der gesammelten Kommentare begrenzen, Kommentare sortieren und die Ergebnisse in Formate wie JSON, CSV oder Excel exportieren. Das Tool sammelt derzeit Informationen wie Kommentartext, Benutzernamen, Veröffentlichungsdaten, Zählungen und Antworten.
Dieses Setup eignet sich gut für die Zielgruppenforschung. Angenommen, eine E-Commerce-Marke möchte Kommentare unter 40 Produktbewertungsvideos untersuchen. Anstatt tausende Kommentare einzeln zu lesen, kann das Team sie in einem Datensatz sammeln und nach wiederholten Produktfragen, Beschwerden oder Kaufbedenken suchen.
Bright Data bietet außerdem eine YouTube-Scraper-API, die über ein Bedienfeld verwendet werden kann, ohne das vollständige Sammlungssystem von Grund auf neu aufbauen zu müssen. Das aktuelle Produkt unterstützt Videos, Kanäle, Kommentare und strukturierte Ausgaben in Formaten wie JSON, NDJSON und CSV. Der Dienst wirbt derzeit mit einer kostenlosen Ausgabe von 5.000 Datensätzen pro Monat an, wobei sich Preise und Limits ändern können.
Für diejenigen, die eine breitere browserbasierte Datenerfassungsoption wünschen, bietet DICloak auch einen KI-Crawler für Webscraping. Er ermöglicht es den Nutzern, eine Seite und Aufgabenanweisungen bereitzustellen, anstatt den gesamten Workflow aus Code zu erstellen. Die eigene Dokumentation von DICloak beschreibt diese Funktion als einen No-Code-Crawler, der extrahierte Informationen in strukturierte Ausgaben organisieren kann.
YouTube-Scraper-APIs
Eine YouTube-Scraper-API passt oft besser, wenn gesammelte Daten direkt in ein anderes System übertragen werden müssen. Anstatt eine Datei manuell herunterzuladen, kann ein Entwickler eine Anfrage senden, strukturierte Daten empfangen und diese in einer Datenbank oder Analysepipeline speichern. Dies erleichtert die Automatisierung wiederkehrender Jobs.
Die offizielle YouTube Data API sollte zuerst überprüft werden. Ein Entwickler könnte eine Liste von Video-IDs speichern und aktualisierte videos.list öffentliche Informationen in einem Zeitplan anfordern. Ein weiterer Prozess könnte verwendet werden commentThreads.list , um Kommentar-Threads für ausgewählte Videos zu sammeln.
Drittanbieter-Scraper-APIs können die Infrastruktur, die ein Team warten muss, verringern. Die aktuelle YouTube Scraper API von Bright Data akzeptiert Ziel-URLs und liefert strukturierte Datensätze zurück, unterstützt zudem API-Aufrufe, Webhooks und Cloud-Delivery. Die Produktseite listet derzeit Python, Node.js, HTTP-Anfragen und mehrere Lieferformate auf.
Eine Scraper-API ist besonders nützlich, wenn das Projekt wiederholt läuft. Zum Beispiel könnte ein Markenüberwachungssystem täglich ausgewählte YouTube-Kanäle überprüfen und neue Datensätze in ein internes Dashboard senden. Der Entwickler muss die Ergebnisse weiterhin validieren, aber der Datenerfassungsschritt wird leichter, um mit dem Rest der Anwendung verbunden zu werden.
Python YouTube-Scraper
Python ist nützlich, wenn man mehr Kontrolle über den Erfassungs- und Verarbeitungsablauf braucht. Ein Python YouTube-Scraper kann mit einer Datenbank verbunden, mit Textanalyse kombiniert oder auf regelmäßige Zeiten ausgestellt werden. Der Hauptkompromiss ist, dass Python-Lösungen in der Regel mehr Wartung erfordern als ein verwalteter Service.
Für Transkriptprojekte youtube-transcript-api ist dies ein bekanntes Beispiel. Die aktuelle Dokumentation besagt, dass manuelle und automatisch generierte Transkripte abgerufen, mit verschiedenen Sprachen arbeiten, unterstützte Transkripte übersetzt und strukturierte Transkriptdaten zurückgegeben werden können. Für den grundlegenden Transkript-Workflow ist der offizielle YouTube-Daten-API-Schlüssel nicht erforderlich.
Dasselbe Projekt gibt auch eine wichtige Warnung. Es verwendet einen nicht dokumentierten Teil des YouTube-Webclients, sodass es keine Garantie gibt, dass die Methode weiterhin funktioniert, wenn YouTube die Benutzeroberfläche ändert. Das macht sie für einige Projekte nützlich, bedeutet aber auch, dass Entwickler mit gelegentlichen Ausfällen und Updates rechnen sollten.
Ein weiteres beliebtes technisches Werkzeug ist yt-dlp. Es kann eine große Bandbreite an Videoinformationen extrahieren, aber jüngste Änderungen bei YouTube haben einige Arbeitsabläufe komplexer gemacht. Das yt-dlp-Projekt dokumentiert derzeit die zunehmende Nutzung von Proof of Origin, oder PO Tokens, durch YouTube und weist darauf hin, dass einige Formate und Funktionen ohne diese möglicherweise nicht funktionieren.
Das ist eine nützliche Erinnerung für alle, die einen eigenen YouTube-Scraper bauen. Ein Skript, das heute funktioniert, funktioniert vielleicht nicht für immer, selbst wenn sich der Code selbst nicht geändert hat. YouTube kann Seitenstrukturen, Anfrageregeln, Tokenanforderungen und interne Endpunkte ändern, daher sollte die Wartung von Anfang an Teil des Plans sein.
Wie man einen YouTube-Scraper benutzt
Ein erfolgreiches Scraping-Projekt beginnt in der Regel mit einer klaren Frage, nicht mit einer langen Liste von URLs. Wenn du nicht weißt, was du lernen möchtest, ist es einfach, große Datenmengen zu sammeln, die nie verwendet werden. Das Ziel zuerst zu definieren, erleichtert es auch, den richtigen YouTube-Scraper und die richtigen Datenfelder auszuwählen.
Fangen Sie klein an, auch wenn Ihr Tool Tausende von Datensätzen verarbeiten kann. Ein kleiner Test erleichtert es Ihnen, fehlende Felder, falsche Formate, doppelte Datensätze oder unerwartete Ergebnisse zu erkennen. Sobald die Testdaten korrekt aussehen, können Sie die Auftragsgröße mit viel mehr Sicherheit erhöhen.
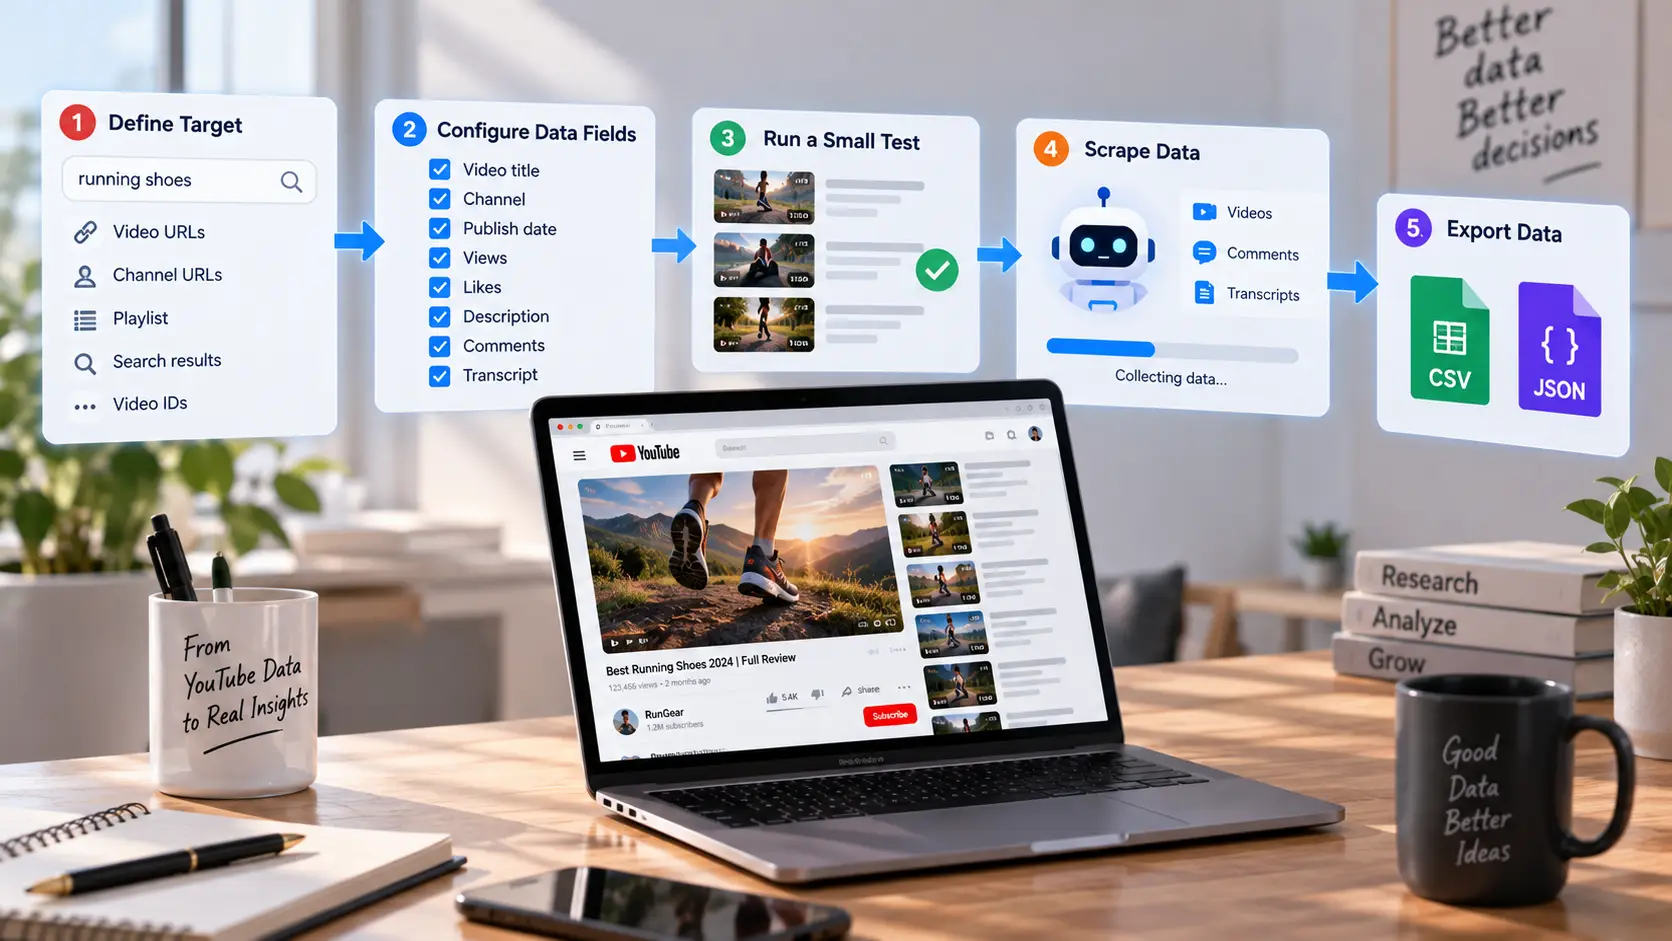
Richten Sie Ihren YouTube-Scraper ein und konfigurieren Sie ihn
Der erste Schritt besteht darin, das Ziel zu definieren. Stellen Sie sich vor, Sie möchten YouTube-Videos über Laufschuhe recherchieren, die in den letzten sechs Monaten veröffentlicht wurden. Sie können mit 100 Video-URLs, mehreren Kanal-URLs oder einer Liste von Video-IDs beginnen, die aus Suchergebnissen gesammelt wurden.
Als Nächstes entscheiden Sie, welche Informationen tatsächlich benötigt werden. Wenn das Ziel die Content-Recherche ist, könnten Videotitel, Kanal, Veröffentlichungsdatum, Aufrufe, Likes, Beschreibung und URL ausreichen. Wenn das Ziel Kundenforschung ist, benötigen Sie möglicherweise auch Kommentare, Antwortzahlen oder Text vom Transkript.
Führe einen kleinen Test durch, bevor du alles sammelst. Zehn Videos reichen normalerweise aus, um zu sehen, ob die Felder korrekt sind und ob Daten fehlen. Öffne ein paar originale YouTube-Seiten und vergleiche die sichtbaren Informationen mit den gescrapten Datensätzen, bevor du dem größeren Datensatz vertraust.
Dieser Schritt mag sich langsam anfühlen, verhindert aber größere Probleme später. Wenn dein Datumsformat bei zehn Datensätzen falsch ist, lässt sich das leicht beheben. Wenn das gleiche Problem nach der Sammlung von 200.000 Datensätzen auftritt, wird die Bereinigung deutlich teurer.
Scrape YouTube-Videos, Kommentare und Transkripte
Videometadaten sind in der Regel die am einfachsten zu sammelnde Art von YouTube-Daten. Die offizielle videos.list Methode kann unterstützte Informationen über Felder wie snippet, statistics, und contentDetailszurückgeben. Dies macht sie nützlich für Projekte, die Videotitel, Daten, Engagement-Zahlen und andere öffentliche Attribute vergleichen.
Kommentare erfordern mehr Planung, da beliebte Videos Tausende von Antworten haben können. Der offizielle commentThreads.list Endpunkt unterstützt Paginierung, und größere Kommentarbereiche erfordern möglicherweise mehrere Anfragen. Wenn Sie einzelne Antworten benötigen, kann der comments.list Endpunkt auch für unterstützte Kommentaraufzeichnungen verwendet werden.
Ein YouTube-Kommentar-Scraper kann diesen Workflow erleichtern, wenn das Ziel Forschung und nicht API-Entwicklung ist. Zum Beispiel könnte eine Marketingagentur Kommentare aus Produktbewertungsvideos sammeln und sie dann nach häufigen Fragen, positiven Reaktionen und negativem Feedback gruppieren. Die Analyse kann aufzeigen, warum Zuschauer ein Produkt mögen und ein anderes ablehnen.
Transkripte sollten normalerweise als separate Aufgabe behandelt werden. Ein YouTube-Transkript-Scraper kann dabei helfen, verfügbare Bildunterschriften in strukturierten Text für Keyword-Recherche, Themenanalyse oder interne Recherche umzuwandeln. Nutzer sollten jedoch sowohl die Verfügbarkeit des Transkripts als auch die zulässige Nutzung prüfen, bevor sie große Mengen urheberrechtlich geschützter Inhalte speichern oder wiederverwenden.
YouTube-Daten in CSV oder JSON exportieren
Sobald du YouTube-Daten gesammelt hast, sollte das Ausgabeformat dem entsprechen, was als Nächstes passiert. CSV funktioniert gut, wenn die Daten flach sind und in Excel, Google Sheets oder einem anderen Tabellenkalkulationstool geöffnet werden. Es ist einfach, Videos nach Datum, Aufrufen, Kanal oder Engagement zu sortieren und die Datei mit nicht-technischen Teammitgliedern zu teilen.
JSON ist oft besser für Entwickler. Es kann verschachtelte Informationen speichern, was hilfreich ist, wenn ein Video mehrere verwandte Felder enthält oder ein Kommentar Antworten enthält. JSON fügt sich auch natürlich in APIs, Datenbanken und automatisierte Verarbeitungspipelines ein.
Stabile Identifikatoren sind in beiden Formaten wichtig. Ein Titel kann sich ändern, und zwei Videos können denselben Titel haben, aber eine Video-ID liefert einen zuverlässigeren Schlüssel. Die gleiche Idee gilt für Kanal-IDs und Kommentar-IDs, wenn sie verfügbar sind.
Es ist auch nützlich, das Sammeldatum oder den Zeitstempel zu speichern. Ein Video kann heute 25.000 Aufrufe und nächsten Monat 80.000 Aufrufe haben, sodass die Zahl wenig Wert hat, ohne zu wissen, wann es gesammelt wurde. Gute YouTube-Datenextraktion bewahrt sowohl Wert als auch Kontext.
Häufige Probleme und Risiken von YouTube-Scrapern
Selbst ein starker YouTube-Scraper kann unvollständige Ergebnisse liefern oder nicht mehr funktionieren. Manchmal ist der Scraper defekt, aber manchmal haben sich die Quelldaten geändert oder sind verschwunden. Das Verständnis des Unterschieds macht die Fehlersuche viel schneller.
Zuverlässigkeit bedeutet nicht nur, ein Skript am Laufen zu halten. Sie müssen auch wissen, ob die Daten vollständig, aktuell und nach den für die Plattform und Ihr Projekt geltenden Regeln gesammelt werden. Dies ist besonders wichtig, wenn die Ergebnisse für Geschäftsentscheidungen verwendet werden.
Warum YouTube-Scraper nicht mehr funktionieren
Seitenbasierte YouTube-Scraping-Tools hängen von der Struktur der YouTube-Seiten und internen Anfragen ab. Wenn YouTube ändert, wie ein Wert geladen wird, findet ein Scraper möglicherweise nicht mehr dasselbe Feld. Dies kann auch passieren, wenn URL und sichtbare Seite fast identisch aussehen.
Inoffizielle Bibliotheken haben ein ähnliches Problem. Das youtube-transcript-api Projekt stellt klar fest, dass es auf einer nicht dokumentierten Oberfläche basiert, die vom YouTube-Webclient verwendet wird. Wenn YouTube diese Oberfläche ändert, kann das Tool vorübergehend aufhören zu funktionieren, bis das Projekt aktualisiert wird.
Technische Änderungen können auch Video-Extraktionswerkzeuge beeinflussen. Das yt-dlp-Projekt dokumentiert derzeit die umfassendere Durchsetzung von PO Tokens für einige YouTube-Anfragen und warnt, dass einige Funktionen ohne das erforderliche Token möglicherweise nicht verfügbar sind. Dies zeigt, warum Scraping-Tools regelmäßige Aktualisierungen benötigen, anstatt als permanente Skripte behandelt zu werden.
Nicht jedes fehlende Ergebnis ist ein technischer Fehler. Ein Video kann privat geworden sein, Kommentare können deaktiviert sein oder Untertitel fehlen. Überprüfen Sie, bevor Sie Ihren Code ändern, ob die Originalquelle noch die erwarteten Informationen liefert.
Wie man die Genauigkeit und Stabilität des Abkratzes verbessert
Der einfachste Weg, die Genauigkeit zu verbessern, besteht darin, eine kleine Stichprobe manuell zu validieren. Vergleichen Sie mehrere gescrapte Datensätze mit den ursprünglichen YouTube-Seiten oder offiziellen API-Antworten. Wenn die Zahlen oder Texte nicht übereinstimmen, finden Sie den Grund, bevor Sie die Größe des Auftrags erhöhen.
Behalte die Rohausgabe sowie die bereinigte Version. Datenverarbeitung kann eigene Fehler verursachen, besonders wenn Skripte Daten ändern, Duplikate entfernen, Text übersetzen oder mehrere Felder kombinieren. Das Speichern der ursprünglichen Antwort gibt dir etwas, zu dem du zurückgreifen kannst, wenn ein später Schritt unerwartete Ergebnisse liefert.
Große Aufträge sollten auch gescheiterte Ziele aufzeichnen, anstatt sie stillschweigend zu ignorieren. Wenn Sie 10.000 Video-IDs senden und 9.600 Datensätze erhalten, sollten die fehlenden 400 in einem Fehlerprotokoll gespeichert werden. Andernfalls kann Ihr endgültiger Datensatz vollständig erscheinen, obwohl eine wichtige Gruppe von Videos fehlt.
Bei wiederkehrenden Projekten trennen Sie die Sammlung von der Analyse. Zuerst sammeln und speichern Sie die Quelldaten, dann führen Sie als zweiten Schritt Reinigung, Klassifizierung, Sentiment-Analyse oder Reporting durch. Das macht es viel einfacher zu erkennen, ob ein Problem vom YouTube-Scraper oder vom eigenen Verarbeitungscode stammt.
YouTube Scraping-Grenzen und Compliance
YouTube-Scraping hat technische Grenzen, aber auch politische Grenzen. Die API-Entwicklerrichtlinien von YouTube besagen, dass API-Clients YouTube-Anwendungen nicht direkt oder indirekt scrapen oder gescrapte YouTube-Daten erhalten dürfen. Entwickler, die die offizielle API nutzen, müssen außerdem die API-Bedingungen, Datenschutzregeln, Sicherheitsanforderungen und Datenverarbeitungsrichtlinien von YouTube einhalten.
Datenschutz verdient besondere Aufmerksamkeit, wenn Kommentare oder Nutzerinformationen im Spiel sind. Die Entwicklerrichtlinien von YouTube besagen, dass API-Clients keine identifizierenden Nutzerdaten ohne Zustimmung sammeln oder speichern sollten und die Privatsphäre der Nutzer respektieren müssen. Das Sammeln nur der tatsächlich benötigten Felder kann sowohl das Risiko als auch die unnötige Datenspeicherung verringern.
Zum Beispiel benötigt eine Sentiment-Studie möglicherweise nur Kommentartext, Datum und Engagement-Informationen. Möglicherweise muss der Benutzername einer Person monatelang nicht gespeichert werden. Die Frage, ob jedes Feld wirklich notwendig ist, ist eine einfache Möglichkeit, einen übersichtlicheren Forschungsworkflow zu schaffen.
Transkripte erfordern ähnliche Sorgfalt. Öffentlich sichtbare Bildunterschriften sind weiterhin Inhalt, und das Sammeln von Texten für interne Themenanalysen unterscheidet sich vom Kopieren vollständiger Transkripte und deren Weiterveröffentlichung an anderer Stelle. Ein zuverlässiger YouTube-Scraper-Workflow sollte technische Genauigkeit, Plattformregeln, Datenschutz und Urheberrecht gemeinsam berücksichtigen.
Verbessern Sie das YouTube-Scraping mit DICloak
Für einige Teams ist die Datenerfassung nur ein Teil des Problems. Sie müssen möglicherweise auch verschiedene Browsersitzungen, Proxy-Einstellungen, Client-Projekte und Automatisierungsskripte verwalten, ohne alles zu vermischen. In diesen Fällen kann die Organisation des Browsers genauso wichtig sein wie der Scraper selbst.
DICloak kann als Browser-Management-Ebene für genehmigte Daten-Workflows fungieren. Sein Hauptwert besteht hier darin, die YouTube Data API nicht zu ersetzen oder die Regeln von YouTube zu ändern. Es bietet Browser-Profile, Proxy-Konfiguration und lokale API-Tools, die helfen können, verschiedene browserbasierte Projekte organisiert zu halten.
Wenn Browser-Isolation Teil Ihres Forschungssetups ist, erklärt dieser Leitfaden zu einem Antidetect-Browser für Webscraping , wie separate Browserprofile in größere Daten-Workflows passen können. Die gleiche Idee kann nützlich sein, wenn mehrere Projekte oder Teammitglieder eigene Einstellungen und Sitzungen benötigen.
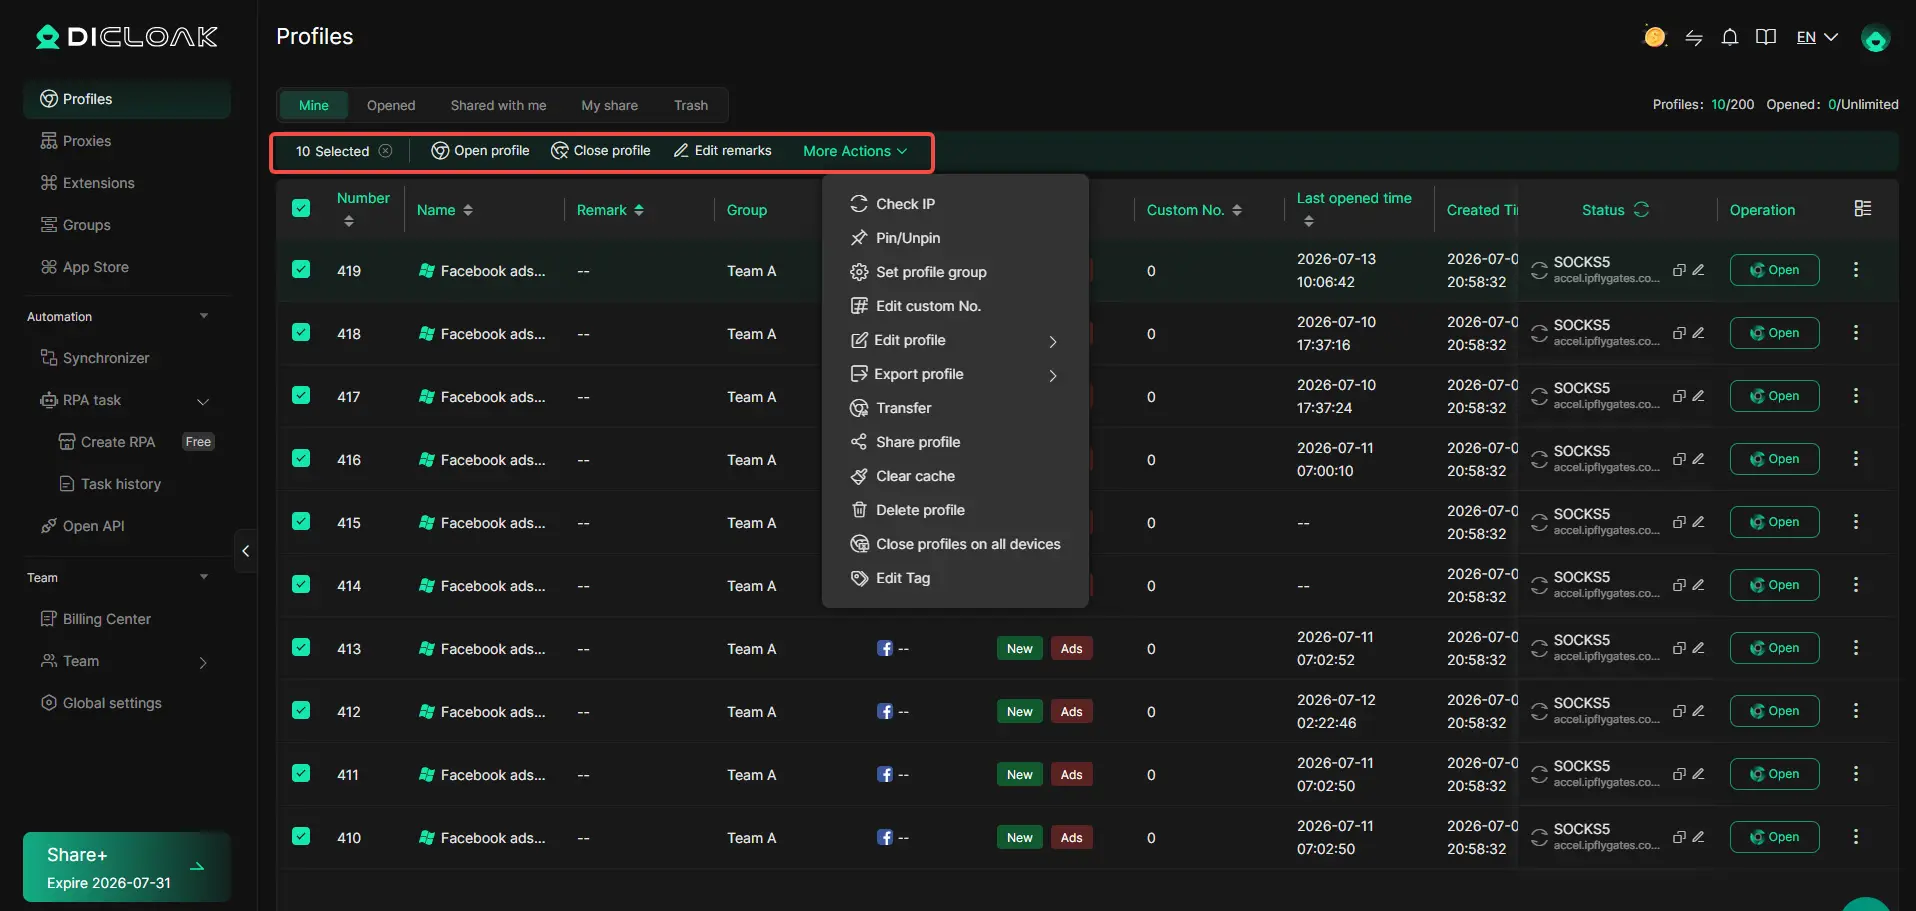
Separate Scraping-Aufgaben mit Browser-Profilen
DICloak verwendet separate Browserprofile, um Browserdaten und -einstellungen zu organisieren. Die lokale API kann Browserprofile auflisten und sie nach Informationen wie Gruppe, Proxy-Typ, Proxy-Host, Ausgangs-IP, Status und Plattform filtern. Dies gibt Teams eine klarere Möglichkeit, ein Forschungsprojekt von einem anderen zu trennen.
Beispielsweise könnte ein Forschungsteam ein Browserprofil für ein Konkurrentenanalyseprojekt und ein anderes zum Testen eines browserbasierten Datentools verwenden. Ein separates Profil könnte einem Kundenprojekt zugewiesen werden, damit Cookies, Sitzungen und Browsereinstellungen nicht mit nicht zusammenhängenden Aufgaben vermischt werden.
Dieser Ansatz ist auch nützlich, wenn mehr als eine Person am selben Forschungsprozess arbeitet. Anstatt jede Aufgabe in einem normalen Browser zu öffnen, kann jedes Projekt sein eigenes Profil und eigene Einstellungen haben. Der Vorteil ist eine übersichtlichere Organisation, nicht eine aggressivere Datenerhebung.
Proxys für YouTube-Scraping konfigurieren
DICloak unterstützt verschiedene Proxy-Modi auf Browser-Profil-Ebene. Die aktuelle Dokumentation listet No Proxy, Custom Proxy, Saved Proxies und API-Extraktion auf, während die Local API Proxy-Typen wie HTTP, HTTPS und SOCKS5 unterstützt.
Dies kann Teams helfen, Netzwerkeinstellungen an das richtige Projekt zu binden. Zum Beispiel kann eine browserbasierte Forschungsaufgabe eine Firmennetzwerkverbindung verwenden, während ein anderes genehmigtes regionales Projekt eine spezifische Proxy-Konfiguration verwendet. Wenn diese Einstellungen in separaten Profilen bleiben, lassen sich versehentliche Konfigurationsänderungen leichter vermeiden.
Für Nutzer, die mehr Hintergrund benötigen, behandeln DICloaks Inhalte zu Proxy- und Webscraping-Workflows Proxy-bezogene Themen wie Scraping-Infrastruktur und Netzwerkleistung. Ein Proxy sollte weiterhin als Netzwerkwerkzeug behandelt werden und nicht als Möglichkeit, Plattformbeschränkungen zu ignorieren.
Die gleiche Regel gilt für einen YouTube-Scraper. Die Änderung des Netzwerkpfads ändert weder die Richtlinien, Urheberrechtsregeln noch Datenschutzverpflichtungen von YouTube. Das Ziel sollte eine stabile und organisierte Infrastruktur für erlaubte Aufgaben sein.

Integriere DICloak mit Python und APIs
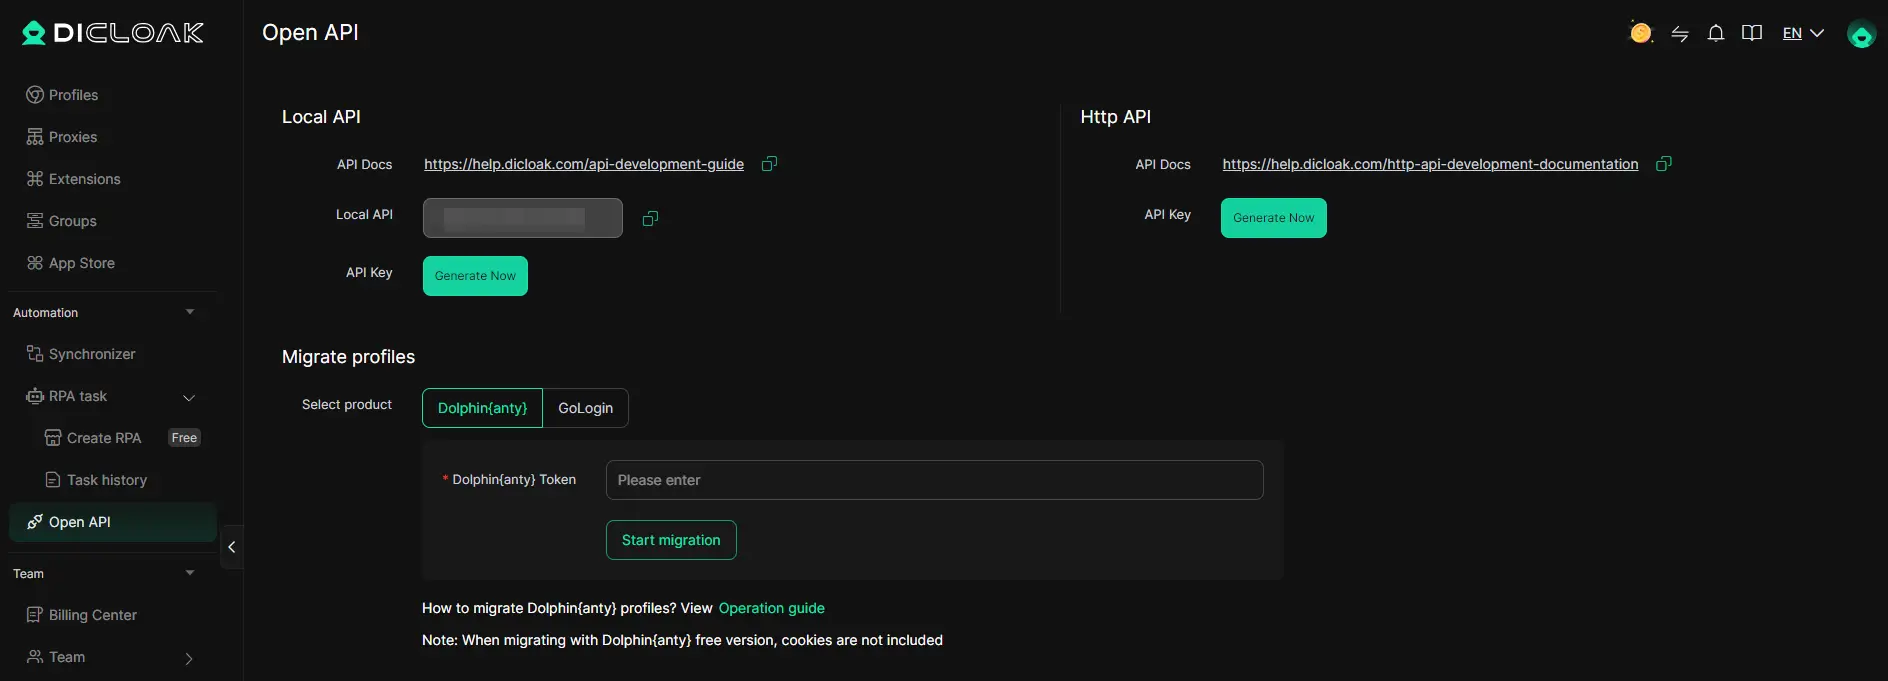
Technische Teams können DICloak über die Local Open API mit ihrer eigenen Automatisierung verbinden. Der aktuelle Entwicklungsleitfaden enthält Beispiele für Python mit Playwright und ChromeDriver, Node.js mit Puppeteer und Java mit ChromeDriver. Er dokumentiert außerdem Aktionen wie das Auflisten von Browser-Profilen, deren Öffnen, das Verbinden von Automatisierungstools, die Interaktion mit Browserfenstern und das Schließen von Sitzungen.
Dies kann in einen größeren Python-Workflow passen, wenn eine Browserinteraktion erforderlich ist. Ein Skript könnte ein bestimmtes Browserprofil über die lokale API anfordern, dieses Profil öffnen, Playwright verbinden, eine genehmigte Browseraufgabe abschließen, das Ergebnis speichern und das Profil schließen. Der Datenverarbeitungsteil kann dann in Python fortgesetzt werden, ohne Browser-Management-Logik in jeden Schritt zu integrieren.
Die Browser Profile API und die Proxy-Schnittstelle von DICloak ermöglichen es außerdem, Profil- und Netzwerkkonfigurationen programmatisch zu lesen. Das kann größeren Teams helfen, Namens-, Gruppierungs-, Proxy-Zuweisungs- und Automatisierungsregeln in vielen Projekten konsistent zu halten.
Die zuverlässigste Einrichtung ist in der Regel eine geschichtete Einrichtung. Nutzen Sie die offizielle YouTube Data API, wenn sie bereits die benötigten Informationen liefert, wählen Sie eine geeignete YouTube-Scraper-API oder ein anderes erlaubtes Tool, wenn das Projekt einen anderen Workflow benötigt, und verwenden Sie Browserprofile nur, wenn browserbasierte Arbeit sie tatsächlich benötigt. Das macht den Prozess leichter zu testen, leichter zu pflegen und für ein Team viel leichter verständlich.
FAQs zu YouTube Scraper
F1: Was ist ein YouTube-Scraper?
Ein YouTube Scraper ist ein Werkzeug oder Skript, das öffentliche Daten von YouTube sammelt, wie Videotitel, Beschreibungen, Aufrufe, Kommentare, Kanalinformationen, Veröffentlichungsdaten und verfügbare Transkripte. Die Daten können dann in Formaten wie CSV oder JSON für Recherche, Analyse oder Berichterstattung gespeichert werden.
F2: Welche Daten kann ein YouTube-Scraper sammeln?
Ein YouTube-Scraper kann je nach Tool verschiedene Arten von Daten sammeln. Gängige Beispiele sind Video-Metadaten, Kanalinformationen, Kommentare, Antwortzahlen, Suchergebnisse, Playlists, Engagement-Daten und Transkripte. Einige YouTube-Scraping-Tools erlauben es den Nutzern auch, nur die benötigten Felder auszuwählen.
F3: Ist ein YouTube Scraper dasselbe wie die YouTube Data API?
Nein. Ein YouTube Scraper kann Informationen von Webseiten, Browserautomatisierung oder Drittanbieter-Scraping-Diensten sammeln, während die YouTube Data API offiziellen und dokumentierten Zugriff auf unterstützte YouTube-Daten bietet. Wenn die benötigten Informationen über die offizielle API verfügbar sind, lohnt es sich in der Regel, diese Option zuerst zu prüfen.
F4: Kann ein YouTube-Scraper Kommentare und Transkripte sammeln?
Ja, einige YouTube-Scraper-Tools können Kommentare, Antworten und verfügbare Transkripte sammeln. Ein YouTube-Kommentar-Scraper kann bei der Publikums- oder Sentiment-Recherche helfen, während ein YouTube-Transkript-Scraper verfügbare Bildunterschriften in strukturierten Text umwandeln kann. Kommentare können jedoch deaktiviert sein und einige Videos enthalten möglicherweise keine Transkriptionen.
F5: Wie wähle ich 2026 den besten YouTube-Scraper aus?
Wähle einen YouTube-Scraper basierend auf den benötigten Daten, der Anzahl der Videos, die du verarbeiten möchtest, deinen technischen Fähigkeiten und dem bevorzugten Ausgabeformat. No-Code-Tools sind für Anfänger einfacher, Scraper-APIs funktionieren gut für automatisierte Workflows, und Python-Tools bieten mehr Kontrolle. Du solltest auch Datengenauigkeit, Wartung, YouTube-Regeln und die Frage, ob das Tool Daten in CSV, JSON oder deine Datenbank exportieren kann, berücksichtigen.
 Kostenlose Werkzeuge
 Cookie-Erweiterung
 UA Generator
 MAC-Adressen-Generator
 IP-Generator
 IP-Adressliste
 2FA-Code-Generator
 Weltuhr
 Anonymer Check
 WebRTC Leak Test
 UUID-Generator
 Proxy-Checker
 FB Anzeigenprüfer
 KI-Web-Scraping
 Kostenlose SMM-Tools
 Twitter Shadowban-Checker
 UTM Generator
 Username Generator
 AI Hashtag Generator
 LinkedIn Headline Generator
 Bildgrößen-Tool für Social Media