YouTube contiene una enorme cantidad de información pública que puede apoyar la investigación de contenidos, el seguimiento de competidores, el análisis de audiencias y la investigación de mercado. Títulos de vídeos, descripciones, visualizaciones, comentarios, información del canal, fechas de subida y transcripciones disponibles pueden revelar patrones útiles. El problema es que recopilar esta información a mano se vuelve irrealista cuando necesitas datos de cientos o miles de vídeos.
Un Scraper de YouTube ayuda a convertir este trabajo en un proceso estructurado. En lugar de abrir cada vídeo y copiar información en una hoja de cálculo, una herramienta de scraping puede recopilar campos seleccionados y guardarlos en formato CSV, JSON u otro formato. Dependiendo del proyecto, los usuarios pueden elegir herramientas de scraping sin código para YouTube, APIs de scraper, bibliotecas Python o la API oficial de datos de YouTube.
Antes de usar cualquier método, es importante entender las normas de YouTube. Las Políticas de Desarrollo de API de YouTube establecen que los clientes de API no deben extraer aplicaciones de YouTube ni obtener datos extraídos, salvo cuando las normas de YouTube lo permitan específicamente. Si la información que necesitas ya está disponible a través de la API oficial, esa suele ser la primera opción que merece la pena comprobar.
Si eres nuevo en este tipo de recopilación de datos, entender primero conceptos básicos de web scraping también puede ayudar. El resto de esta guía se centra en cómo funciona un YouTube Scraper , qué herramientas son útiles en 2026, cómo recopilar diferentes tipos de datos de YouTube y qué problemas debes esperar.
¿Qué es un scraper de YouTube y qué datos puede extraer?
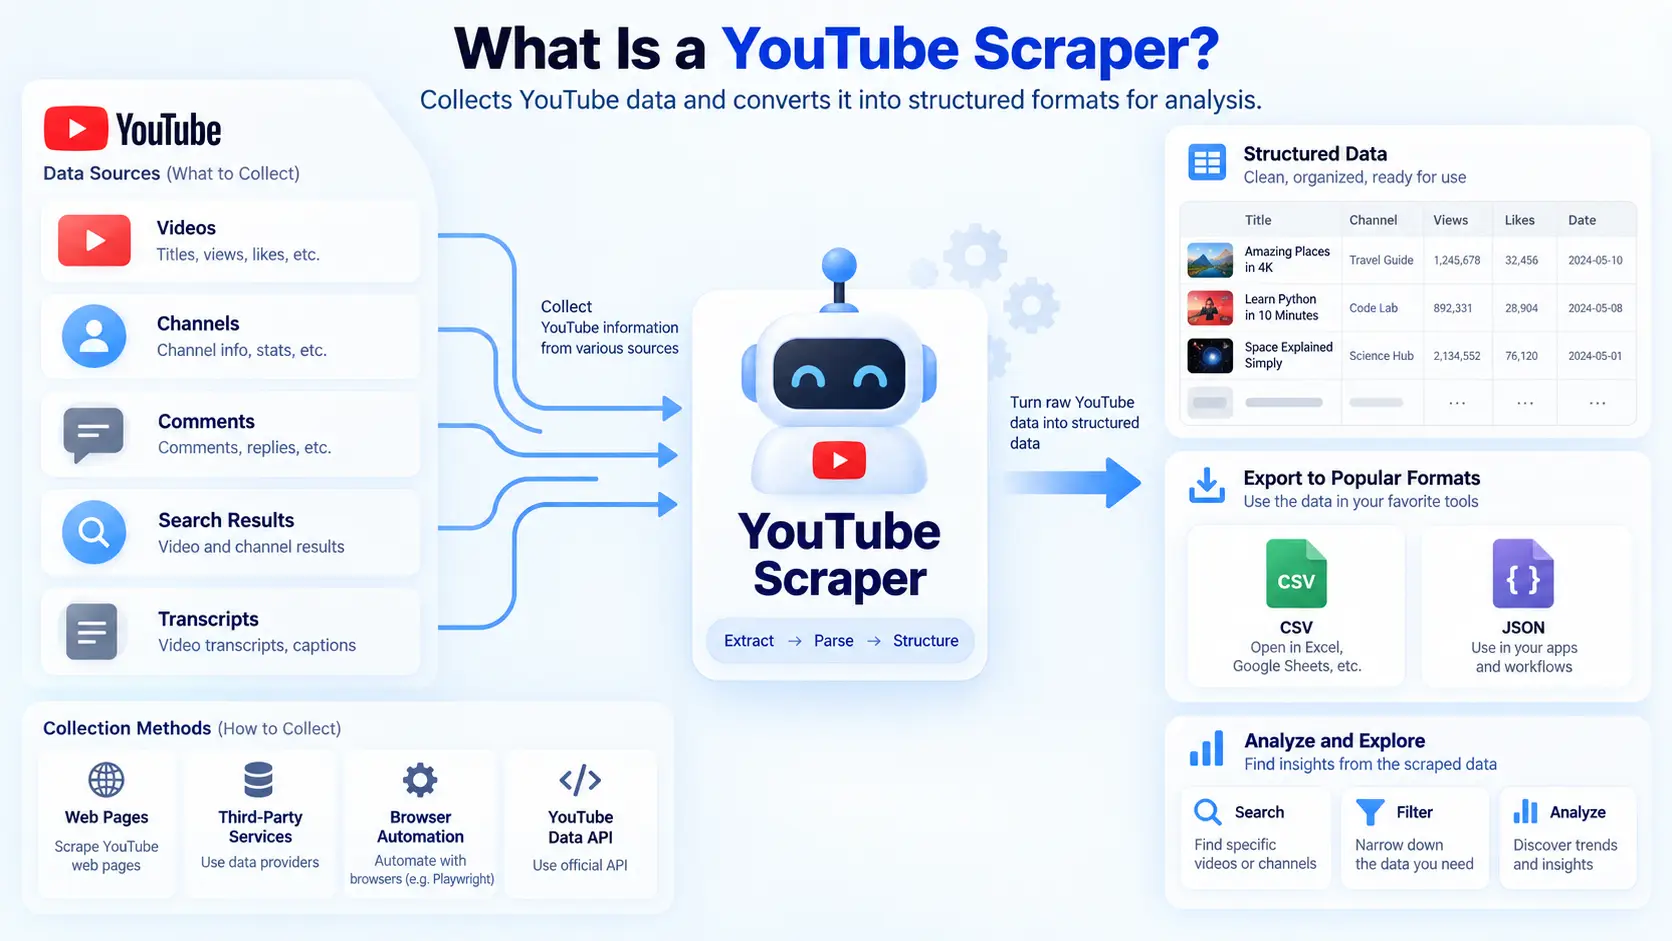
Un YouTube Scraper es una herramienta o script que recopila información relacionada con vídeos de YouTube, canales, comentarios, resultados de búsqueda o transcripciones. Los datos recogidos suelen convertirse en un formato estructurado para poder ser buscados, filtrados o analizados. Esto puede ahorrar mucho tiempo cuando el proyecto implica más datos de los que una persona podría copiar razonablemente a mano.
No todos los scrapers funcionan de la misma manera. Algunas herramientas leen información de páginas web de YouTube, mientras que otras usan servicios de terceros o automatización del navegador. La API oficial de datos de YouTube adopta un enfoque diferente al dar a los desarrolladores acceso documentado a los recursos compatibles con YouTube.
Cómo funciona un raspador de YouTube
La mayoría de los flujos de trabajo del Scraper de YouTube comienzan con una entrada. Esa entrada puede ser una URL de vídeo, URL de canal, lista de reproducción, palabra clave o lista de IDs de vídeo. El scraper busca campos específicos, extrae los valores y los guarda en un resultado estructurado.
Imagina que un equipo de marketing quiere estudiar 300 vídeos sobre herramientas de escritura con IA. Abrir cada vídeo manualmente llevaría horas, y el equipo podría fácilmente pasar por alto detalles o copiar números incorrectamente. Un scraper puede recopilar campos como título del vídeo, nombre del canal, fecha de publicación, visualizaciones, me gusta, descripción e ID del vídeo en un solo flujo de trabajo repetible.
Algunas herramientas de extracción de YouTube funcionan a través del propio sitio web. Otras utilizan APIs para solicitar datos estructurados. La API oficial de datos de YouTube, por ejemplo, proporciona puntos finales para vídeos, canales, listas de reproducción, comentarios y hilos de comentarios. El videos.list método puede devolver campos como título, descripción, ID de canal, etiquetas y estadísticas cuando se solicitan esas partes.
La diferencia importa porque las herramientas basadas en páginas dependen de cómo se construyen las páginas de YouTube. Si YouTube cambia la estructura de su página o el flujo interno de datos, puede que sea necesario actualizar un scraper. Los métodos basados en API suelen devolver datos estructurados más limpios, pero vienen con cuotas, permisos y reglas de plataforma.
¿Qué datos de YouTube se pueden extraer?
El tipo de datos que puedes recopilar depende de la herramienta. Para la investigación en vídeo, los campos comunes incluyen títulos de vídeo, descripciones, URLs, IDs de vídeo, nombres de canales, fechas de publicación, duraciones, visualizaciones, me gusta, conteos de comentarios, etiquetas y categorías. Estos campos pueden apoyar el análisis de contenido, la investigación de temas y la monitorización de la competencia.
Los comentarios son otro objetivo habitual. Un scraper de comentarios de YouTube puede recopilar texto de comentarios, nombres de usuario, fechas, conteos de likes, conteos de respuestas e identificadores de comentarios. El endpoint oficial commentThreads.list también puede devolver hilos de comentarios y soporta la paginación cuando hay más resultados disponibles.
Estos datos pueden ser útiles en un proyecto real de marketing. Por ejemplo, una empresa de software podría recopilar comentarios de varios vídeos de análisis sobre su propio producto y herramientas competidoras. El equipo podría entonces buscar quejas repetidas como precios altos, configuración difícil, funciones ausentes o mal soporte, que podrían revelar problemas de producto que no son evidentes solo por el número de visualizaciones.
Las transcripciones pueden aportar otra capa de información. Un extractor de transcripciones de YouTube puede convertir los pies de foto disponibles en texto buscable, lo que facilita estudiar qué es lo que los creadores realmente comentan dentro de un vídeo. Esto puede ayudar en la investigación de palabras clave, el descubrimiento de temas, el análisis de contenido de la competencia y la clasificación de texto a gran escala.
El acceso a transcripciones es menos predecible que los metadatos básicos. Algunos vídeos no tienen subtítulos, otros usan subtítulos generados automáticamente y algunos métodos de transcripción dependen de interfaces no oficiales. También se deben considerar los derechos de autor y el uso permitido antes de almacenar o republicar grandes cantidades de texto transcrito.
YouTube Scraper vs YouTube API
Un YouTube Scraper y la API de datos de YouTube a veces pueden recopilar información similar, pero no son el mismo tipo de herramienta. La API oficial proporciona acceso documentado a los recursos de YouTube compatibles y suele ser más fácil de validar porque los campos y métodos de solicitud están claramente definidos. Es un buen punto de partida cuando tu proyecto solo necesita datos que YouTube ya expone a través de su API.
La cuota es un factor a considerar. Google actualmente afirma que videos.list cuesta una unidad de cuota por solicitud, mientras commentThreads.list que también cuesta una unidad. Los proyectos que usan la API de datos de YouTube generalmente reciben una asignación diaria de cuota, y algunos métodos usan muchas más unidades que simples solicitudes de lista.
Una API de scraper de YouTube de terceros puede ser más cómoda cuando quieres un sistema ya hecho que gestione solicitudes, reintentos, análisis de datos y exportación. Esto puede reducir el tiempo de desarrollo, especialmente cuando los datos necesitan moverse directamente a una base de datos o herramienta analítica. La desventaja es que dependes del precio, los campos soportados y el mantenimiento de otro proveedor.
La mejor opción depende del proyecto más que del nombre de la herramienta. Si la API oficial ya proporciona las estadísticas de vídeo que necesitas, puede que no haya razón para construir un scraper separado. Si tu flujo de trabajo necesita una estructura de salida diferente, interacción con el navegador u otro método de recopilación compatible, una herramienta de terceros puede ser más fácil de gestionar.
Las mejores herramientas para scraper en YouTube en 2026
No existe un único YouTube Scraper que funcione mejor para todos los usuarios. Un profesional del marketing que recopila comentarios de 20 vídeos tiene necesidades muy diferentes a las de un desarrollador que procesa cientos de miles de registros. La elección correcta depende de la cantidad de datos, el tipo de datos, tus habilidades técnicas, el formato de salida y la frecuencia con la que debe ejecutarse la tarea.
Para la mayoría de los usuarios, la elección principal es entre herramientas sin código, APIs de scraper y herramientas basadas en Python. Cada opción puede funcionar bien cuando se ajusta al tamaño y la complejidad del proyecto. Normalmente es mejor probar primero una muestra pequeña en lugar de elegir una herramienta solo porque afirma soportar trabajos muy grandes.
Herramientas de extracción sin código en YouTube
Las herramientas de scraping sin código en YouTube son útiles para profesionales del marketing, investigadores y equipos de contenido que no quieren crear sus propios scripts. Estas herramientas suelen proporcionar un formulario o panel donde los usuarios añaden URLs de vídeo, eligen campos de datos, establecen límites y ejecutan la tarea. Los resultados pueden descargarse o enviarse a otro servicio.
El Scraper de Comentarios de YouTube de Apify es un ejemplo. Los usuarios pueden añadir una o más URLs de vídeo, limitar el número de comentarios recogidos, ordenar comentarios y exportar los resultados a formatos como JSON, CSV o Excel. Actualmente, la herramienta recopila información como texto de comentarios, nombres de usuario, fechas de publicación, conteos de likes y respuestas.
Esta configuración puede funcionar bien para la investigación de audiencia. Supongamos que una marca de comercio electrónico quiere estudiar comentarios por debajo de 40 vídeos de reseñas de productos. En lugar de leer miles de comentarios uno a uno, el equipo puede recopilarlos en un solo conjunto de datos y buscar preguntas repetidas sobre productos, quejas o preocupaciones de compra.
Bright Data también ofrece una API de YouTube Scraper que puede usarse a través de un panel de control sin construir el sistema completo de recopilación desde cero. Su producto actual soporta vídeos, canales, comentarios y salida estructurada en formatos como JSON, NDJSON y CSV. Actualmente, el servicio anuncia una asignación gratuita de 5.000 registros al mes, aunque los precios y los límites pueden variar.
Para quienes desean una opción más amplia de recogida de datos basada en navegador, DICloak también ofrece un rastreador de IA para el web scraping. Permite a los usuarios proporcionar una página e instrucciones de tarea en lugar de construir todo el flujo de trabajo a partir de código. La propia documentación de DICloak describe esta función como un rastreador sin código que puede organizar la información extraída en una salida estructurada.
YouTube Scraper APIs
Una API de scraper de YouTube suele ser más adecuada cuando los datos recogidos necesitan trasladarse directamente a otro sistema. En lugar de descargar un archivo manualmente, un desarrollador puede enviar una solicitud, recibir datos estructurados y almacenarlos en una base de datos o en una cadena de análisis. Esto facilita la automatización de trabajos recurrentes.
La API oficial de datos de YouTube debería revisarse primero. Un desarrollador podría almacenar una lista de IDs de vídeo y usarla videos.list para solicitar información pública actualizada en un calendario. Otro proceso podría usarse commentThreads.list para recopilar hilos de comentarios para vídeos seleccionados.
Las APIs de scraper de terceros pueden reducir la cantidad de infraestructura que un equipo necesita mantener. La API actual de Bright Data para YouTube Scraper acepta URLs de destino y devuelve registros estructurados, además de dar soporte a llamadas a API, webhooks y entrega en la nube. Su página de producto actualmente lista Python, Node.js, solicitudes HTTP y múltiples formatos de entrega.
Una API de scraper es especialmente útil cuando el proyecto se ejecuta repetidamente. Por ejemplo, un sistema de monitorización de marca podría revisar canales seleccionados de YouTube cada día y enviar nuevos registros a un panel interno. El desarrollador aún necesita validar los resultados, pero el paso de recogida de datos se vuelve más fácil de conectar con el resto de la aplicación.
Python YouTube Scrapers
Python es útil cuando necesitas más control sobre el flujo de trabajo de recopilación y procesamiento. Un scraper de YouTube en Python puede conectarse a una base de datos, combinarse con análisis de texto o programarse para ejecutarse en horarios regulares. El principal inconveniente es que las soluciones de Python suelen requerir más mantenimiento que un servicio gestionado.
Para proyectos de transcripciones, youtube-transcript-api es un ejemplo bien conocido. Su documentación actual dice que puede recuperar transcripciones manuales y generadas automáticamente, trabajar con diferentes idiomas, traducir transcripciones soportadas y devolver datos estructurados de transcripciones. No requiere la clave oficial de la API de datos de YouTube para su flujo de trabajo básico de transcripciones.
El mismo proyecto también da una advertencia importante. Utiliza una parte no documentada del cliente web de YouTube, así que no hay garantía de que el método siga funcionando si YouTube cambia la interfaz. Eso lo hace útil para algunos proyectos, pero también significa que los desarrolladores deben esperar fallos y actualizaciones ocasionales.
Otra herramienta técnica popular es yt-dlp. Puede extraer una amplia gama de información de vídeo, pero los cambios recientes en YouTube han hecho que algunos flujos de trabajo sean más complejos. El proyecto yt-dlp documenta actualmente el uso creciente de Proof of Origin, o PO Tokens, en YouTube, y señala que algunos formatos y funciones pueden no funcionar sin ellos.
Este es un recordatorio útil para cualquiera que esté construyendo un YouTube Scraper personalizado. Un script que funciona hoy puede no funcionar para siempre, incluso si el código en sí no ha cambiado. YouTube puede cambiar la estructura de las páginas, las reglas de solicitud, los requisitos de tokens y los endpoints internos, así que el mantenimiento debería formar parte del plan desde el principio.
Cómo usar un raspador de YouTube
Un proyecto de scraping exitoso suele empezar con una pregunta clara, no con una lista extensa de URLs. Si no sabes lo que quieres aprender, es fácil recopilar grandes cantidades de datos que nunca se usan. Definir primero el objetivo también facilita elegir el YouTube Scraper adecuado y los campos de datos adecuados.
Empieza poco a poco aunque tu herramienta pueda procesar miles de registros. Una pequeña prueba facilita detectar campos faltantes, formatos incorrectos, registros duplicados o resultados inesperados. Una vez que los datos de la prueba sean correctos, puedes aumentar el tamaño del trabajo con mucha más confianza.
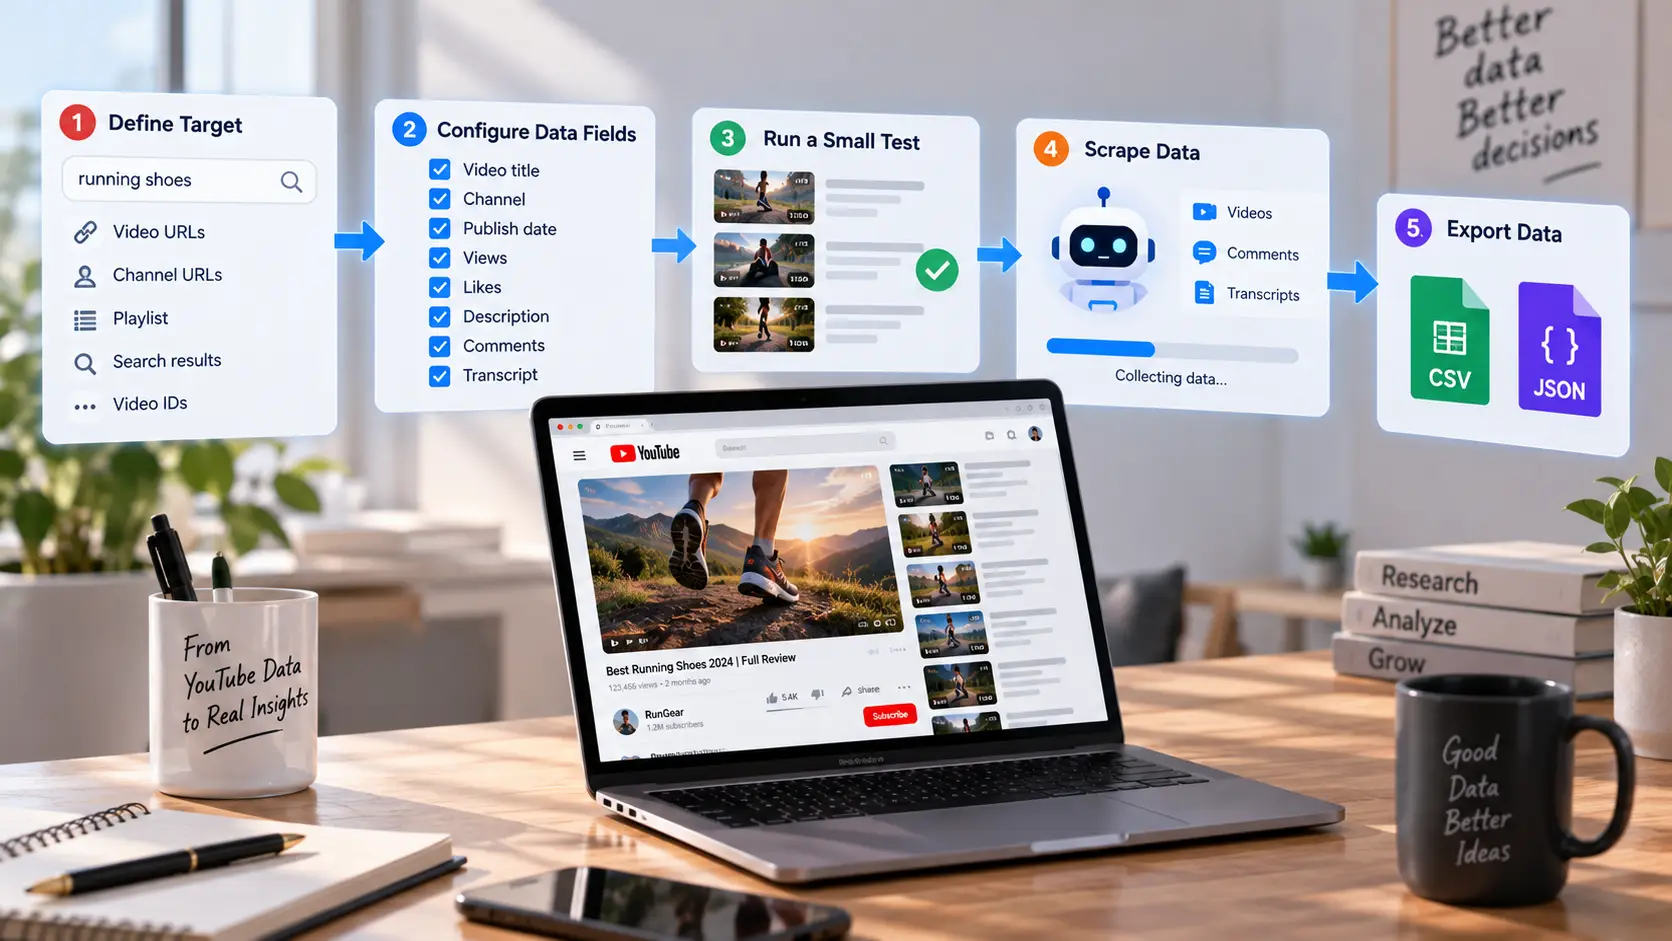
Configura y configura tu scraper de YouTube
El primer paso es definir el objetivo. Imagina que quieres investigar vídeos de YouTube sobre zapatillas de correr publicados en los últimos seis meses. Puedes empezar con 100 URLs de vídeo, varias URLs de canales o una lista de IDs de vídeo recopilados de los resultados de búsqueda.
Después, decide qué información es realmente necesaria. Si el objetivo es la investigación de contenido, el título del vídeo, el canal, la fecha de publicación, las visualizaciones, los likes, la descripción y la URL pueden ser suficientes. Si el objetivo es la investigación de clientes, también puede que necesites comentarios, conteos de respuestas o texto de transcripción.
Haz una pequeña prueba antes de recopilar todo. Diez vídeos suelen ser suficientes para ver si los campos son correctos y si falta algún dato. Abre algunas páginas originales de YouTube y compara la información visible con los registros extraídos antes de confiar en el conjunto de datos más grande.
Este paso puede parecer lento, pero evita problemas mayores más adelante. Si el formato de fecha de tu fecha es incorrecto en diez registros, es fácil de solucionar. Si el mismo problema aparece tras recopilar 200.000 registros, la limpieza se vuelve mucho más costosa.
Extraer vídeos, comentarios y transcripciones de YouTube
Los metadatos de vídeo suelen ser el tipo de dato de YouTube más fácil de recopilar. El método oficial videos.list puede devolver información soportada a través de campos como snippet, statistics, y contentDetails. Esto lo hace útil para proyectos que comparan títulos de vídeos, fechas, números de interacción y otros atributos públicos.
Los comentarios necesitan más planificación porque los vídeos populares pueden tener miles de respuestas. El endpoint oficial commentThreads.list soporta paginación, y las secciones de comentarios más grandes pueden requerir múltiples solicitudes. Si necesitas respuestas individuales, el comments.list endpoint también puede usarse para registros de comentarios soportados.
Un scraper de comentarios de YouTube puede facilitar este flujo de trabajo cuando el objetivo es la investigación en lugar del desarrollo de APIs. Por ejemplo, una agencia de marketing podría recopilar comentarios de vídeos de reseñas de productos y luego agruparlos por preguntas comunes, reacciones positivas y comentarios negativos. El análisis puede revelar por qué a los espectadores les gusta un producto y rechazan otro.
Las transcripciones normalmente deben tratarse como una tarea separada. Un extractor de transcripciones de YouTube puede ayudar a convertir los pies de foto disponibles en texto estructurado para investigación de palabras clave, análisis temático o investigación interna. Sin embargo, los usuarios deben comprobar tanto la disponibilidad de transcripciones como el uso permitido antes de almacenar o reutilizar grandes cantidades de contenido protegido por derechos de autor.
Exportar datos de YouTube a CSV o JSON
Una vez que extrayes datos de YouTube, el formato de salida debería coincidir con lo que ocurre a continuación. CSV funciona bien cuando los datos están planos y se abren en Excel, Google Sheets u otra herramienta de hojas de cálculo. Es fácil ordenar los vídeos por fecha, visualizaciones, canal o interacción y compartir el archivo con miembros del equipo no técnicos.
JSON suele ser mejor para los desarrolladores. Puede mantener información anidada, lo cual es útil cuando un vídeo contiene varios campos relacionados o un comentario tiene respuestas. JSON también encaja de forma natural en APIs, bases de datos y procesos automáticos.
Los identificadores estables son importantes en ambos formatos. Un título puede cambiar, y dos vídeos pueden tener el mismo título, pero un ID de vídeo te da una clave más fiable. La misma idea se aplica a los IDs de canal y de comentarios cuando están disponibles.
También es útil guardar la fecha o la marca de tiempo de la colección. Un vídeo puede tener 25.000 visualizaciones hoy y 80.000 el mes siguiente, por lo que el número tiene poco valor sin saber cuándo se recopiló. Una buena extracción de datos en YouTube conserva tanto el valor como su contexto.
Problemas y riesgos comunes de los raspadores de YouTube
Incluso un scraper potente de YouTube puede devolver resultados incompletos o dejar de funcionar. A veces el scraper está roto, pero otras veces los datos fuente han cambiado o desaparecido. Entender la diferencia hace que la resolución de problemas sea mucho más rápida.
La fiabilidad no consiste solo en mantener un script en funcionamiento. También necesitas saber si los datos están completos, actualizados y recogidos bajo las normas que se aplican a la plataforma y a tu proyecto. Esto es especialmente importante cuando los resultados se usan para decisiones empresariales.
Por qué los raspadores de YouTube dejan de funcionar
Las herramientas de scraping basadas en páginas de YouTube dependen de la estructura de las páginas de YouTube y de las peticiones internas. Si YouTube cambia cómo se carga un valor, un scraper puede dejar de encontrar el mismo campo. Esto puede ocurrir incluso cuando la URL y la página visible parecen casi idénticas.
Las bibliotecas no oficiales se enfrentan a un problema similar. El youtube-transcript-api proyecto indica claramente que depende de una interfaz no documentada utilizada por el cliente web de YouTube. Si YouTube cambia esa interfaz, la herramienta puede dejar de funcionar temporalmente hasta que el proyecto se actualice.
Los cambios técnicos también pueden afectar a las herramientas de extracción de vídeo. El proyecto yt-dlp documenta actualmente una aplicación más amplia de los PO Tokens para algunas solicitudes de YouTube y advierte que algunas funciones pueden no estar disponibles sin el token requerido. Esto demuestra por qué las herramientas de scraping necesitan actualizaciones regulares en lugar de tratarse como scripts permanentes.
No todos los resultados que faltan son un fallo técnico. Un vídeo puede haberse vuelto privado, los comentarios pueden estar deshabilitados o los subtítulos pueden no existir. Antes de cambiar tu código, comprueba si la fuente original sigue proporcionando la información que esperabas.
Cómo mejorar la precisión y estabilidad del raspado
La forma más sencilla de mejorar la precisión es validar manualmente una muestra pequeña. Compara varios registros extraídos con las páginas originales de YouTube o las respuestas oficiales de la API. Si los números o el texto no coinciden, encuentra la razón antes de aumentar el tamaño del trabajo.
Conserva la salida en bruto así como la versión limpia. El procesamiento de datos puede introducir errores propios, especialmente cuando los scripts cambian fechas, eliminan duplicados, traducen texto o combinan varios campos. Guardar la respuesta original te da algo a lo que volver cuando un paso posterior produzca resultados inesperados.
Los trabajos grandes también deberían registrar objetivos fallidos en lugar de ignorarlos en silencio. Si envías 10.000 identificadores de vídeo y recibes 9.600 registros, los 400 que faltan deberían almacenarse en un registro de fallos. De lo contrario, tu conjunto de datos final puede parecer completo aunque falte un grupo importante de vídeos.
Para proyectos recurrentes, separa la recogida del análisis. Primero recoge y guarda los datos fuente, luego ejecuta limpieza, clasificación, análisis de sentimiento o informes como segundo paso. Esto facilita mucho identificar si un problema proviene del YouTube Scraper o de tu propio código de procesamiento.
Límites y cumplimiento de extracción en YouTube
El scraping de YouTube tiene límites técnicos, pero también límites de política. Las Políticas de Desarrollo de la API de YouTube establecen que los clientes API no deben extraer directa o indirectamente aplicaciones de YouTube ni obtener datos extraídos de YouTube. Los desarrolladores que usen la API oficial también deben seguir los Términos de la API, las normas de privacidad, los requisitos de seguridad y las políticas de manejo de datos.
La privacidad merece especial atención cuando se trata de comentarios o información de usuarios. La guía para desarrolladores de YouTube dice que los clientes de la API no deben recopilar ni almacenar información identificativa del usuario sin consentimiento y deben respetar la privacidad del usuario. Recopilar solo los campos realmente necesarios puede reducir tanto el riesgo como el almacenamiento de datos innecesario.
Por ejemplo, un estudio de sentimiento puede requerir solo texto de comentario, fecha e información de interacción. Puede que no necesite almacenar el nombre de usuario de una persona durante meses. Preguntar si cada campo es realmente necesario es una forma sencilla de construir un flujo de trabajo de investigación más limpio.
Las transcripciones requieren un cuidado similar. Los subtítulos visibles públicamente siguen siendo contenido, y recopilar texto para análisis interno de temas es diferente a copiar transcripciones completas y republicarlas en otro lugar. Un flujo de trabajo fiable en YouTube Scraper debe considerar la precisión técnica, las normas de la plataforma, la privacidad y los derechos de autor conjuntamente.
Mejora el scraping en YouTube con DICloak
Para algunos equipos, recopilar los datos es solo una parte del problema. También pueden necesitar gestionar diferentes sesiones de navegador, configuraciones de proxy, proyectos cliente y scripts de automatización sin mezclarlo todo. En estos casos, la organización del navegador puede ser tan importante como el propio scraper.
DICloak puede actuar como una capa de gestión de navegadores para flujos de trabajo de datos aprobados. Su principal valor aquí no es reemplazar la API de datos de YouTube ni cambiar las normas de YouTube. Proporciona perfiles de navegador, configuración de proxy y herramientas de API local que pueden ayudar a mantener organizados diferentes proyectos basados en navegador.
Si el aislamiento de navegadores forma parte de tu configuración de investigación, esta guía para un navegador antidetect para web scraping explica cómo los perfiles de navegador separados pueden encajar en flujos de trabajo de datos más amplios. La misma idea puede ser útil cuando varios proyectos o miembros del equipo necesitan sus propios ajustes y sesiones.
Tareas de extracción separadas con perfiles de navegador
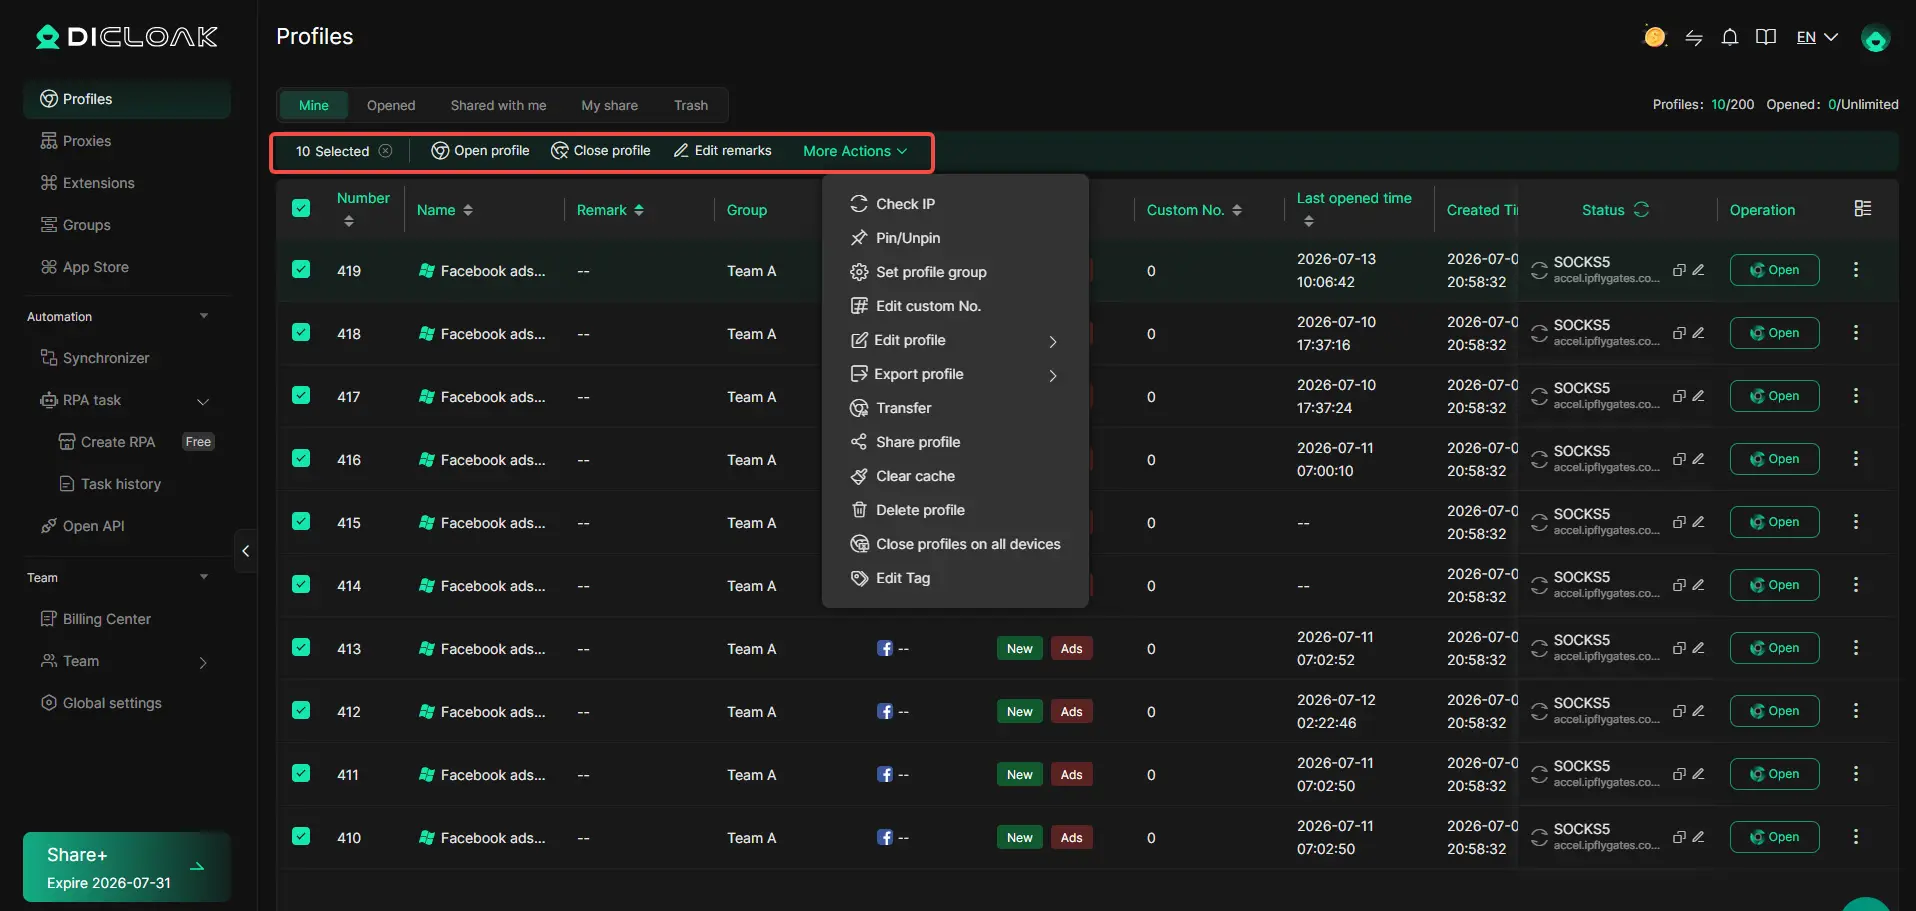
DICloak utiliza perfiles de navegador separados para mantener organizados los datos y configuraciones del navegador. Su API local puede listar perfiles de navegador y filtrarlos por información como grupo, tipo de proxy, host proxy, IP de salida, estado y plataforma. Esto ofrece a los equipos una forma más clara de separar un proyecto de investigación de otro.
Por ejemplo, un equipo de investigación podría usar un Perfil de Navegador para un proyecto de análisis de la competencia y otro para probar una herramienta de datos basada en navegador. Se podría asignar un Perfil separado a un proyecto cliente para que cookies, sesiones y ajustes de navegador no se mezclen con trabajos no relacionados.
Este enfoque también es útil cuando más de una persona trabaja en el mismo proceso de investigación. En lugar de abrir todas las tareas dentro de un navegador normal, cada proyecto puede tener su propio Perfil y configuración etiquetados. El beneficio es una organización más limpia, no una recopilación de datos más agresiva.
Configurar proxies para el scraping en YouTube
DICloak soporta diferentes modos de proxy a nivel de Perfil de Navegador. Su documentación actual incluye No Proxy, Proxy Personalizado, Proxies Guardados y extracción de API, mientras que la API Local admite tipos de proxy como HTTP, HTTPS y SOCKS5.
Esto puede ayudar a los equipos a mantener la configuración de red vinculada al proyecto correcto. Por ejemplo, una tarea de investigación basada en navegador puede usar una conexión de red de la empresa, mientras que otro proyecto regional aprobado usa una configuración proxy específica. Mantener esas configuraciones dentro de perfiles separados facilita evitar cambios accidentales en la configuración.
Para los usuarios que necesiten más contexto, el contenido de DICloak sobre flujos de trabajo de proxy y web scraping abarca temas relacionados con proxys, como el scraping de infraestructura y el rendimiento de la red. Un proxy debe seguir siendo tratado como una herramienta de red y no como una forma de ignorar los límites de la plataforma.
La misma regla se aplica a un Scraper de YouTube. Cambiar la ruta de red no cambia las políticas de YouTube, las normas de derechos de autor ni las obligaciones de privacidad. El objetivo debe ser una infraestructura estable y organizada para tareas permitidas.

Integrar DICloak con Python y APIs
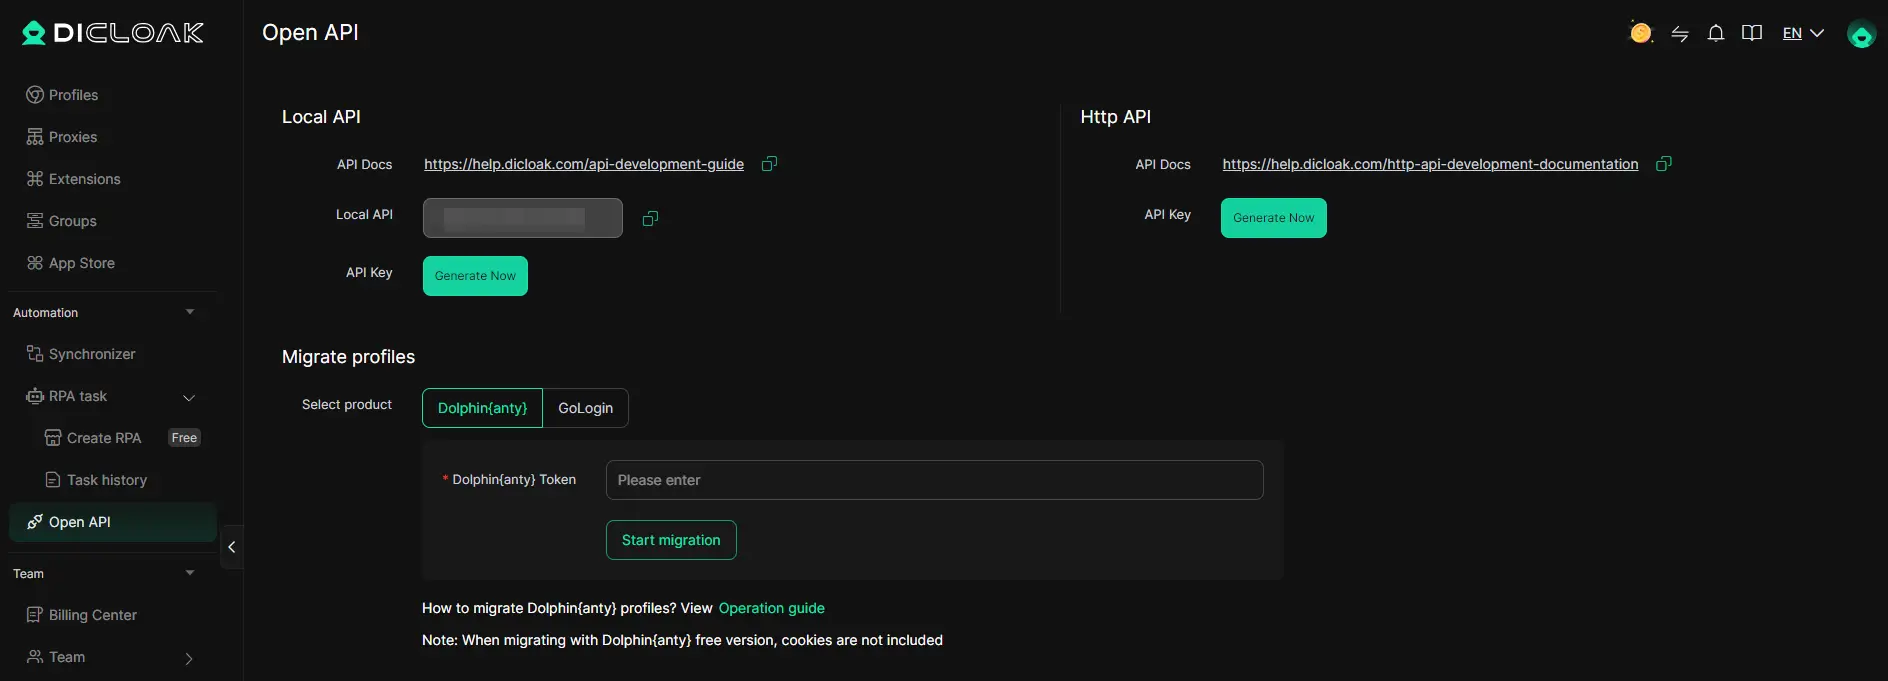
Los equipos técnicos pueden conectar DICloak a su propia automatización a través de la API Local Open. La guía de desarrollo actual incluye ejemplos para Python con Playwright y ChromeDriver, Node.js con Puppeteer y Java con ChromeDriver. También documenta acciones como listar perfiles de navegador, abrirlos, conectar herramientas de automatización, interactuar con ventanas del navegador y cerrar sesiones.
Esto puede encajar en un flujo de trabajo más amplio en Python cuando se requiere interacción con el navegador. Un script podría solicitar un Perfil de Navegador específico a través de la API Local, abrir ese Perfil, conectar a Playwright, completar una tarea aprobada del navegador, guardar el resultado y cerrar el Perfil. La parte de procesamiento de datos puede continuar en Python sin mezclar la lógica de gestión del navegador en cada paso.
La API de Perfiles del Navegador y la interfaz proxy de DICloak también permiten leer Perfiles y configuración de red de forma programática. Esto puede ayudar a que los equipos más grandes mantengan la coherencia de nombres, agrupamientos, asignación de proxy y reglas de automatización en muchos proyectos.
La configuración más fiable suele ser una de capas. Utiliza la API oficial de datos de YouTube cuando ya te proporcione la información que necesitas, elige una API adecuada para scrapers de YouTube u otra herramienta permitida cuando el proyecto requiera un flujo de trabajo diferente, y usa los Perfiles de Navegador solo cuando el trabajo basado en navegador realmente los requiera. Esto facilita la prueba del proceso, el mantenimiento y la comprensión del equipo es mucho más sencilla.
Preguntas frecuentes sobre YouTube Scraper
P1: ¿Qué es un raspador de YouTube?
Un YouTube Scraper es una herramienta o script que recopila datos públicos de YouTube, como títulos de vídeos, descripciones, visualizaciones, comentarios, información de canales, fechas de publicación y transcripciones disponibles. Los datos pueden guardarse en formatos como CSV o JSON para investigación, análisis o reportaje.
P2: ¿Qué datos puede recopilar un Scraper de YouTube?
Un YouTube Scraper puede recopilar diferentes tipos de datos según la herramienta. Ejemplos comunes incluyen metadatos de vídeo, información de canales, comentarios, conteos de respuestas, resultados de búsqueda, listas de reproducción, datos de interacción y transcripciones. Algunas herramientas de extracción de YouTube también permiten a los usuarios seleccionar solo los campos que necesitan.
P3: ¿Un YouTube Scraper es lo mismo que la API de datos de YouTube?
No. Un YouTube Scraper puede recopilar información de páginas web, automatización de navegadores o servicios de scraping de terceros, mientras que la API de datos de YouTube proporciona acceso oficial y documentado a los datos soportados de YouTube. Si la información que necesitas está disponible a través de la API oficial, normalmente merece la pena comprobar esa opción primero.
P4: ¿Puede un Scraper de YouTube recopilar comentarios y transcripciones?
Sí, algunas herramientas de YouTube Scraper pueden recopilar comentarios, respuestas y transcripciones disponibles. Un scraper de comentarios de YouTube puede ayudar con la investigación de audiencia o de sentimientos, mientras que un scraper de transcripciones de YouTube puede convertir los pies de foto disponibles en texto estructurado. Sin embargo, los comentarios pueden estar deshabilitados y algunos vídeos pueden no tener transcripciones.
P5: ¿Cómo elijo el mejor raspador de YouTube en 2026?
Elige un YouTube Scraper según los datos que necesites, el número de vídeos que planeas procesar, tus habilidades técnicas y el formato de salida que prefieras. Las herramientas sin código son más sencillas para principiantes, las APIs de scraper funcionan bien para flujos de trabajo automatizados y las herramientas de Python ofrecen más control. También deberías considerar la precisión de los datos, el mantenimiento, las reglas de YouTube y si la herramienta puede exportar datos a CSV, JSON o tu base de datos.
 Herramientas gratuitas
 Complemento de cookies
 Generador UA
 Generador de direcciones MAC
 Generador de IP
 Lista de direcciones IP
 Generador de código 2FA
 Reloj Mundial
 Cheque Anónimo
 WebRTC Leak Test
 Generador UUID
 Verificador de Proxy
 Verificador de anuncios de Facebook
 Raspado web con IA
 Herramientas SMM Gratis
 Verificador de Sombreado de Twitter
 Generador UTM
 Generador de usernames
 Generador de hashtags con IA
 Generador de titulares para LinkedIn
 Redimensionador de imágenes sociales